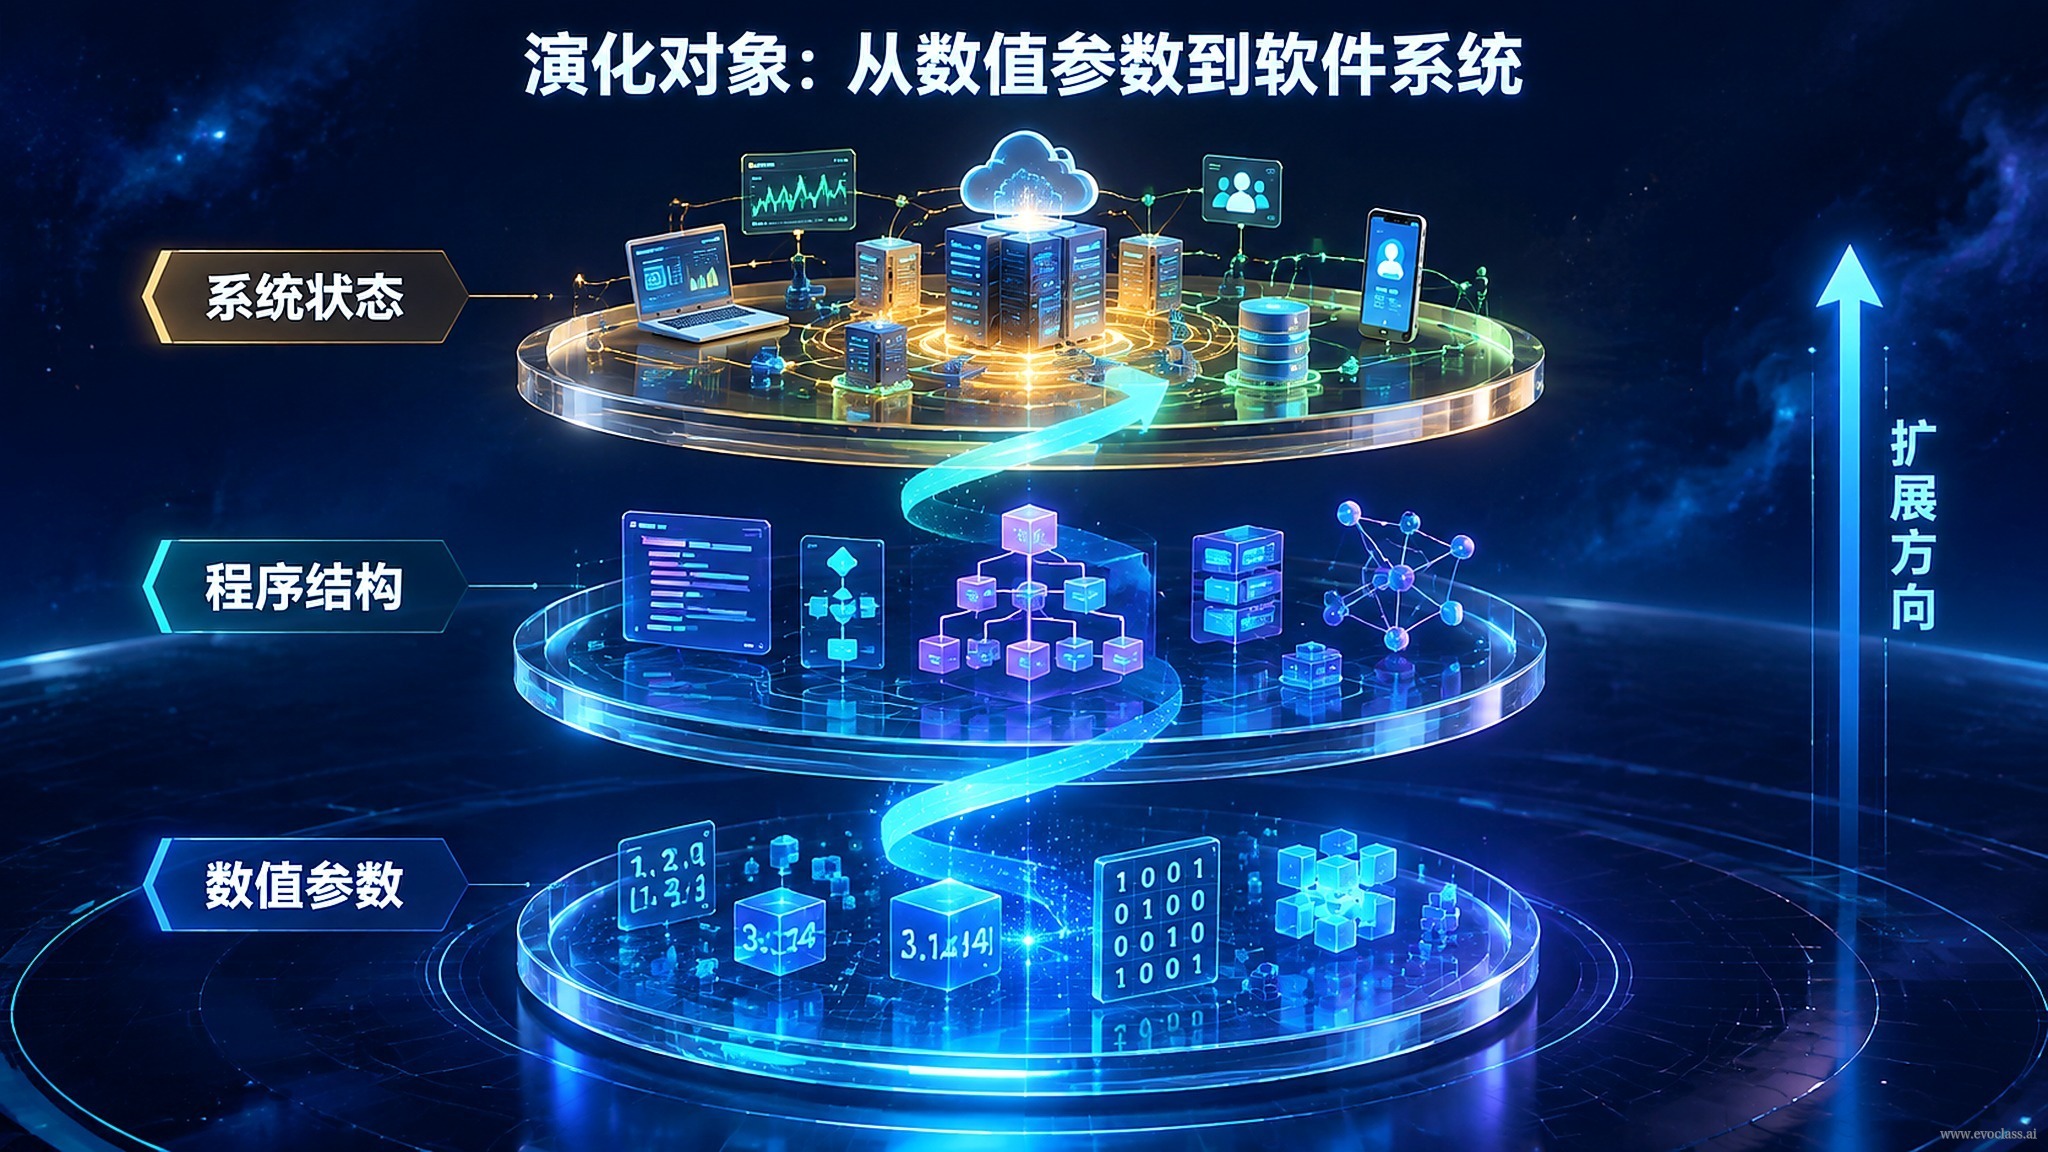
En las primeras prácticas de la computación evolutiva, los objetos que se «evolucionaban» eran casi siempreparámetros numéricos—tasa de aprendizaje, tamaño de lote, intensidad de regularización, método de inicialización de pesos. El espacio de búsqueda era un conjunto de números y la evaluación, un entrenamiento más una validación. Con el aumento de la capacidad de cómputo y la madurez de los grandes modelos, los objetos evolucionables se ampliaron notablemente: programas, estructuras de modelos, mecanismos algorítmicos e incluso todo un bloque deestado de ingeniería de software(configuración, versiones de dependencias, contratos de interfaz, estrategias de despliegue y ejecución).
Esta ruta de expansión puede representarse con una clara cadena de flechas: parámetros numéricos → programas y estructuras de modelos → estado de ingeniería de software y candidatos a nivel de sistema. Cuanto más a la derecha está el nivel, mayor es su capacidad expresiva y más tipos de cambios cubre, lo que hace posible la evolución a nivel de sistema.
Tres niveles de objetos de evolución, cada uno con costes distintos
- Nivel de parámetros numéricos: el candidato es un conjunto de números; generarlo es barato y evaluarlo es rápido, pero solo puede responder a «¿qué tan bien está ajustado?» y no puede añadir un mecanismo que faltaba desde el principio.
- Nivel de programas y estructuras de modelos: el candidato es una estructura de red, una combinación de operadores, un flujo de trabajo de prompts o un parche de código; los cambios modifican «qué puede hacer el sistema», no solo «con cuánta precisión lo hace».
- Nivel de estado de ingeniería de software: el candidato es la configuración, las versiones de dependencias, los contratos de interfaz y las estrategias de despliegue, y determina directamente si el sistema puede funcionar de forma estable y si puede reproducirse.
Cambio de enfoque: de «cómo generar candidatos» a «cómo ejecutar y evaluar»
Cuando los candidatos pasan de números a programas, el paso de «generar candidatos» deja de ser el cuello de botella: los grandes modelos pueden producir estructuras, mecanismos y parches en lote. Lo que realmente determina si la evolución es efectiva esel mecanismo de ejecución y evaluación—quién puede poner realmente en marcha los candidatos y quién puede juzgar, con un coste aceptable, si merecen conservarse.
Cuanto mayor es la capacidad expresiva, más pesada es la carga de evaluación. Un parámetro numérico se puntúa con un solo entrenamiento; un parche de código, en cambio, requiere aislamiento en sandbox, pruebas de regresión y comparación con una referencia para responder a tres preguntas: si es realmente efectivo, si implica riesgos y si sus resultados pueden reproducirse. El sandbox, las pruebas de regresión y las referencias son precisamente los dispositivos de ingeniería que acotan el coste, el riesgo y la reproducibilidad, y permiten conservar o descartar los cambios de forma estable.
Compromisos de ingeniería: más candidatos no significa mejor evolución
En la práctica de los equipos, el camino habitual es ajustar primero la tasa de aprendizaje y los hiperparámetros, y luego ampliar gradualmente la búsqueda a estructuras de red, combinaciones de operadores, flujos de trabajo de prompts o parches de código. Cada vez que se añade un nivel, hay que responder a la vez: ¿cuánta capacidad de cómputo y tiempo costará la evaluación? ¿Los candidatos fallidos contaminarán el sistema actual? ¿Se podrán reproducir los mismos resultados la próxima vez? Solo cuando se logra un equilibrio entre capacidad expresiva, coste de evaluación, reproducibilidad y seguridad, la evolución a nivel de sistema es realmente viable.
La expansión en tres niveles del objeto de evoluciónEn la figura, la cadena de flechas va de los parámetros numéricos a los programas y estructuras de modelos, y de ahí al estado de ingeniería de software y a los candidatos a nivel de sistema: cuanto más a la derecha, más objetos pueden modificarse y mayor es la capacidad expresiva. Pero el coste aumenta en la misma medida: los parámetros numéricos solo necesitan un entrenamiento para puntuarse, mientras que un parche de código requiere aislamiento en sandbox, pruebas de regresión y comparación con una referencia para determinar su efectividad, su riesgo y su reproducibilidad.