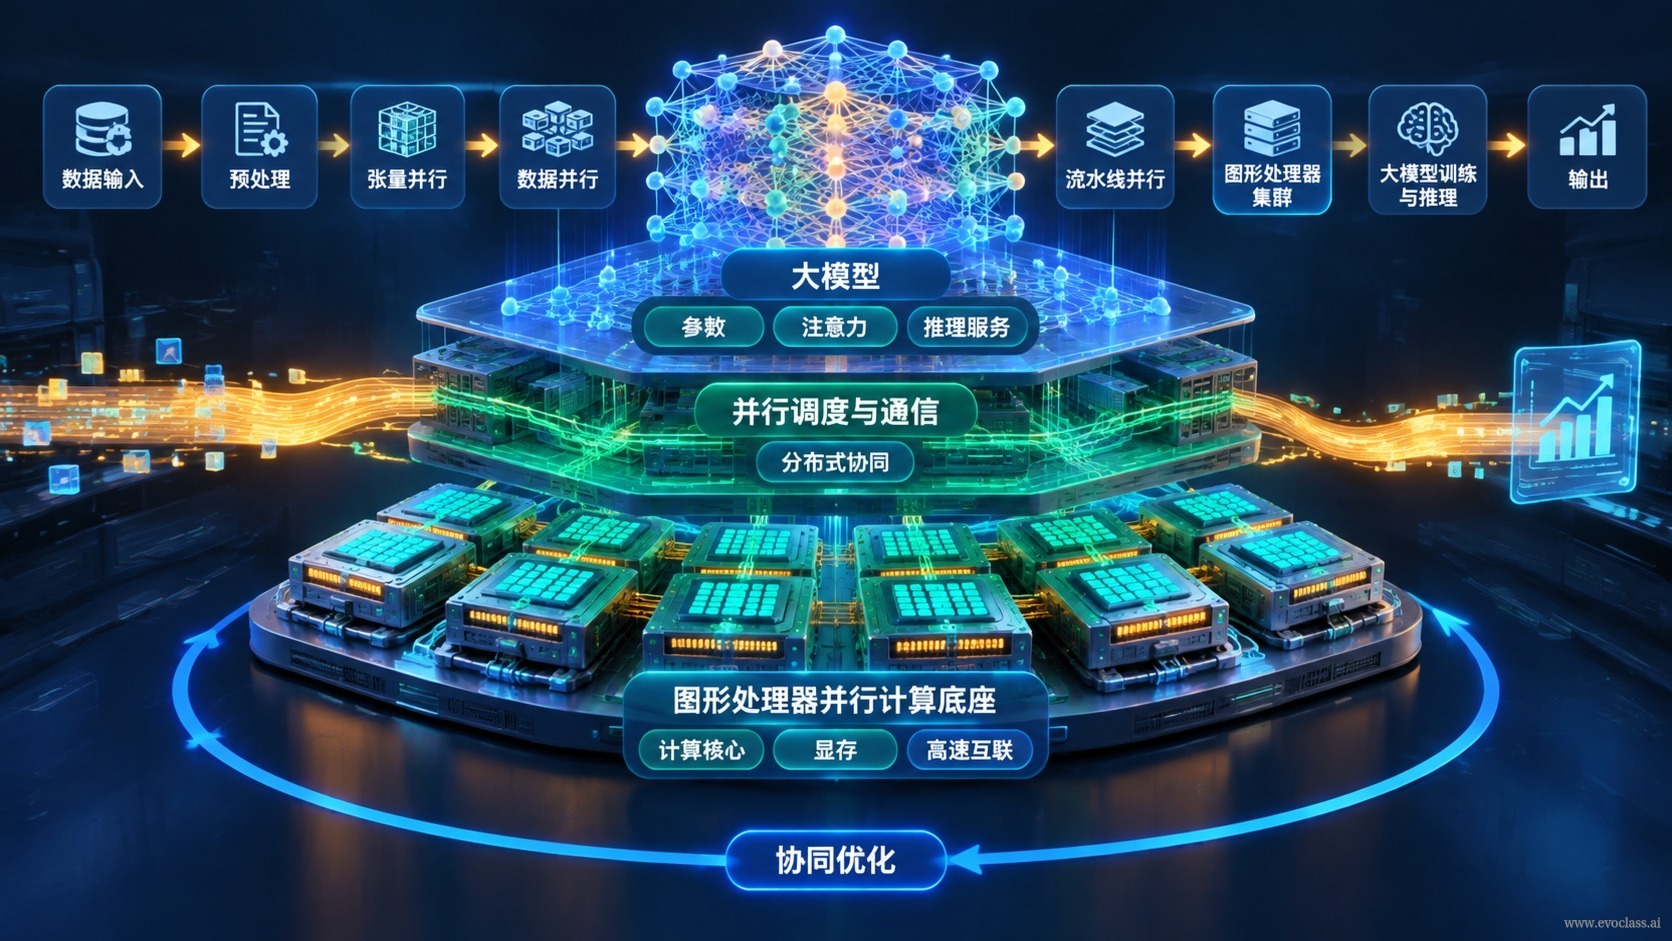
Esta página analiza labase de ingenieríaque permite a EvoX desplegar exploración evolutiva a gran escala:las GPU aportan una elevada capacidad de cómputo paralelo, y losgrandes modelos aportan la capacidad de comprender y generar lenguaje natural, código y contexto del proyecto. Al combinarse ambas, se abre la escala de cómputo, y el origen, la cantidad de soluciones candidatas y el alcance de exploración sobre el que pueden actuar cambian de raíz.
Qué abre la capacidad de cómputo: de lotes pequeños en serie a la exploración simultánea a gran escala
Cuando la capacidad de cómputo es limitada, evaluar una solución candidata suele implicar esperar en cola, y la búsqueda solo puede avanzar en lotes pequeños y de forma secuencial: «probar unas cuantas más» es un lujo. La capacidad paralela de la GPU lleva la evaluación y la búsqueda a realizarse simultáneamente a gran escala: la población o un gran lote de soluciones candidatas puede enviarse de una vez a evaluación paralela, y la retroalimentación regresa casi al mismo tiempo. Así, «probar muchas posibilidades a la vez» deja de ser un recurso especial y se convierte en una capacidad de ingeniería predeterminada.
- Rendimiento: la evaluación por lotes comprime el tiempo de espera de cada iteración hasta un rango aceptable, permitiendo que el ciclo evolutivo funcione a alta frecuencia en lugar de verse ralentizado por la fase de evaluación.
- Escala: aumenta el número de candidatos que pueden explorarse simultáneamente, y con ello se amplía el espacio de hipótesis que la búsqueda puede cubrir; el límite de exploración pasa de «unos pocos intentos» a «desplegar por lotes».
Qué ha cambiado en el origen de las soluciones candidatas
Una vez abierta la escala de cómputo, el origen de los candidatos pasa de «diseño manual + muestreo reducido» a un modo híbrido: elsuministro por lotes del cómputo paralelo y la generación y reescritura por grandes modelos producen candidatos conjuntamente. Los grandes modelos pueden comprender lenguaje natural, código y contexto del proyecto, y convertir más rápido la intención de investigación en candidatos ejecutables, scripts o borradores de operadores, manteniendo la conexión con el contexto del proyecto; el lado de la GPU se encarga de validar estos borradores por lotes y devolver los resultados al proceso de búsqueda. Uno delante y otro detrás, cubren justamente los dos extremos: la «generación» y la «verificación».
La base no sustituye al algoritmo evolutivo
Cabe aclarar que esta capa es unabasey no el algoritmo en sí. Se encarga delRendimiento, laentrada semántica y la conexión de contexto; la búsqueda, la selección y el bucle de retroalimentación siguen siendo responsabilidad del algoritmo evolutivo. Solo delimitando bien la división del trabajo se adquiere criterio en la práctica: cuando un sistema no funciona bien, hay que determinar primero si lo que falta es rendimiento de cómputo, entrada semántica o el propio mecanismo de bucle cerrado.
En la misma línea de ingeniería, la base también debe sustentar la colaboración multi-Agent y la descomposición recursiva de tareas como patrones de ingeniería: un objetivo complejo se divide en varias subtareas, que distintos Agent asumen y llevan adelante por separado. Para que estas subtareas no se desvinculen entre sí, se necesitapersistencia a nivel de proyecto: asentar los objetivos, las restricciones, los productos intermedios y los resultados de evaluación a nivel de proyecto, de modo que puedantrascender el contexto de cada Agent y perdurar. De lo contrario, cada vez que se cambia un Agent hay que realinear el contexto, y la descomposición recursiva degenera en llamadas puntuales inconexas.
Diagrama de arquitectura de la colaboración entre el paralelismo de GPU y los grandes modelosObserva el diagrama de arquitectura de la colaboración entre el paralelismo de GPU y los grandes modelos y reflexiona sobre qué relación tiene con «los grandes modelos pueden comprender lenguaje natural, código y contexto del proyecto».