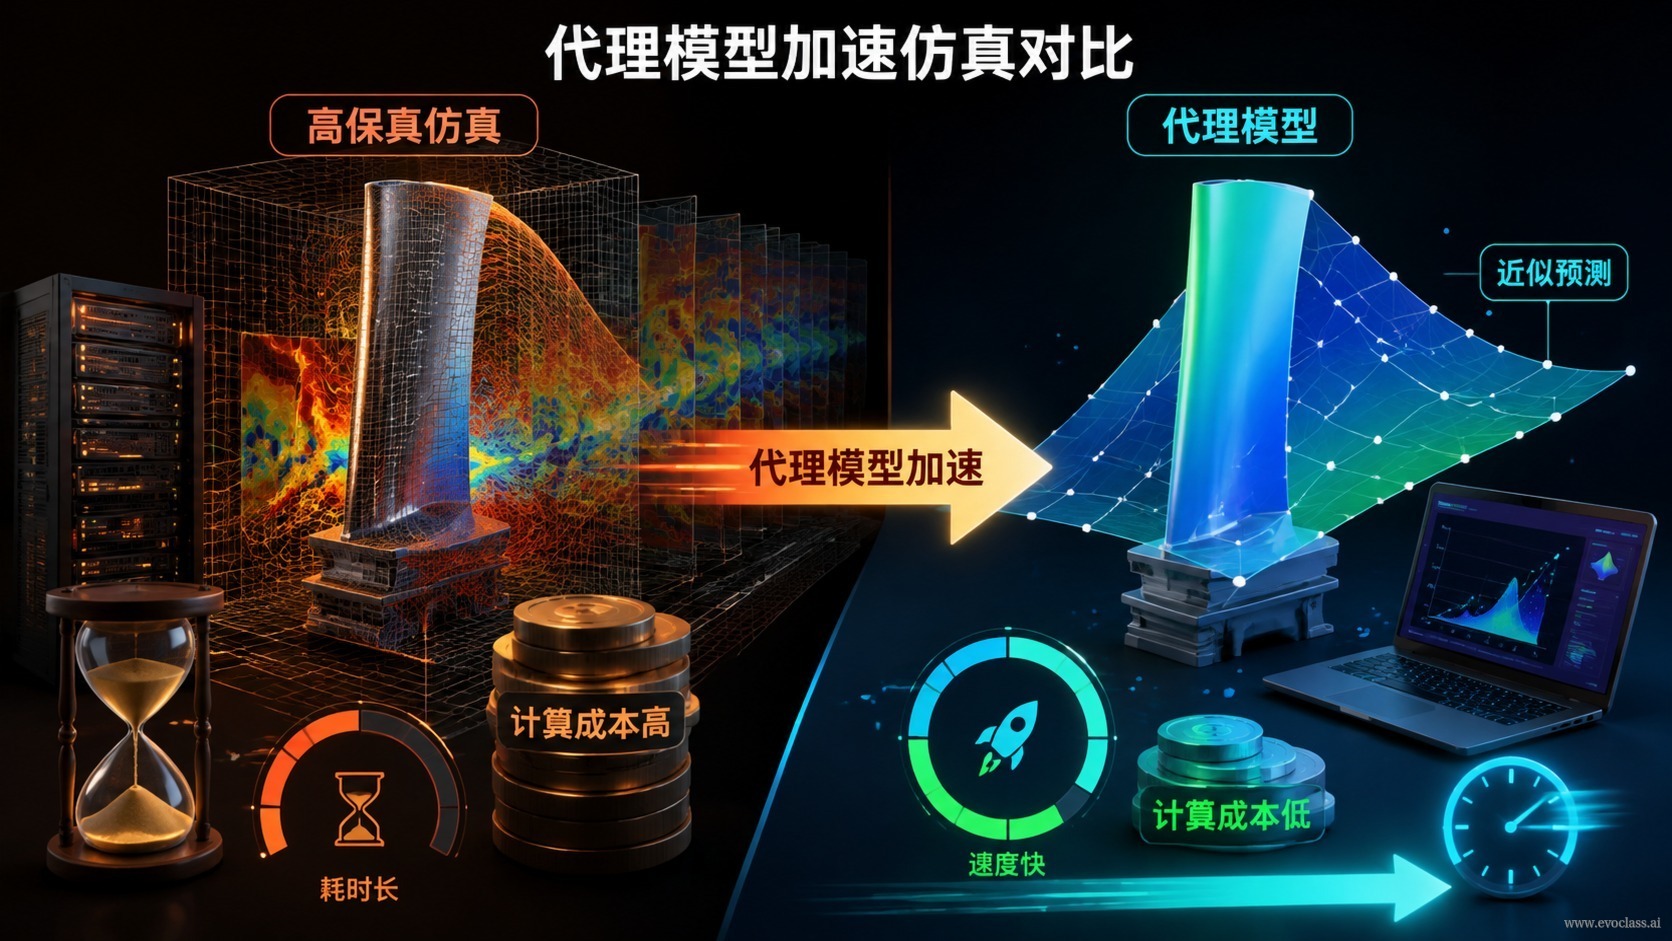
En el diseño de ingeniería complejo, como el de perfiles alares supercríticos,simulación de alta fidelidad(CFD, análisis por elementos finitos) suele requerir desde decenas de minutos hasta varias horas por evaluación. Si se integra este tipo de simulación directamente en el ciclo evolutivo, cada generación de la población debe evaluarse individuo por individuo, el presupuesto computacional se agota rápidamente en pocas decenas de generaciones y el espacio de búsqueda explorable se ve reducido.
Los modelos sustitutos(surrogate model, también conocidos como modelos aproximados o metamodelos) sustituyen total o parcialmente la simulación de alta fidelidad mediante cálculos aproximados de bajo costo: aprenden la relación entrada-salida a partir de muestras de simulación existentes y predicen rápidamente el rendimiento de las soluciones candidatas en la optimización evolutiva multiobjetivo, superando así el cuello de botella que supone el alto costo de las simulaciones de alta precisión.
Por qué no se puede insertar directamente la simulación de alta fidelidad en el ciclo evolutivo
- Origen del cuello de botella: en problemas como perfiles alares supercríticos o resistencia estructural, una sola simulación CFD / de elementos finitos consume mucho tiempo, mientras que el algoritmo evolutivo debe evaluar toda la población en cada generación, de modo que el número de evaluaciones y el presupuesto computacional se consumen de forma casi lineal.
- Consecuencia directa: el presupuesto se agota en unas pocas generaciones, el tamaño de la población y el número de iteraciones se ven obligados a reducirse, el frente multiobjetivo resulta difícil de explorar de forma suficiente y el verdadero espacio de diseño queda bloqueado por la imposibilidad de costear las evaluaciones.
Principios básicos del modelo sustituto
Con datos como perfiles base, muestras perturbadas y otrosdatos existentesse entrena una relación de mapeo «solución candidata → valores objetivo y cumplimiento de restricciones», y el modelo se convierte en unevaluador aproximado de bajo costo. En el ciclo evolutivo, las soluciones candidatas se puntúan primero por lotes con el modelo sustituto, y solo unas pocas con las puntuaciones más altas o con mayor incertidumbre se envían a verificación mediante simulación de alta fidelidad.
Las cuatro etapas de la ruta de aceleración
- Entrenamiento fuera de línea: entrenar el modelo sustituto con las muestras iniciales para establecer un mapeo preliminar de entrada-salida.
- Predicción por lotes en línea: en cada generación, predecir simultáneamente varios valores objetivo para todas las candidatas, sustituyendo la simulación de alta fidelidad punto por punto.
- Selección de puntos asistida por el modelo sustituto: combinar los valores predichos con la incertidumbre para seleccionar candidatas de alto potencial o alto contenido informativo.
- Corrección por retroalimentación: reincorporar unos pocos resultados de alta fidelidad a la base de muestras y actualizar el modelo sustituto de forma incremental, para que las predicciones posteriores se mantengan cerca de la superficie de respuesta real.
Compensación entre precisión y costo
Cuanto más complejo es el modelo sustituto (desde una regresión simple hasta un proceso gaussiano o una red profunda), normalmente más preciso es, pero también aumentan los costos de entrenamiento e inferencia. La restricción clave es queel modelo sustituto debe ser significativamente más rápido que la simulación de alta fidelidad, de lo contrario se convertirá en un nuevo cuello de botella; además, su precisión debe ser suficiente para sostener la presión selectiva, pues de lo contrario la evolución se desviará en direcciones erróneas.
Límites y riesgos
El modelo sustituto solo es fiable cerca de la distribución de entrenamiento. Cuando la búsqueda lleva las candidatas a regiones fuera de la distribución, las predicciones pueden arrojar valores aparentemente razonables pero muy alejados de la realidad, desviando la dirección de búsqueda. Las prácticas viables son: proporcionar estimaciones de incertidumbre, establecer un filtrado por umbral de confianza, forzar la verificación de alta fidelidad en las candidatas fuera de rango y comprobar periódicamente la calidad del modelo mediante estadísticas de error reales.
Comparación de la aceleración de simulaciones con modelos sustitutosLa figura compara el flujo de evaluación de la simulación de alta fidelidad y del modelo sustituto en la optimización evolutiva: el primero consume tiempo punto por punto y difícilmente sostiene la búsqueda de poblaciones grandes durante muchas generaciones; el segundo aprende de muestras existentes el mapeo de las soluciones candidatas a los valores objetivo y predice rápidamente por lotes. Solo las candidatas mejor posicionadas o con mayor incertidumbre se envían a verificación de alta fidelidad, y los resultados se reincorporan para actualizar el modelo sustituto, concentrando así el escaso presupuesto de simulación en las candidatas clave.