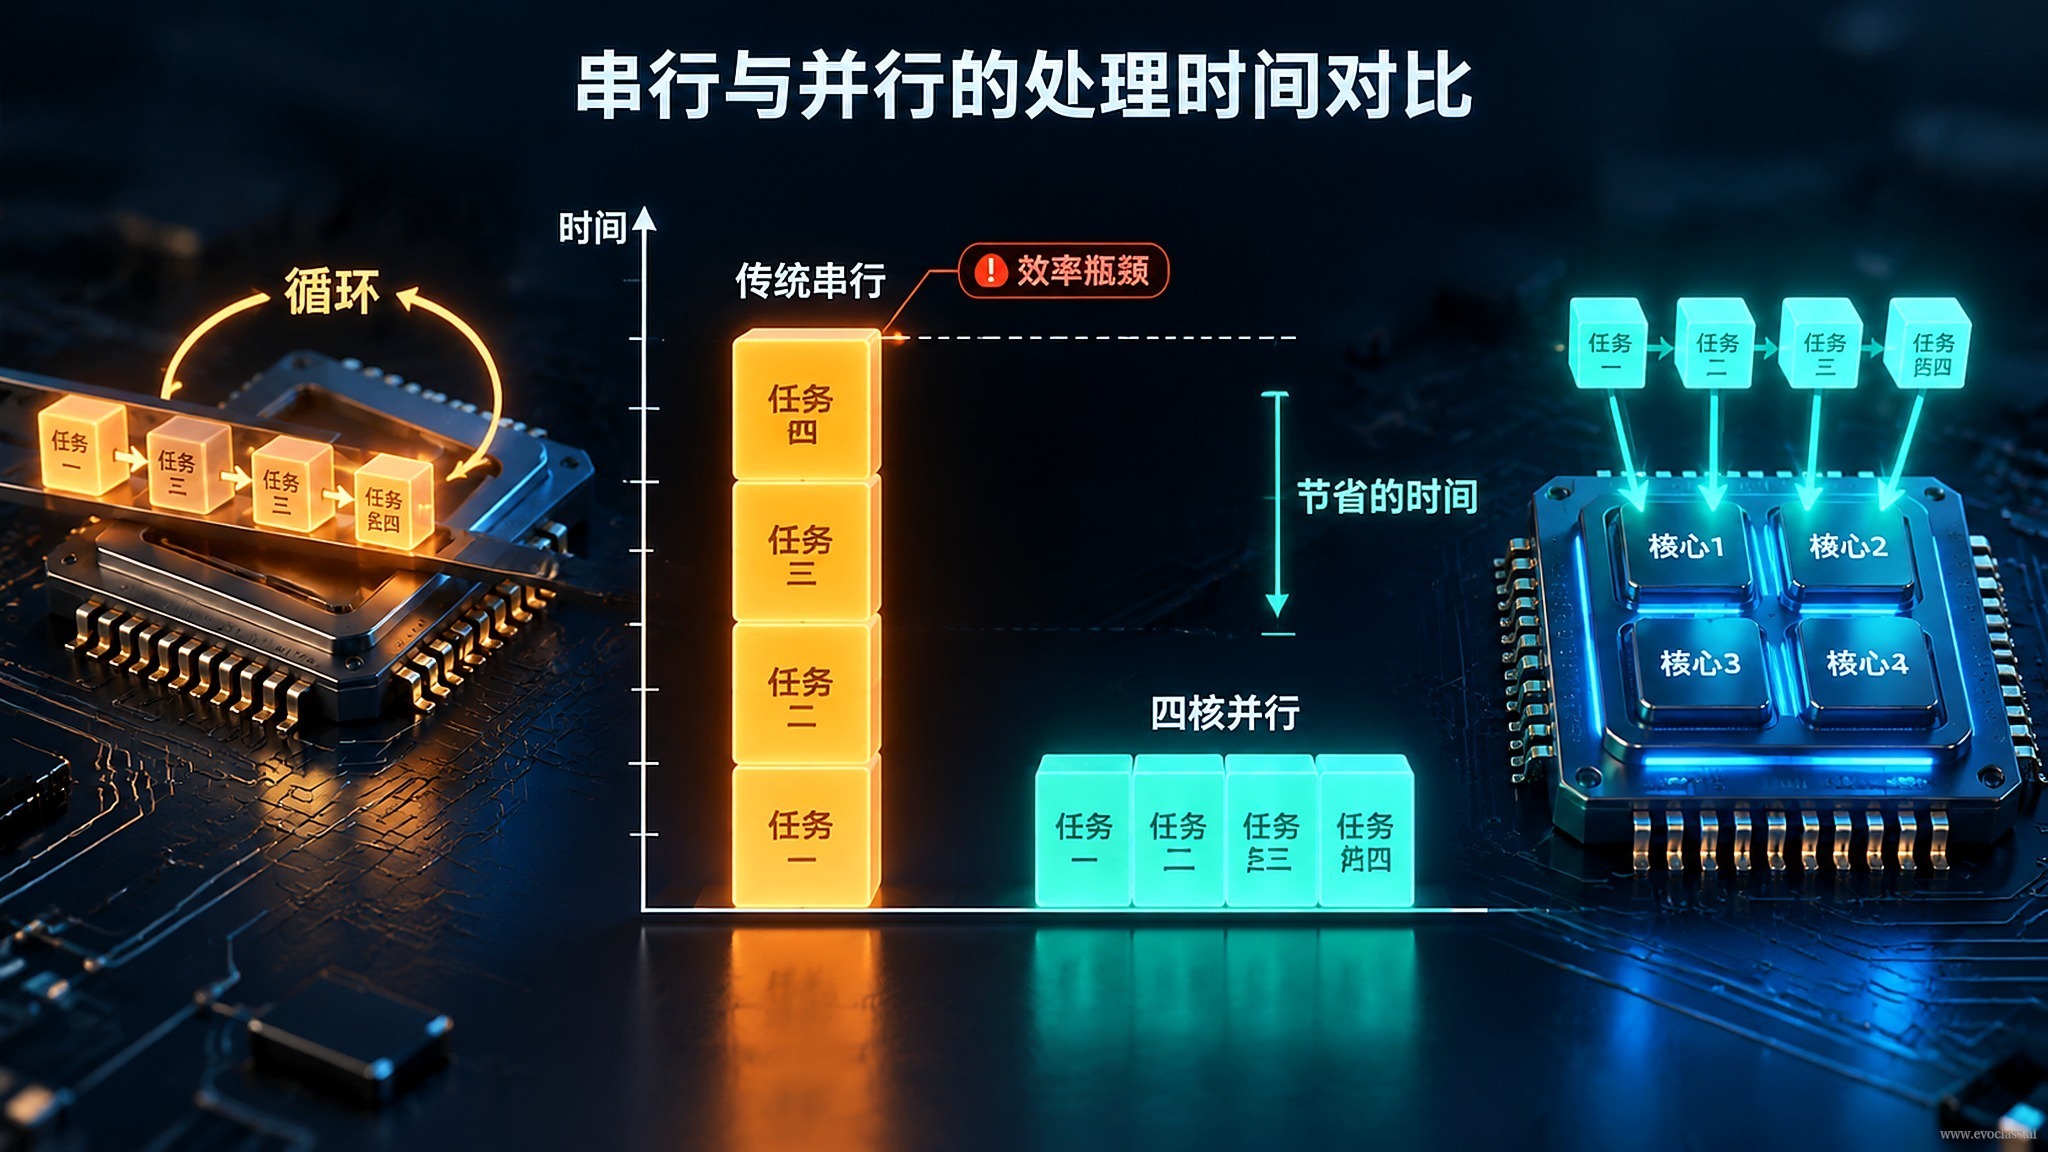
El proceso evolutivo depende de la diversidad de la población, y esta diversidad implica un crecimiento multiplicativo tanto del tamaño de la población como del número de evaluaciones. Cuando las evaluaciones candidatas alcanzan el orden de decenas de miles,el bucle secuencial tradicional de CPUse convierte en el tramo más estrecho de toda la cadena: procesa solo un individuo a la vez, dejando prácticamente inutilizada la capacidad de paralelismo del hardware.
De uno en uno: el modelo de ejecución del bucle secuencial
La implementación más básica consiste en tratar toda la población como una lista y extraer los individuos uno a uno mediante un bucle: tomar individuo → decodificar a parámetros concretos → llamar a la función de evaluación → escribir de vuelta la aptitud. Las iteraciones adyacentes apenas pueden solaparse: si el resultado de la evaluación no regresa, la escritura no puede avanzar; si la escritura no finaliza, el siguiente individuo no tiene dónde depositar su resultado. Así, las unidades paralelas como los núcleos múltiples, SIMD y la GPU permanecen inactivas la mayor parte del tiempo, viendo cómo un solo individuo recorre toda la cadena.
¿De dónde proviene realmente la sobrecarga?
- Número de evaluaciones con crecimiento lineal: el número total de evaluaciones es aproximadamente el tamaño de la población × el número de generaciones; cuando alcanza el orden de 10⁵, el tiempo de reloj secuencial crece de forma casi lineal.
- Ejecución uno a uno en la capa del intérprete: el bucle individuo por individuo, la verificación de límites y el despacho por tipos introducen una sobrecarga constante, fija pero elevada.
- Accesos a memoria no contiguos y transferencia de datos: los individuos tomados uno a uno suelen no ser contiguos en memoria, la tasa de aciertos de caché es baja y el costo de transferencia se paga repetidamente.
- Sincronización y planificación: para obtener el siguiente individuo, el flujo de ejecución debe detenerse y reanudarse repetidamente.
Convertir la escala en tiempo
Tomando como ejemplo una población de 1000 y 100 generaciones, hay en total unas 100 000 evaluaciones candidatas. Si cada evaluación promedia 1 ms, solo la fase de evaluación en serie ya requiere unos 100 segundos, sin contar aún el costo de los operadores ni el de planificación; si para mantener la diversidad se aumenta el número de reinicios de 1 a 5, el costo crece de forma casi lineal hasta unos 500 segundos. Si esa misma carga de trabajo se organiza por lotes y se delega al hardware paralelo, el tiempo de reloj lo determina principalmente el número de lotes, no el número de individuos.
Cuándo se reduce este cuello de botella
Las condiciones límite también importan: cuando cada evaluación es extremadamente barata (del orden de microsegundos) o la población es muy pequeña (por debajo del centenar), la sobrecarga de planificación y memoria puede superar a la de cálculo, la diferencia entre lo secuencial y lo paralelo se reduce notablemente, el beneficio marginal de la tensorización disminuye y el cuello de botella se traslada a la granularidad de planificación y al ancho de banda de memoria. Por tanto, si vale la pena reformar el modelo de ejecución debe evaluarse conjuntamente con el costo y la escala de las evaluaciones.
Comparación de tiempos entre lo secuencial y lo paraleloTomando como ejemplo una población de 1000 y 100 generaciones, hay en total unas 100 000 evaluaciones candidatas; con 1 milisegundo por evaluación, solo la fase de evaluación en serie requiere unos 100 segundos, y con 5 reinicios crece de forma casi lineal hasta unos 500 segundos. Al reorganizar por lotes y delegarlo al hardware paralelo, el tiempo de reloj lo determina principalmente el número de lotes, no el número de individuos.