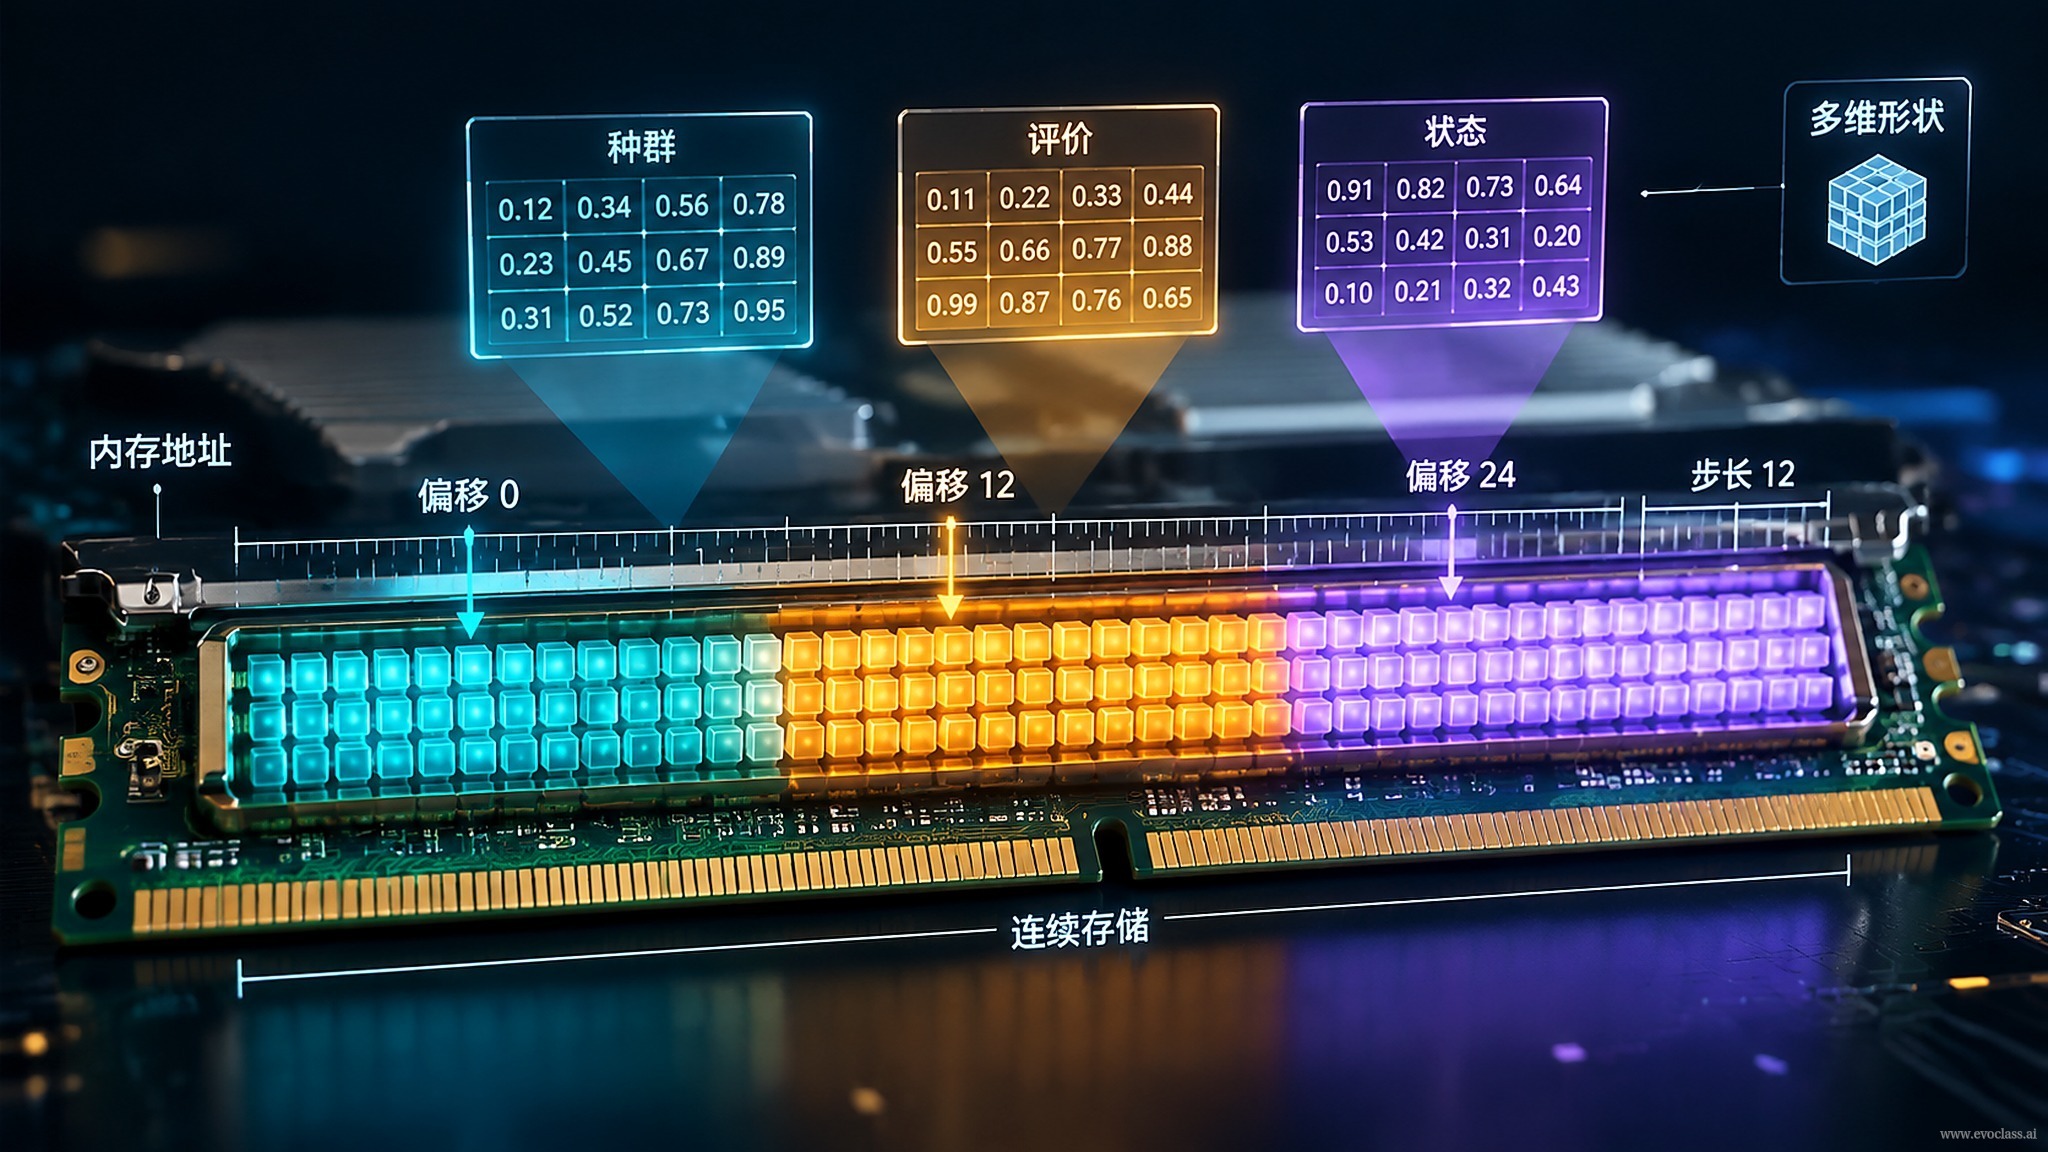
En la implementación ingenieril de algoritmos evolutivos,la organización tensorialmapea de forma unificada «qué es la población, cómo se evalúa y en qué paso va la ejecución» desde objetos y listas dispersos hacia tensores regulares. Su esencia es establecer un contrato de datos unificado para población, evaluación y estado, de modo que el cálculo por lotes, la residencia en dispositivo y la posterior programación paralela compartan una misma semántica de memoria.
Tensorización de la población: codificada como [N, D]
Organizar las N soluciones candidatas por dimensión de lote en un tensor de codificación de forma [N, D]. Las variables continuas, discretas o las codificaciones por segmentos pueden expresarse mediante tensores de campo o bloques agrupados, manteniendo un tipo de dato y una ubicación de dispositivo unificados.
- Lote por fuera: normalmente se coloca N en la capa más externa, de modo que el mismo operador se ejecute de forma vectorizada sobre todo el lote.
- Bloques de campos: si el individuo se compone de varios segmentos de parámetros, puede dividirse en [N, D1] + [N, D2] + … manteniendo un almacenamiento contiguo.
- Tratamiento de longitud variable: los individuos de longitud variable se tratan con relleno más máscara o con bucketing, para evitar que las estructuras heterogéneas rompan el cálculo por lotes.
Matricialización de los resultados de evaluación: [N, M] y [N, K]
Una única evaluación por lotes produce una matriz de aptitud [N, M]; los múltiples objetivos, múltiples restricciones e indicadores adicionales pueden yuxtaponerse como [N, M+K] o almacenarse en tablas separadas, evitando llamar a la función de evaluación en un bucle individuo por individuo.
Gestión unificada del estado como tensores
La generación, el estado del generador aleatorio, los hiperparámetros de la estrategia, la mejor solución, la caché histórica, el ranking o el estado de muestreo también entran en tensores o en un contenedor de estado estructurado, garantizando reproducibilidad, trazabilidad y actualización por lotes.
Beneficios y límites de la organización
Los tensores unificados reducen el tránsito entre host y dispositivo, disminuyen la sobrecarga de bucles y proporcionan una base de datos para el paralelismo posterior de operadores; sin embargo, es necesario gestionar la validez de las máscaras, el desperdicio por relleno, el crecimiento de la escala multiobjetivo y el coste de sincronización del estado.
Disposición tensorial de población, evaluación y estadoLa población se codifica como un tensor [N, D], una única evaluación por lotes produce la matriz de aptitud [N, M], y los múltiples objetivos o restricciones pueden extenderse a [N, M+K]; la generación, la mejor solución y el estado del generador aleatorio también residen de forma unificada en el dispositivo como tensores, de modo que la actualización de cada generación se completa íntegramente sobre la misma dimensión de lote, reduciendo el tránsito entre host y dispositivo y la sobrecarga del bucle individuo por individuo.