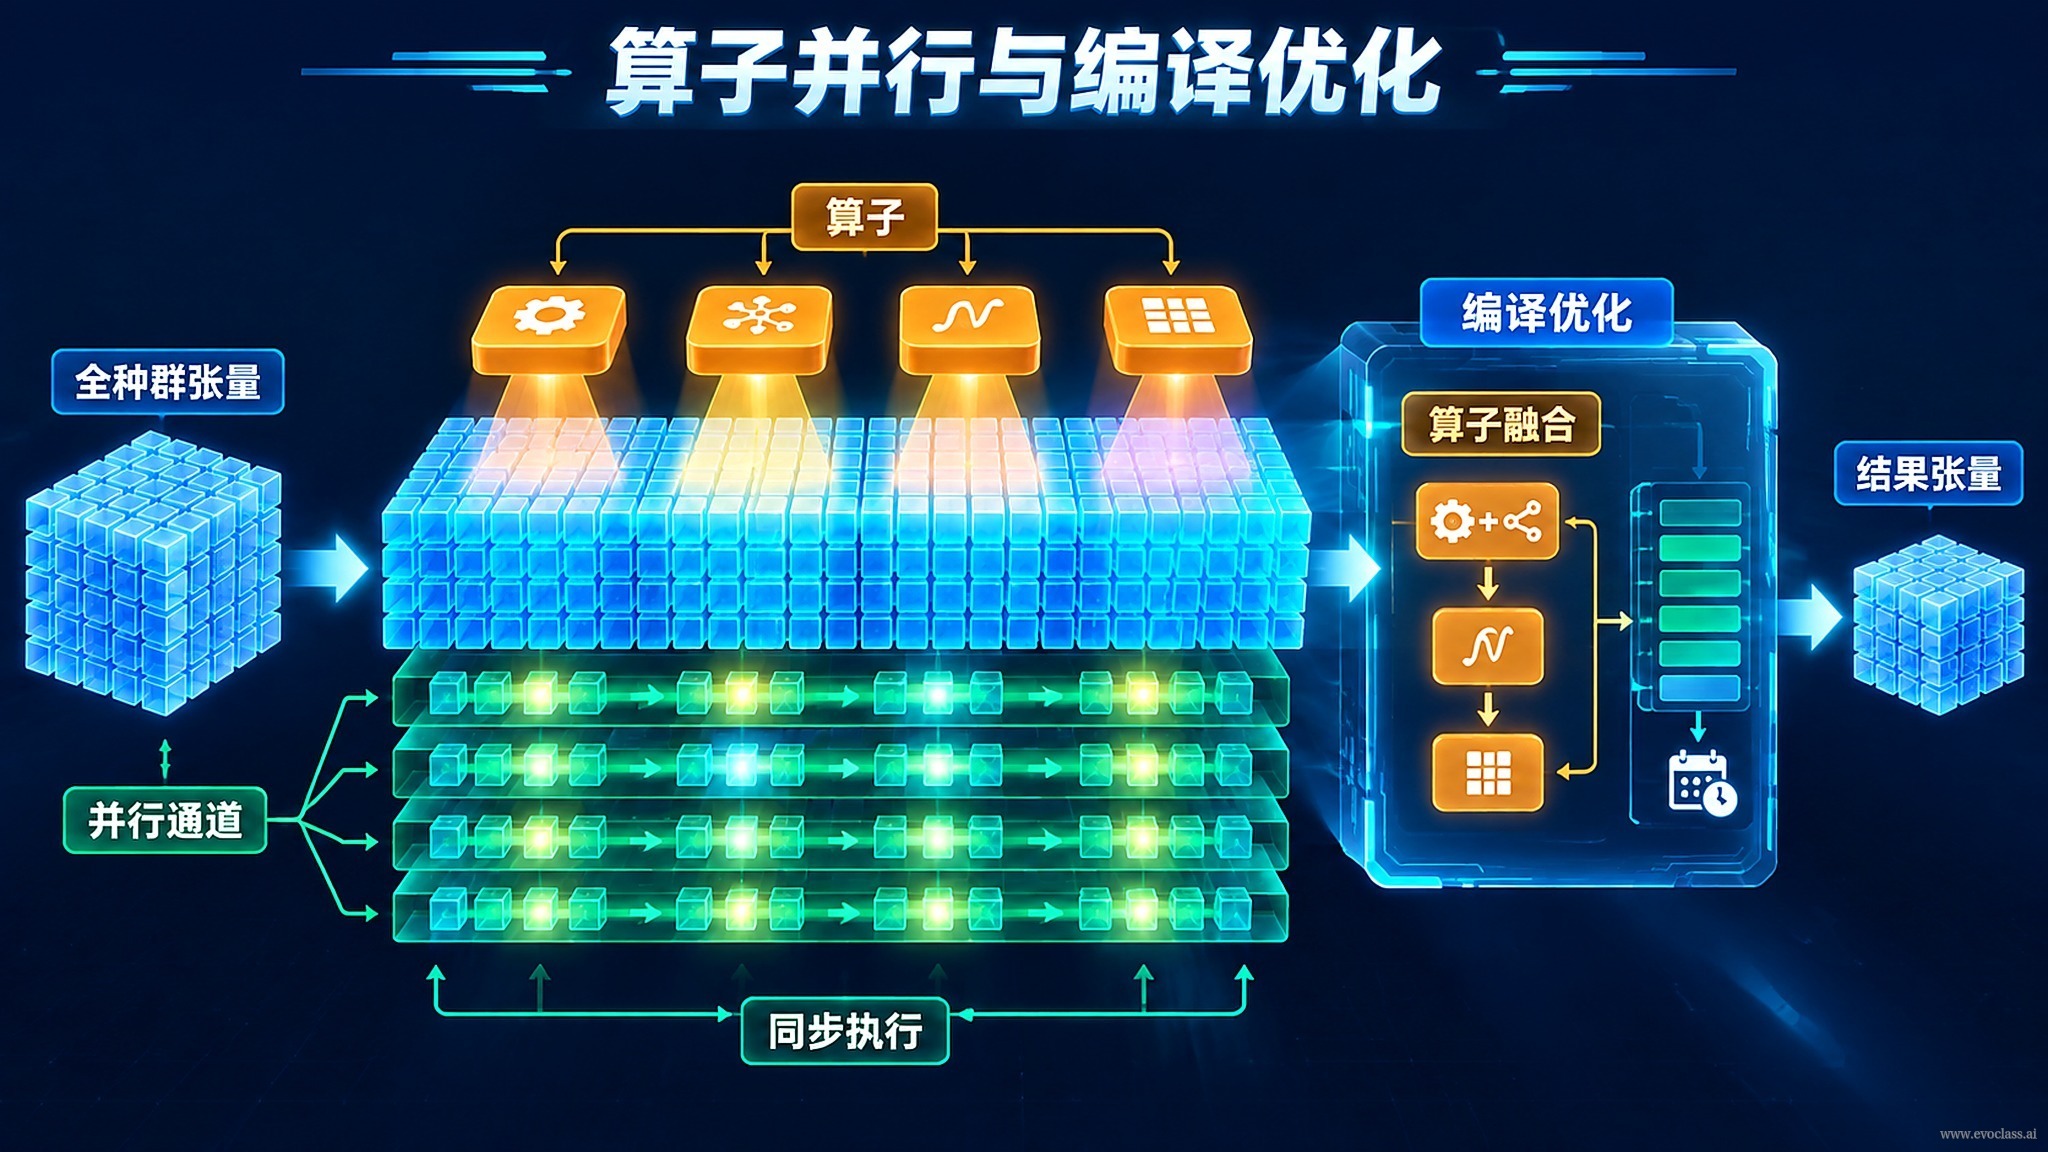
En EvoX y su moderna base de cómputo, la unidad mínima de ejecución de los operadores evolutivos ya no es el «individuo», sino todo eltensor de población: operadores como la mutación, el cruce y la selección cubren todos los individuos con una sola llamada; sobre esta base, lacompilación de grafos de cómputoorganiza la secuencia de operadores en un plan de ejecución optimizable, mejorando la eficiencia de ejecución sin alterar la semántica del algoritmo.
Paralelismo de operadores: evolución por lotes a nivel de tensor
- Operadores a nivel de tensor: la mutación, el cruce y la selección pueden aplicarse directamente sobre el tensor de población de forma [N, D] (N es el tamaño de la población y D la dimensión de las variables de decisión); una sola llamada al operador cubre los N individuos.
- Eliminación del bucle individuo por individuo: ya no es necesario escribir
for ind in population: ind = mutate(ind)bucles secuenciales de Python/CPU como este, reduciendo así el coste de las frecuentes llamadas al planificador y al framework. - Cambiar dimensión de lote por rendimiento: al convertir la dimensión de individuo en dimensión de lote, los operadores se ejecutan de forma masivamente paralela en el dispositivo, y el rendimiento de la evolución por lotes se amplifica con el tamaño de la población.
Compilación de grafos de cómputo: de la secuencia de operadores al plan de ejecución
Al organizar las dependencias de los operadores «mutación → cruce → selección» en ungrafo de cómputo, el compilador puede realizar optimizaciones globales sobre todo el grafo, en lugar de limitarse a invocar implementaciones predefinidas operador por operador:
- Fusión de operadores: combina varias operaciones elemento a elemento (element-wise) en un solo kernel, reduciendo la creación y la lectura/escritura repetida de tensores intermedios.
- Generación y planificación de kernels: genera kernels eficientes para el subgrafo fusionado, completando toda la evolución generacional con menos lanzamientos de kernel.
- Reutilización de memoria: planifica previamente búferes para los resultados intermedios, reduciendo el coste adicional de la asignación de memoria de la GPU y del trasiego de datos.
La eficiencia cambia, la semántica no
Es necesario distinguir entre«cómo se calcula»y«qué se calcula». El paralelismo de operadores y la optimización de compilación solo cambian la forma de ejecución —el número de kernels, el tamaño de los tensores intermedios, las estrategias de memoria y planificación— sin alterar el significado lógico de la mutación, el cruce y la selección. La capa algorítmica sigue componiendo los operadores según la semántica evolutiva; por ello, con la misma semilla aleatoria, la trayectoria evolutiva y los resultados antes y después de la optimización deben coincidir. En resumen: la tensorización resuelve «con qué rapidez se calculan los lotes» y la compilación de grafos de cómputo resuelve «con qué eficacia se planifican los kernels», mientras que «qué se calcula» permanece inalterado.
Flujo paralelo de los operadores sobre el tensor de toda la poblaciónLa mutación, el cruce y la selección ya no iteran individuo por individuo, sino que cada uno cubre todo el tensor de población [N, D] con una sola llamada, usando la dimensión de individuo como dimensión de lote para amplificar el rendimiento; una vez que estos operadores forman un grafo de cómputo según sus dependencias, el compilador puede realizar fusión de operadores, generación de kernels y reutilización de memoria, cambiando solo la forma de ejecución, mientras la semántica del algoritmo y la trayectoria evolutiva bajo una semilla aleatoria permanecen invariables.