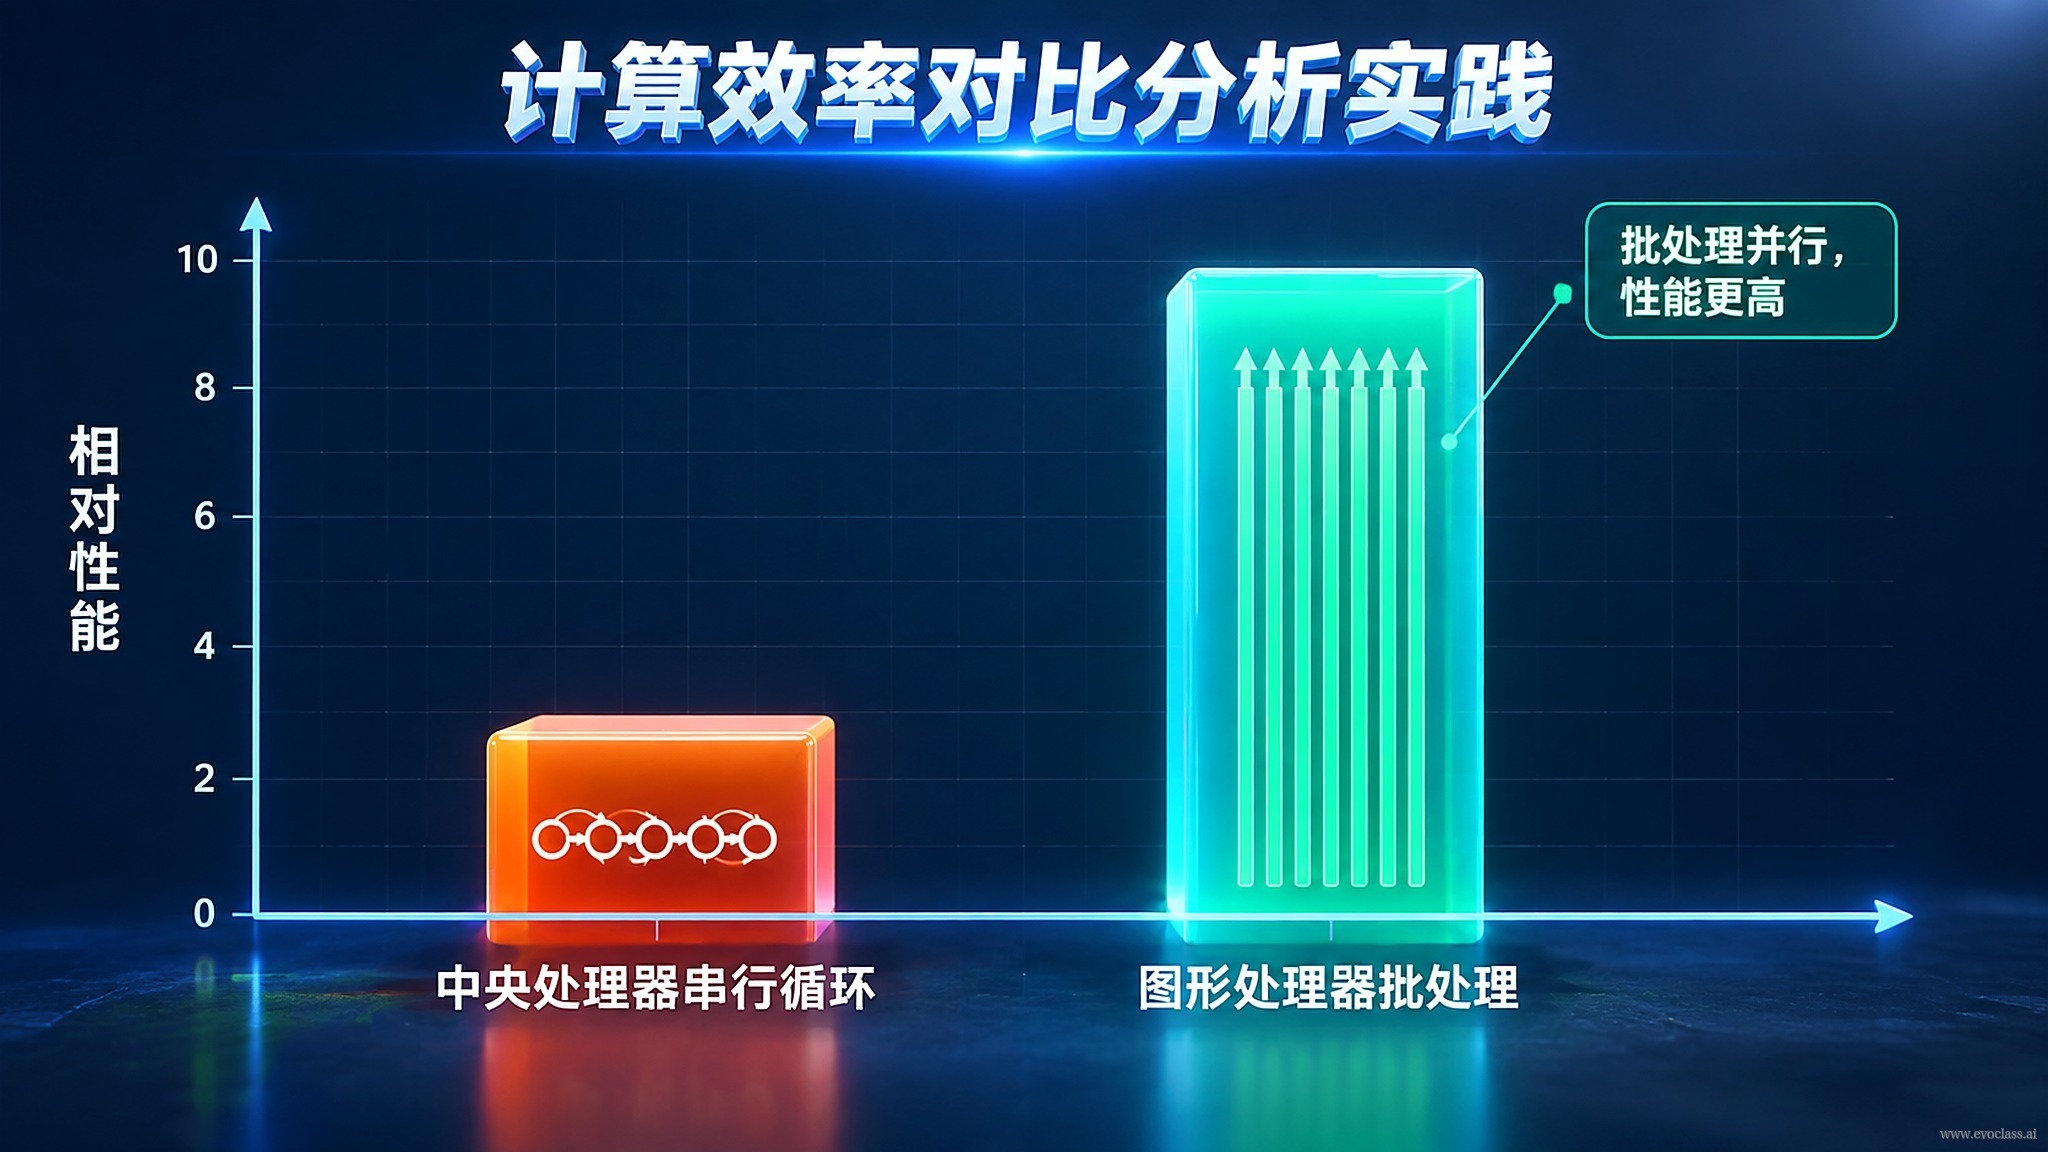
Esta página lleva la «comparación de eficiencia computacional» a una práctica reproducible:comparar, en una misma tarea evolutiva, la eficiencia de extremo a extremo entre el recorrido secuencial de individuos en CPU tradicional y el procesamiento por lotes con tensores en GPU de EvoX. El objetivo no es memorizar la conclusión de que «la GPU es más rápida», sino comprender de dónde proviene realmente la aceleración del paralelismo con tensores, cuál es su costo y dónde están sus límites.
Dos líneas base, una misma tarea
- Línea base secuencial en CPU: se recorre con un bucle cada individuo y se llama a la función de evaluación, de modo que cada generación requiere N despachos independientes, actualizaciones de estado y agregación de resultados. El control del bucle, la sobrecarga del intérprete y los accesos dispersos a memoria diluyen la capacidad de cómputo efectiva; cuanto más individuos, mayor es la proporción de estos costos «no computacionales».
- Implementación comparativa con tensores en GPU: EvoX organiza la población, las entradas de evaluación y el estado de ejecución como tensores, y ejecuta evaluaciones y operadores por lotes en la GPU, cubriendo todo el conjunto de candidatos en una sola llamada, lo que reduce drásticamente los bucles secuenciales y el número de despachos.
Protocolo de medición: hacer que la comparación sea reproducible
Una comparación reproducible debefijar el problema, el tamaño de población, el número de generaciones y la semilla aleatoria, y luego registrar: el tiempo de reloj por generación, el tiempo total, el rendimiento (evaluaciones/segundo), la aceleración, así como la utilización de la GPU y el uso de memoria de video. Antes de cronometrar se requiereun precalentamientopara descartar el efecto de la primera compilación y de la asignación de memoria, y realizar en los puntos de medición lasincronización del dispositivo, y además registrar por separado el tiempo de cómputo y el tiempo de transferencia de datos entre host y dispositivo. Si falta cualquiera de estos pasos, la aceleración obtenida puede resultar distorsionada.
De dónde provienen las diferencias y qué las restringe
- Fuentes de beneficio: el paralelismo por lotes, los operadores con tensores y el paralelismo dentro del dispositivo permiten que una sola llamada procese todo el conjunto de candidatos y se completen más evaluaciones por unidad de tiempo.
- Condiciones limitantes: el tamaño del lote, la dimensión del problema, el grado de vectorización de la función de evaluación, el costo de copia host-dispositivo y el costo de lanzamiento de kernels afectan la aceleración final. Un lote demasiado pequeño hace que la sobrecarga de lanzamiento se coma las ganancias; si la función de evaluación no puede vectorizarse, el procesamiento por lotes apenas puede aprovecharse.
Conclusión práctica
El orden correcto es:primero verificar si la función de evaluación puede procesarse por lotes y luego comparar las implementaciones en CPU y GPU. La ventaja de eficiencia debe reflejarse finalmente en «obtener más generaciones o más soluciones candidatas con el mismo presupuesto de cómputo», y decidir con base en ello el modo de despliegue y el diseño experimental, en lugar de perseguir sin más una cifra de aceleración atractiva.
Comparación de eficiencia entre CPU secuencial y GPU por lotesEn la comparación, la línea base secuencial en CPU evalúa individuo por individuo en un bucle, de modo que cada generación requiere N despachos y actualizaciones de estado, y la sobrecarga del intérprete y de los accesos a memoria diluye la capacidad de cómputo efectiva; el procesamiento por lotes en GPU organiza la población y las entradas de evaluación como tensores, cubriendo todo el conjunto de candidatos en una sola llamada. La aceleración está limitada por el tamaño del lote, el grado de vectorización de la función de evaluación y el costo de copia host-dispositivo.