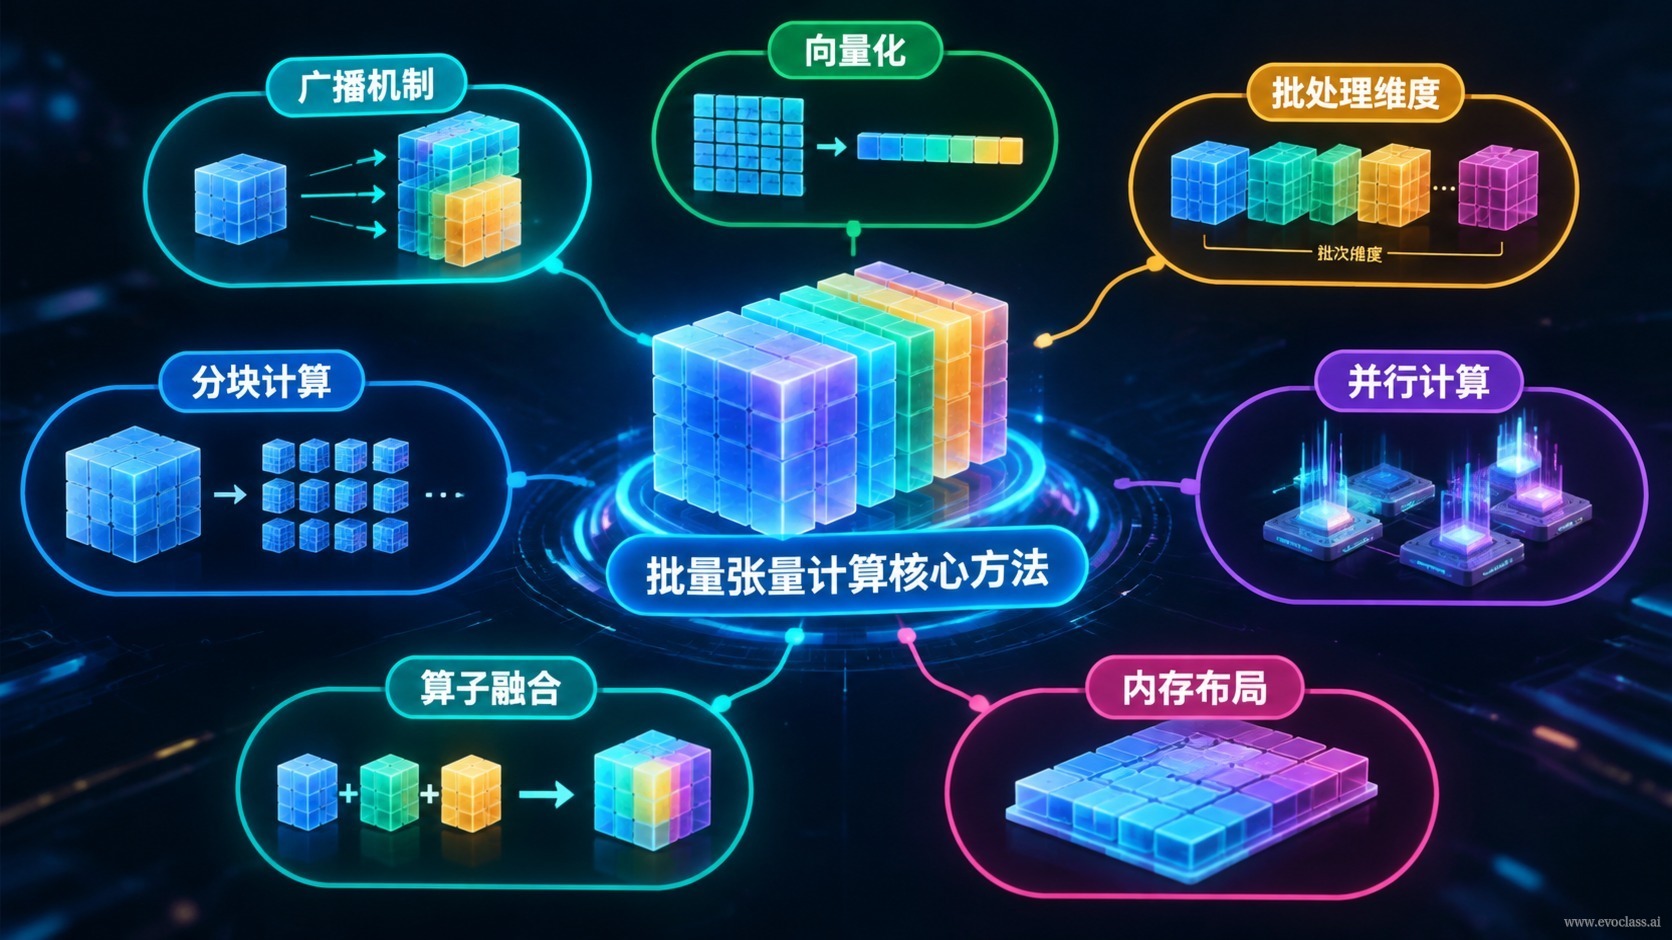
En la base de tensorización de EvoX,el cálculo tensorial por lotesocupa la capa de expresión algorítmica: mapea de forma unificada los candidatos, las evaluaciones y los estados del bucle evolutivo atensores con una dimensión de lotey los entrega a operadores por lotes amigables con la GPU y a un grafo computacional compilado para su ejecución. El objetivo es muy claro: transformar la «evolución secuencial individuo por individuo» en una «evolución paralela de toda la población», de modo que la potencia de cómputo actúe realmente sobre la búsqueda en sí, y no se consuma en la planificación y el arranque.
I. Expresar el proceso evolutivo como tensores
Si se conviene que la dimensión de lote N representa el número de candidatos (individuos), los tres elementos de la evolución pueden plasmarse directamente como tensores:
- Tensor de candidatos: la población X se organiza como [N × D], donde D es el número de variables de decisión de un candidato individual.
- Tensor de objetivos: los objetivos y restricciones F se organizan como [N × M], donde M es el número de términos de objetivo/restricción; en el caso multiobjetivo, cada objetivo es una columna distinta de F.
- Cantidades de estado: el número de generación, el mejor valor actual, el tamaño de paso, etc. se mantienen en búferes escalares o de tensores pequeños, en lugar de registrarse individuo por individuo con objetos de Python.
De este modo, el cruce, la mutación, la selección y la evaluación se procesan todos por lotes a lo largo de la dimensión N, y en el bucle evolutivo ya no aparecen ramificaciones ni flujos de control individuo por individuo.
II. Operadores por lotes: de N llamadas de un solo candidato a una sola operación por lotes
Tres expresiones mínimas comparables esbozan la forma básica de los operadores por lotes:
- Mutación: X′ = X + σ·randn(X); todo el lote de candidatos recibe su propia perturbación aleatoria en una sola operación por lotes, y σ controla la intensidad de la perturbación.
- Selección: idx = topk(F, k); a partir de la aptitud de los N candidatos se seleccionan de una vez los índices de los k mejores candidatos.
- Evaluación: Y = fθ(X); se sustituyen N llamadas de un solo candidato por una sola pasada hacia adelante por lotes o una sola simulación por lotes.
Lo clave no es un operador concreto, sino que todos los candidatos compartan un mismo grafo de operaciones tensoriales: una sola llamada por lotes basta para reducir el costo del intérprete y el de los lanzamientos de kernel, haciendo que la potencia de la GPU/multinúcleo actúe de verdad sobre la búsqueda evolutiva. El tratamiento de restricciones y de valores fuera de rango también puede realizarse con tensores de máscara dentro de la misma operación por lotes, sin necesidad de ramificar por separado para candidatos concretos.
III. Optimización del grafo computacional y métricas de rendimiento
Expresar la evolución de varias generaciones como un grafo de flujo de datos compilable permite exprimir aún más el rendimiento:Fusión de operadoresreduce el número de lanzamientos de kernel,Paralelismo dentro del lotehace que todos los candidatos se ejecuten a la vez,Ejecución asíncronasolapa el cálculo con la transferencia de datos,Reutilización de memoriay reduce la asignación de tensores intermedios. En consecuencia, la métrica de rendimiento también debe pasar de la «latencia de un solo paso» alrendimiento de candidatos/s o generaciones/s: con la ejecución por lotes, cada llamada procesa todo el lote de candidatos, y solo el rendimiento global refleja de verdad la eficiencia de la búsqueda.
Mapa de los métodos esenciales del cálculo tensorial por lotesEl mapa expresa el proceso evolutivo como tensores con una dimensión de lote: la población X es N×D, los objetivos y restricciones F son N×M, y el cruce, la mutación, la selección y la evaluación se procesan todos por lotes a lo largo de la dimensión N. La mutación, la selección topk y la evaluación hacia adelante por lotes solo necesitan una llamada por lotes, y la métrica de rendimiento pasa de la latencia de un solo paso al rendimiento en candidatos/s.