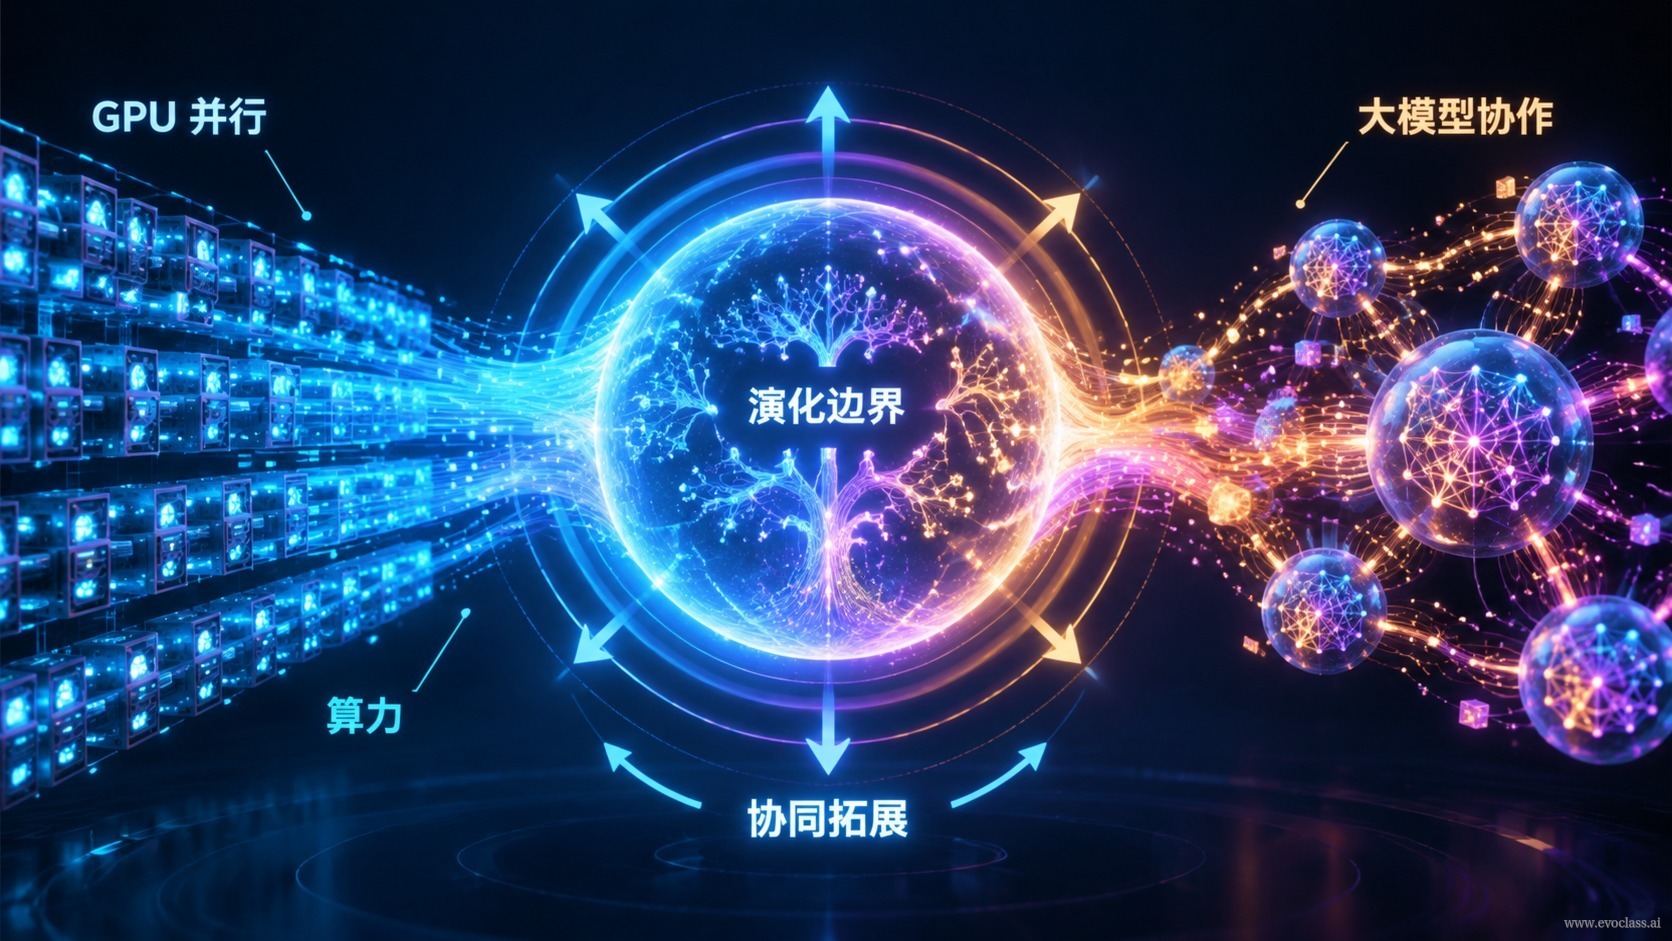
La computación evolutiva ha estado limitada durante mucho tiempo por un problema práctico: cuántos candidatos se pueden evaluar realmente en un tiempo finito. Hoy esta restricción se ha relajado por dos fuerzas de ingeniería que actúan al mismo tiempo:la potencia de cómputo paralelo de la GPUyla generación semántica de los grandes modelos. Juntas constituyen la doble base de ingeniería de la computación evolutiva:la capacidad de cómputo determina «cuántos candidatos se pueden explorar a la vez», y el gran modelo determina «qué formas de candidatos se pueden explorar», y ambos en conjunto expanden las fronteras del objeto evolutivo desde los parámetros numéricos hasta los programas, las estructuras de modelos y los propios mecanismos algorítmicos.
La base de cómputo: trasladar el espacio de candidatos del procesamiento secuencial a los tensores
En las implementaciones tradicionales, la evaluación de la población es un bucle secuencial en la CPU: se procesa un solo individuo a la vez y la sobrecarga de planificación se acumula con el tamaño de la población. Las bases de código abierto representadas por EvoX organizan de forma unificada los candidatos, los resultados de evaluación y el estado del algoritmo comotensores calculables en su totalidad: la mutación actúa sobre toda la población, y la evaluación y la actualización de estado, junto con la selección, entran en el grafo de cómputo para recibir optimización por compilación. El resultado directo en ingeniería es que «explorar decenas de miles de candidatos simultáneamente» pasa de ser un truco de laboratorio a una práctica habitual.
Este tipo de bases dividen el sistema en algoritmo, módulo de problema, flujo de trabajo y planificador de Runtime: el investigador solo necesita concentrarse en «cómo evolucionar», y el Runtime se encarga de programar el cálculo por lotes en la GPU, dispositivos de aceleración o clústeres distribuidos. Hay que tener claro que la capacidad de cómputo resuelve elrendimiento, no la «inteligencia». No juzga si un candidato es bueno o malo, solo se encarga de calcular la aptitud de toda la población de una sola vez. Es elsoporte fundamentalde la expansión del espacio de candidatos, pero no determina cómo son los candidatos.
La base semántica: elevar la forma de los candidatos de vectores numéricos a esquemas estructurales
La contribución del gran modelo no está en calcular más rápido, sino en que comprende el código, el conocimiento del dominio y el contexto de la tarea, y poseecapacidad de generación a nivel semántico. Por eso puede construir candidatos de estructura compleja —un fragmento de código de resolución directamente invocable, la topología de un modelo sustituto— en lugar de limitarse a producir un vector numérico. Así se abre el espacio de «formas» de los candidatos.
La expansión en tres niveles de las fronteras del objeto evolutivo
- Parámetros numéricos: configuración clásica, donde los miembros de la población son un conjunto de valores de parámetros bajo una estructura fija.
- Estructura de programa / modelo: los miembros de la población pasan a ser fragmentos de código ejecutable, o bien topologías de redes y modelos sustitutos. La capacidad de generación del gran modelo es precisamente la puerta de entrada a este nivel.
- Mecanismo algorítmico: incluso el propio proceso de «cómo generar y cómo evaluar» pasa a ser objeto de evolución. Esta es precisamente la premisa que hace posible la posterior «mejora de la evolución mediante la evolución» (como MetaDE o AutoPSO).
Tomemos como ejemplo la optimización de perfiles aerodinámicos: el enfoque tradicional solo puede buscar sobre unos cuantos parámetros numéricos predefinidos; cuando el gran modelo puede leer y escribir código de resolución y construir estructuras de modelos sustitutos, y la GPU puede evaluar en paralelo por lotes una población entera, el objeto de búsqueda asciende de «un conjunto de valores de parámetros» a «un conjunto completo de esquemas de generación y evaluación».
Complementarios, no sustitutos
Ambos mantienen una relación de complementariedad: la capacidad de cómputo amplía laAmplitudde búsqueda, y el gran modelo mejora lacalidad y la complejidad de forma de los candidatosde los candidatos; si falta cualquiera de las dos partes, la expansión de las fronteras no se sostiene. Con solo capacidad de cómputo y sin generación semántica, el objeto de búsqueda sigue limitado a codificaciones predefinidas; con solo capacidad de generación y sin evaluación por lotes, una enorme cantidad de candidatos no puede filtrarse en un tiempo aceptable.
El costo de expandir las fronteras
La expansión de las fronteras introduce al mismo tiempo nuevas restricciones: en primer lugar,aumenta el costo de evaluación, y una sola evaluación puede pasar de milisegundos a minutos; en segundo lugar,la verificación de la corrección se vuelve más difícil, ya que el código generado puede no compilar o no cumplir con las restricciones físicas y de ingeniería; y en tercer lugar,el criterio para determinar una «respuesta utilizable» es más difuso, y debe articularse con la ponderación multiobjetivo y la toma de decisiones por expertos, entre otros aspectos.
Diagrama de flujo de la colaboración entre el paralelismo de la GPU y los grandes modelos para expandir las fronteras evolutivasEl diagrama muestra que la expansión de las fronteras evolutivas depende de una doble base: la GPU y el Runtime tensorializado trasladan la evaluación de la población del bucle secuencial al procesamiento paralelo por lotes, y determinan cuántos candidatos se pueden explorar a la vez; el gran modelo aporta la generación a nivel semántico y determina qué formas de candidatos se pueden construir. Al complementarse, el objeto evolutivo puede extenderse desde los parámetros numéricos hasta las estructuras de programas y modelos, y después hasta los mecanismos algorítmicos, pero también trae nuevas restricciones, como el costo de evaluación, la verificación de la corrección y los criterios para determinar una respuesta.