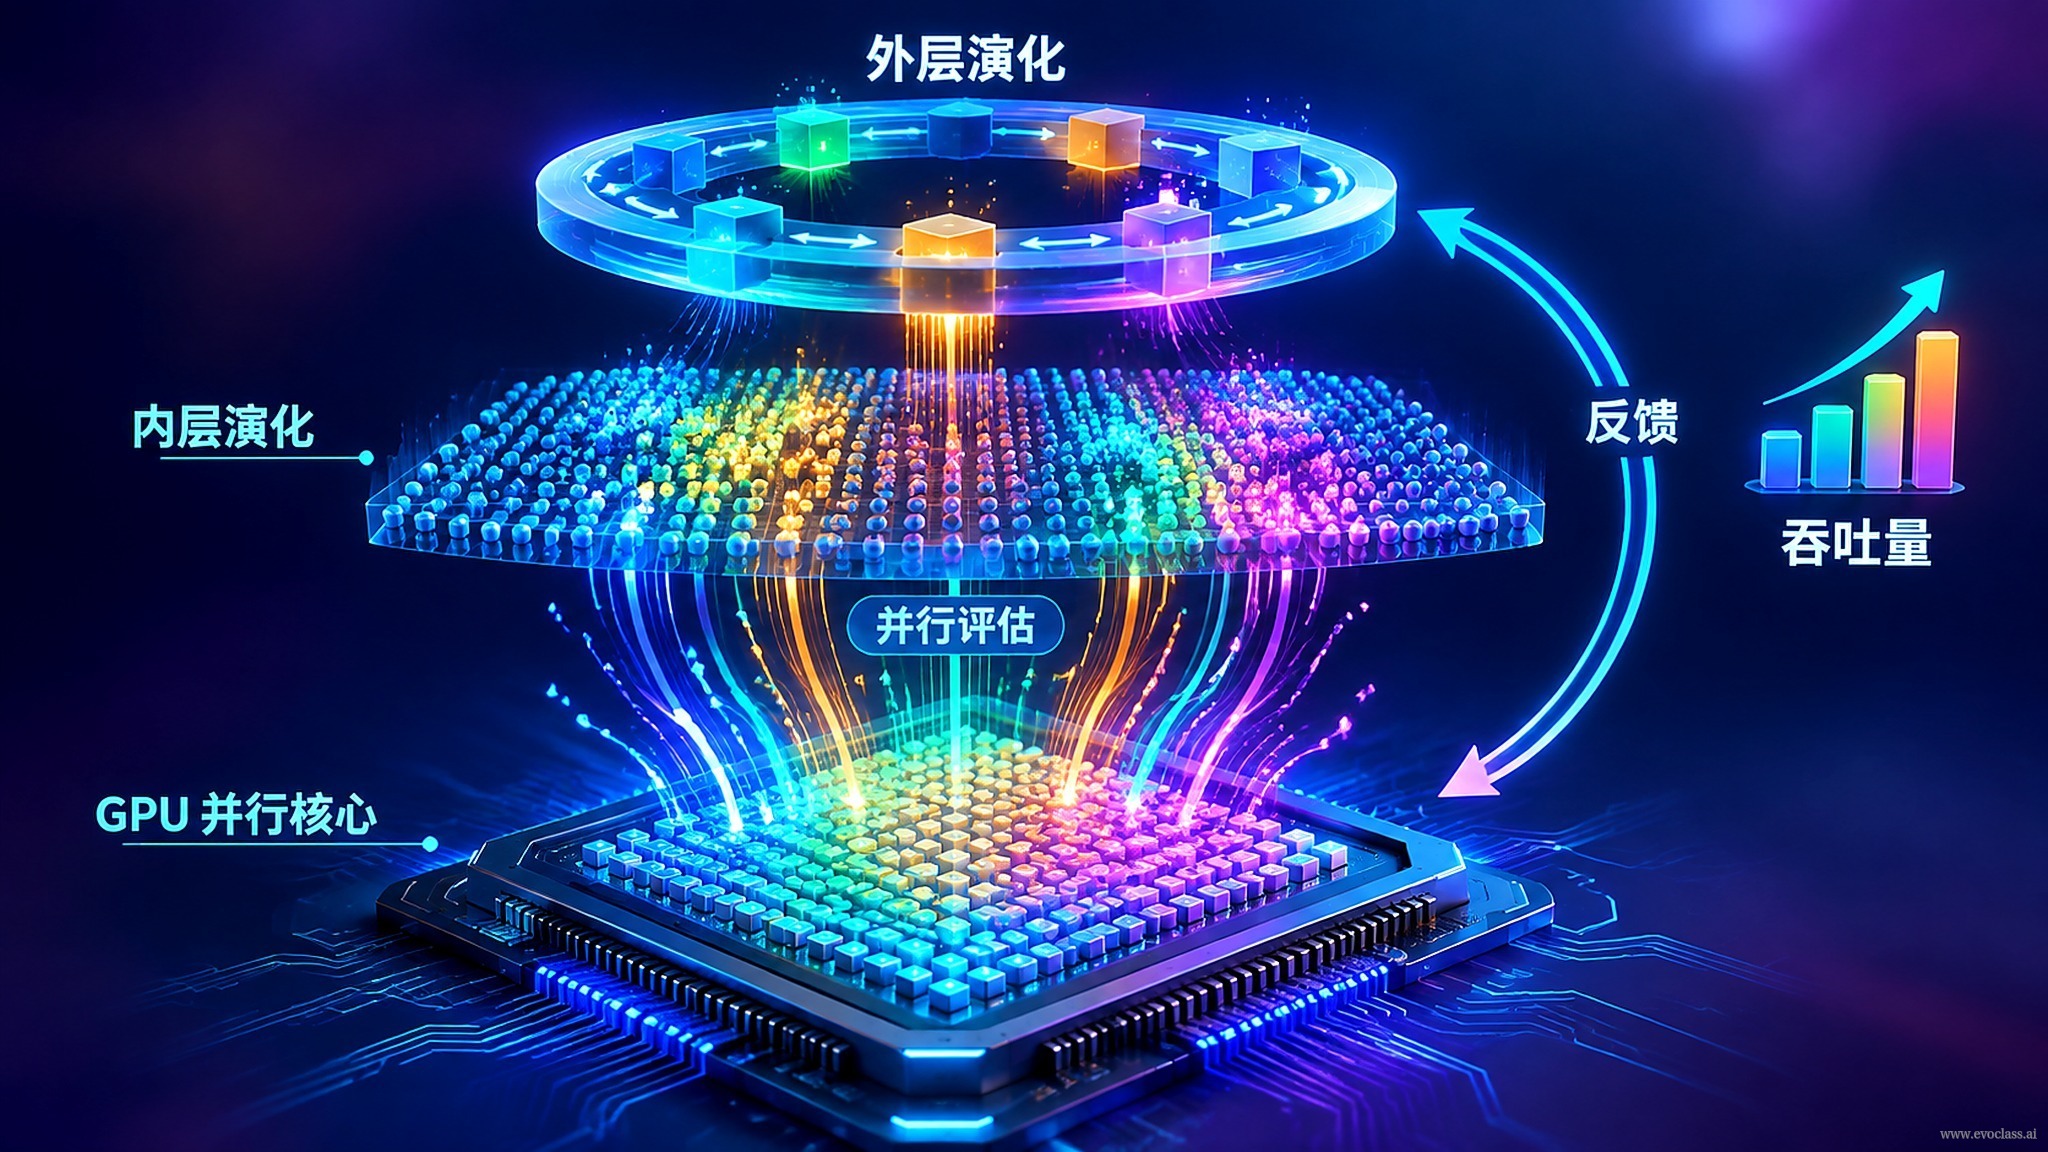
Cuando los algoritmos evolutivos se utilizan paramejorar los propios algoritmos evolutivos, coexisten dos niveles de cómputo en el sistema: el nivel interno se encarga de ejecutar y evaluar un gran número de configuraciones de algoritmos sobre numerosos casos de tarea, mientras que el nivel externo selecciona, muta y actualiza las configuraciones a partir de esos resultados de ejecución. Sin una base sólida de paralelismo, la evolución del nivel externo queda atrapada por la evaluación secuencial del nivel interno y se convierte en un cuello de botella.El paralelismo en GPUes precisamente la clave que convierte la «mejora de la evolución mediante la evolución» de una idea teórica en un proceso ejecutable de alto rendimiento: las tareas del nivel interno se ejecutan en paralelo por lotes y generan continuamente datos de rendimiento, y la evolución del nivel externo utiliza esos datos como retroalimentación para seleccionar de forma continua mejores configuraciones de algoritmos.
Cada nivel cumple su función
- Nivel interno (ejecución y evaluación): ejecuta por lotes en la GPU un gran número de configuraciones candidatas de algoritmos (distintos hiperparámetros, operadores o estrategias de búsqueda) y completa la ejecución y la puntuación de cada caso de tarea. La granularidad fina y el gran volumen de tareas encajan a la perfección con las características de rendimiento por lotes de la GPU.
- Nivel intermedio (agregación de retroalimentación): agrega el rendimiento bruto de la enorme cantidad de tareas del nivel interno en indicadores estadísticos, estima la calidad de cada configuración sobre toda la distribución de tareas y forma la aptitud que utilizará el nivel externo.
- Nivel externo (selección de configuraciones): toma la retroalimentación estadística como entrada, realiza selección, mutación o actualización, genera la siguiente generación de configuraciones y las devuelve al nivel interno, cerrando así el bucle.
Por qué el paralelismo en GPU es insustituible
En un bucle secuencial tradicional, el tiempo real de una sola iteración viene determinado conjuntamente por la «cantidad de configuraciones candidatas × cantidad de muestras de tareas»; en cuanto la escala crece un poco, se vuelve inasumible, por lo que el bucle secuencial se convierte en el principal cuello de botella que limita la escala de configuraciones candidatas y de muestras de tareas. El paralelismo en GPU permite que un gran número de algoritmos del nivel interno se ejecuten simultáneamente, degradando el bucle secuencial de «cuello de botella principal» a «coste de procesamiento por lotes aceptable», ampliando así al mismo tiempo el espacio de configuraciones explorables y el volumen de muestras de tareas.
Mecanismo central: un bucle cerrado
Todo el sistema puede resumirse como «rendimiento paralelo de las tareas del nivel interno → agregación de la retroalimentación de rendimiento → selección de configuraciones del nivel externo» : cuanto mayor es el grado de paralelismo, más abundantes son las muestras de retroalimentación, más estable es la estimación de la aptitud por parte del nivel externo y más fiable es la dirección de mejora de las configuraciones; las configuraciones mejoradas se devuelven a la capa inferior y entran en la siguiente ronda de rendimiento paralelo. Es precisamente este bucle cerrado el que dota a los algoritmos de capacidad de autoptimización continua y convierte la «mejora de la evolución mediante la evolución» de una idea teórica en un proceso eficiente y ejecutable.
Arquitectura de rendimiento de la evolución de dos niveles con paralelismo en GPUEl diagrama muestra un bucle cerrado: el nivel interno ejecuta por lotes en la GPU un gran número de configuraciones candidatas de algoritmos y completa su puntuación; el nivel intermedio agrega el enorme volumen de rendimiento del nivel interno en indicadores estadísticos y forma la aptitud; el nivel externo, a partir de esta, selecciona, muta y genera la siguiente generación de configuraciones, que devuelve al nivel interno. Cuanto mayor es el grado de paralelismo, más densas son las muestras de retroalimentación y más estable es la estimación que hace el nivel externo de la calidad de las configuraciones, con lo que el cuello de botella de la evaluación secuencial pasa a ser un coste de procesamiento por lotes aceptable.