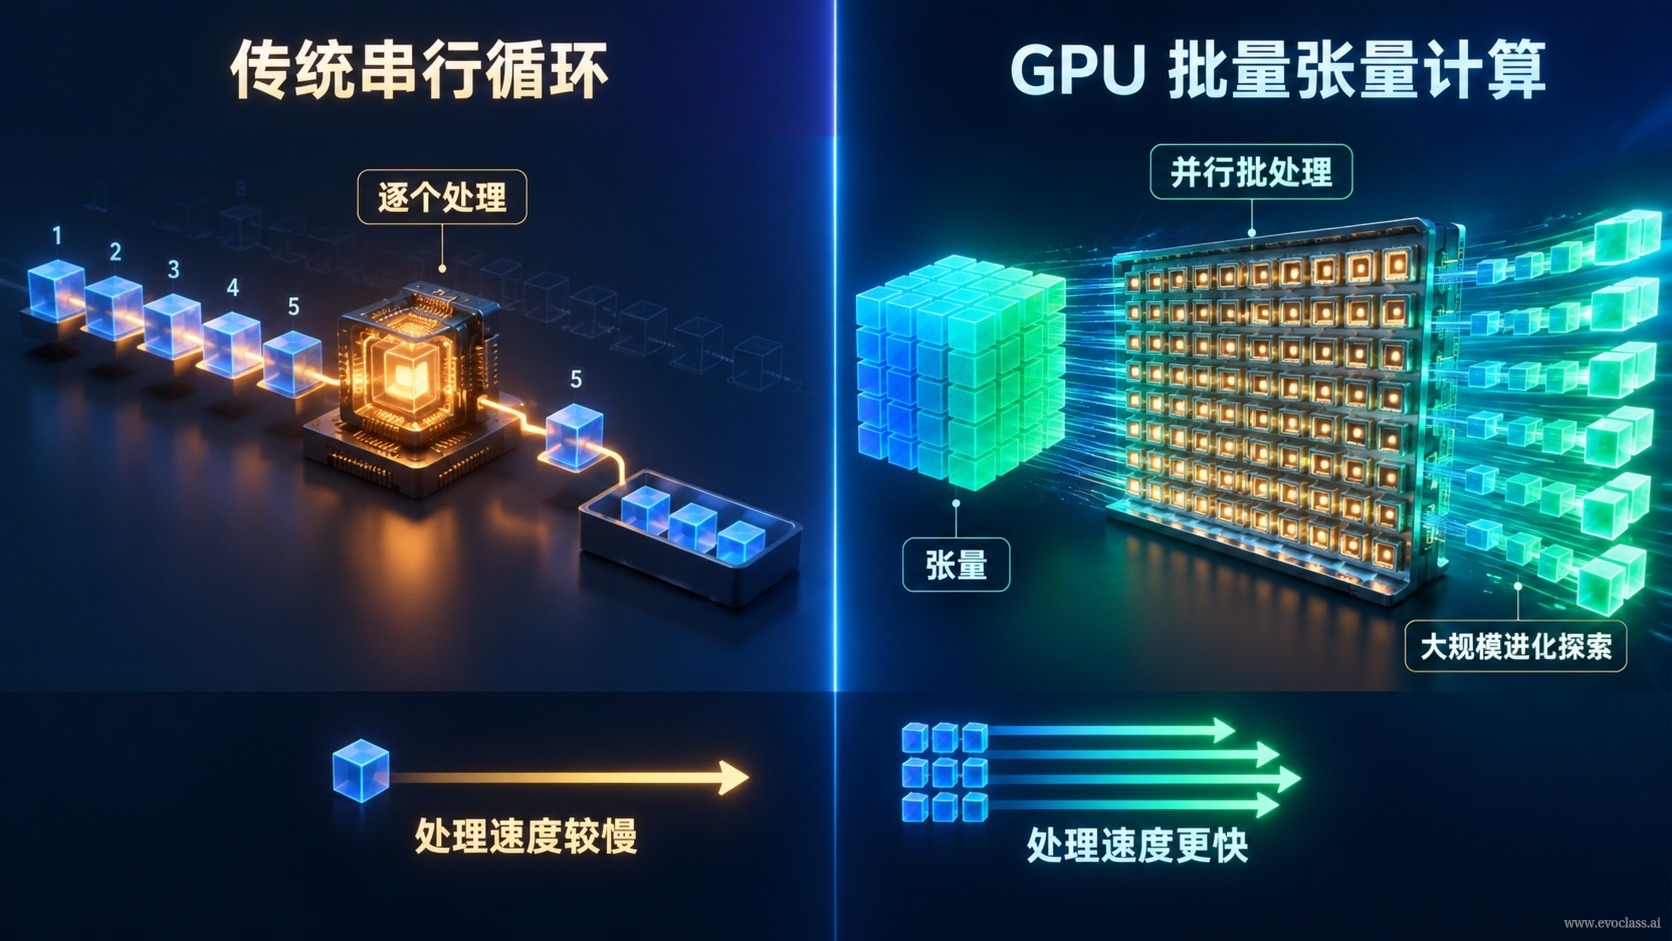
Cuando el tamaño de la población pasa de unas decenas a miles,la computación evolutivaya no tiene como cuello de botella principal «encontrar una buena solución», sino «evaluar suficientes candidatos en un tiempo limitado». La respuesta de ingeniería que ofrece EvoX son dos líneas de trabajo que se sustentan mutuamente:la computación tensorialreescribe el bucle secuencial individuo por individuo como operaciones tensoriales por lotes,la arquitectura unificadadesacopla el algoritmo, el problema, el flujo de trabajo y la planificación del Runtime, de modo que este mecanismo paralelo pueda reutilizarse en distintos algoritmos evolutivos y tareas.
Por qué la diversidad requiere rendimiento
La búsqueda evolutiva depende de la diversidad de la población: cuanto más dispersos estén los candidatos, mayor será la probabilidad de escapar de un óptimo local. Pero «mantener la diversidad» es en esencia un problema de capacidad de cómputo: exige que cada generación pueda evaluar y actualizar el estado de un gran número de candidatos. Si el método para generar candidatos sigue fijado de antemano por humanos y la evaluación sigue ejecutándose individuo por individuo, el sistema no hará más que repetir esquemas preestablecidos, y el beneficio de la diversidad quedará anulado por el cuello de botella del rendimiento de cálculo.
Evolución de métodos: incluir en la evolución también el «método que genera candidatos»
Una vez abierta la escala de cómputo, EvoX eleva un nivel más el objeto de optimización: ya no solo resuelve el problema, sino que incorpora como objeto evolutivo el propio método que genera las soluciones candidatas; esto es laevolución de métodos. Con MetaDE como ejemplo, el algoritmo interno resuelve la tarea real, mientras que el algoritmo externo evoluciona la configuración y las estrategias del algoritmo interno (por ejemplo, la estrategia de mutación y los hiperparámetros de la evolución diferencial), y ejecuta en paralelo una gran cantidad de tareas internas en la GPU, de modo que el rendimiento de las tareas guíe a su vez la selección de la configuración externa;AutoPSO y EvoGO dan un paso más al combinar componentes de enjambre de partículas y aprender la forma de generar candidatos a partir de la retroalimentación histórica, logrando el salto de «cambiar parámetros» a «cambiar la estructura del algoritmo». Esta evolución de doble nivel, interna y externa, exige de forma natural que una gran cantidad de tareas internas de la misma generación, e incluso del mismo instante, se evalúen y actualicen por lotes, lo que plantea mayores exigencias de rendimiento de cálculo y capacidad de paralelización.
Grafo de computación tensorial: sustituir los bucles por tensores por lotes
El bucle secuencial tradicional en CPU suele ejecutar «evaluación—registro—actualización» individuo por individuo, activando cada vez solo operadores de pequeña escala, lo que conlleva tres tipos de costes:alto coste de planificación,fragmentación de operadores,aprovechamiento insuficiente de la GPU. El enfoque del grafo de computación tensorial consiste en organizar de forma integralel mantenimiento de la población, la evaluación por lotes y la actualización de estadocomo operaciones tensoriales por lotes, de modo que los candidatos de una misma generación, e incluso de varias, se calculen en paralelo. Por ejemplo: cuando una misma generación contiene N soluciones candidatas, la implementación secuencial itera individuo por individuo, mientras que la implementación tensorial organiza la población como un tensor y completa de una sola vez la evaluación por lotes y la actualización de estado en paralelo, reduciendo así notablemente el coste de planificación y aumentando la tasa de ocupación de la GPU.
Arquitectura unificada: hacer reutilizable el mecanismo paralelo
Reescribir los bucles como tensores no basta: si el algoritmo, el problema y la lógica de planificación están acoplados entre sí, cambiar a otro algoritmo evolutivo o a otro tipo de tarea obligará a reescribirlo todo. La arquitectura unificada, al desacoplar módulos comoel algoritmo, el problema, el flujo de trabajo y la planificación del Runtime, permite que el mecanismo paralelo tensorial se reutilice en distintos algoritmos evolutivos y tareas (como los escenarios de evolución de métodos MetaDE, AutoPSO, etc.); junto con laplanificación de cómputo heterogéneo, se pueden gestionar recursos como CPU y GPU a nivel de tareas por lotes, sustentando así una exploración paralela componible y escalable.
Por qué es una capacidad de nivel «base»
La base de ingeniería que aportan la GPU y los grandes modelos eleva la computación tensorial por lotes de una optimización local a una capacidad fundamental que sustenta la exploración evolutiva a nivel de sistema. En otras palabras, la computación tensorial resuelve «correr rápido», mientras que la arquitectura unificada, abierta y desacoplada resuelve «poder cambiar»: la primera aporta rendimiento y la segunda, límites de reutilización componibles y escalables. Solo al combinarse ambas es cuando la exploración evolutiva paralela, de alta intensidad y alta diversidad, se convierte de verdad en una capacidad de ingeniería.
Comparativa de arquitecturas: bucle secuencial frente a computación tensorial por lotes en GPUA la izquierda, el modo secuencial tradicional en CPU ejecuta «evaluación—registro—actualización» individuo por individuo y solo activa operadores de pequeña escala, lo que provoca un alto coste de planificación, fragmentación de operadores y un aprovechamiento insuficiente de la GPU; a la derecha, el mantenimiento de la población, la evaluación por lotes y la actualización de estado se organizan de forma integral como operaciones tensoriales, completando de una sola vez el cálculo de los candidatos de una misma generación o incluso de varias, y se desacoplan de la planificación del Runtime, de modo que el mecanismo paralelo puede reutilizarse en distintos algoritmos y tareas.