Dans les premières pratiques du calcul évolutionnaire, les objets « évolués » étaient presque toujours desparamètres numériques— taux d'apprentissage, taille de lot, intensité de régularisation, méthode d'initialisation des poids. L'espace de recherche se résumait à un ensemble de nombres, et l'évaluation à un entraînement suivi d'une validation. Avec la montée en puissance du calcul et la maturité des grands modèles, les objets susceptibles d'évoluer se sont nettement étendus : programmes, architectures de modèles, mécanismes algorithmiques, et même tout un ensemble d'états d'ingénierie logicielle(configurations, versions de dépendances, contrats d'interface, stratégies de déploiement et d'exécution).
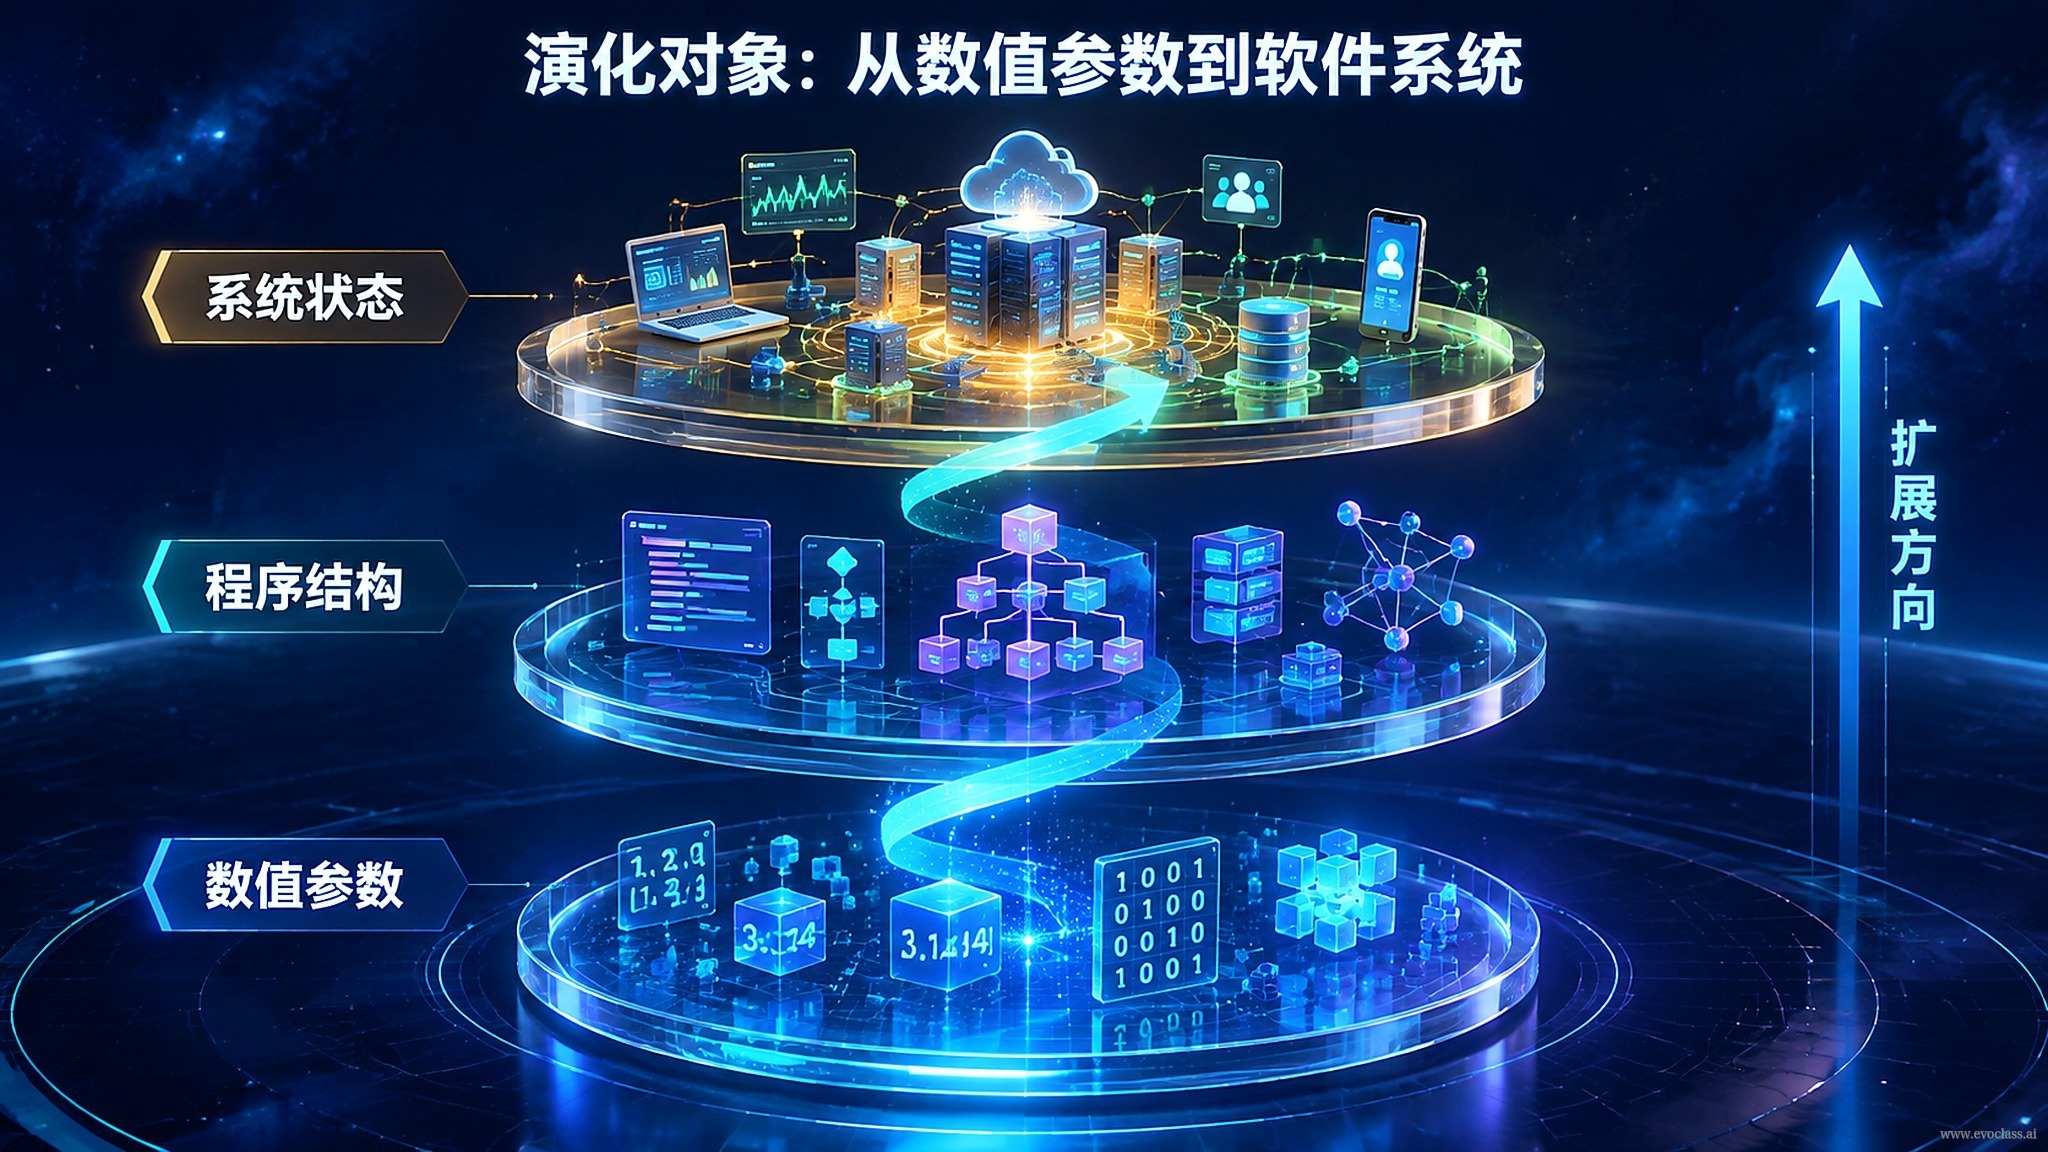
Ce chemin d'extension peut être représenté par une chaîne de flèches claire : paramètres numériques → programmes et architectures de modèles → états d'ingénierie logicielle et candidats au niveau système. Plus on va vers la droite, plus la puissance d'expression est grande et plus les types de changements couverts sont nombreux, ce qui rend possible l'évolution au niveau système.
Trois niveaux d'objets d'évolution, des coûts différents
- Niveau des paramètres numériques: le candidat est un simple ensemble de nombres, peu coûteux à générer et rapide à évaluer, mais il ne peut répondre qu'à la question « le réglage est-il bon ? » et ne peut pallier un mécanisme qui fait défaut au départ.
- Niveau des programmes et architectures de modèles: le candidat est une architecture de réseau, une combinaison d'opérateurs, un flux de travail de prompts ou un patch de code ; le changement modifie « ce que le système peut faire », et pas seulement « à quel point il est précis ».
- Niveau des états d'ingénierie logicielle: le candidat est une configuration, une version de dépendance, un contrat d'interface et une stratégie de déploiement, qui déterminent directement si le système peut fonctionner de manière stable et être reproduit.
Déplacement du centre de gravité : de « comment générer des candidats » à « comment exécuter et évaluer »
Lorsque les candidats passent des nombres aux programmes, l'étape de « génération de candidats » cesse d'être le goulot d'étranglement : les grands modèles peuvent produire en masse des structures, des mécanismes et des patches. Ce qui détermine réellement l'efficacité de l'évolution, c'est lemécanisme d'exécution et d'évaluation— qui peut réellement faire tourner les candidats, et qui peut juger, à un coût acceptable, s'ils méritent d'être conservés.
Plus la puissance d'expression est forte, plus la charge d'évaluation est lourde. Un paramètre numérique se note en un seul entraînement ; un patch de code, lui, exige une isolation en sandbox, des tests de non-régression et une comparaison aux références pour répondre à trois questions : est-il réellement efficace, présente-t-il un risque, et le résultat est-il reproductible ? Sandbox, tests de non-régression et références sont précisément des dispositifs d'ingénierie destinés à encadrer le coût, le risque et la reproductibilité, et ils permettent de conserver ou d'éliminer les changements de façon fiable.
Compromis d'ingénierie : plus de candidats ne signifie pas une meilleure évolution
Dans la pratique des équipes, le chemin courant consiste d'abord à régler le taux d'apprentissage et les hyperparamètres, puis à étendre progressivement la recherche aux architectures de réseau, aux combinaisons d'opérateurs, aux flux de travail de prompts ou aux patches de code. À chaque niveau d'extension, il faut répondre en parallèle : combien de calcul et de temps l'évaluation coûtera-t-elle ? Les candidats défaillants risquent-ils de polluer le système existant ? Les mêmes résultats seront-ils reproductibles la prochaine fois ? Ce n'est qu'en trouvant un équilibre entre puissance d'expression, coût d'évaluation, reproductibilité et sécurité que l'évolution au niveau système devient réellement viable.
Les trois niveaux d'extension des objets d'évolutionLa chaîne de flèches du schéma part des paramètres numériques vers les programmes et architectures de modèles, puis vers les états d'ingénierie logicielle et les candidats au niveau système : plus on va vers la droite, plus les objets modifiables sont nombreux et plus la puissance d'expression est forte. Mais le coût augmente en parallèle : un paramètre numérique se note en un seul entraînement, tandis qu'un patch de code exige isolation en sandbox, tests de non-régression et comparaison aux références pour juger de son efficacité, de son risque et de sa reproductibilité.