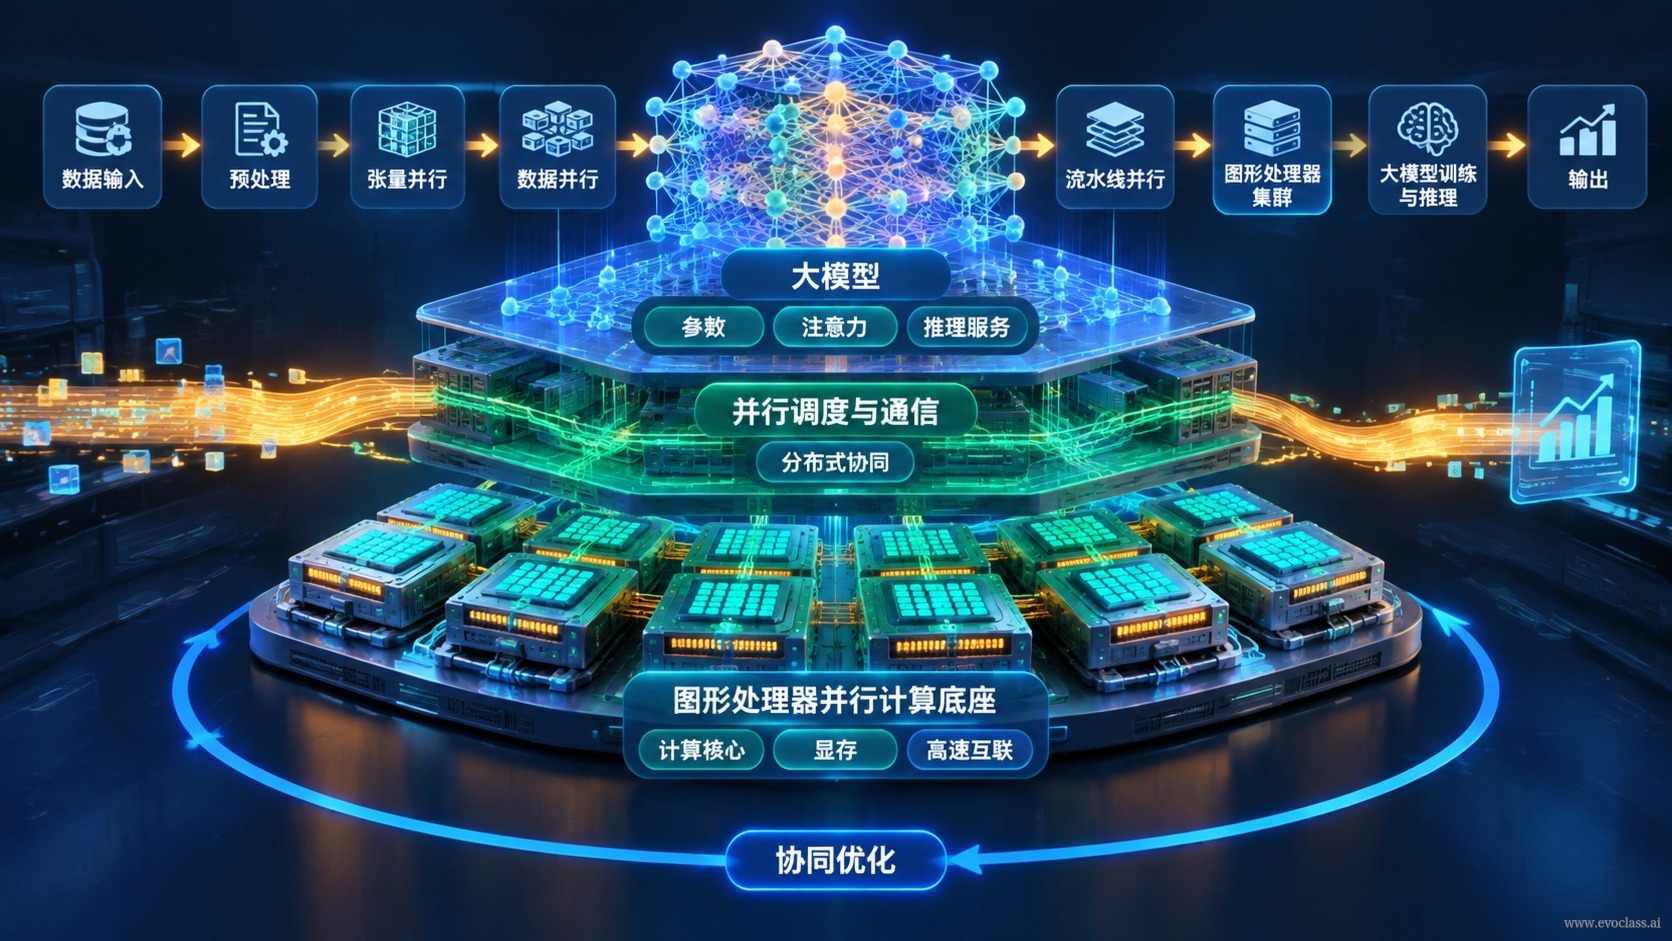
Cette page traite de l'infrastructure techniquequi permet à EvoX de mener une exploration évolutionnaire à grande échelle :les GPU fournissent une puissance de calcul parallèle intensive, et lesgrands modèles offrent la capacité de comprendre et de générer du langage naturel, du code et le contexte d'un projet. Une fois combinés, l'ampleur du calcul s'ouvre : la provenance, le nombre des solutions candidates et l'étendue de l'exploration possible changent radicalement.
Ce que la puissance de calcul ouvre : du traitement sériel par petits lots à l'exploration simultanée à grande échelle
Lorsque la puissance de calcul est limitée, l'évaluation d'une solution candidate implique souvent une file d'attente, et la recherche ne peut progresser que par petits lots, de manière sérielle : « en essayer quelques-unes de plus » relève du luxe. La capacité de parallélisation des GPU fait passer l'évaluation et la recherche à une échelle simultanée massive : une population ou un grand nombre de solutions candidates peuvent être soumises en une seule fois à une évaluation parallèle, et les retours affluent presque simultanément. Ainsi, « tenter simultanément un grand nombre de possibilités » n'est plus un moyen exceptionnel, mais devient une capacité d'ingénierie par défaut.
- Débit: l'évaluation par lots comprime le temps d'attente d'une itération dans une plage acceptable, permettant à la boucle évolutionnaire de tourner à haute fréquence au lieu d'être ralentie par l'étape d'évaluation.
- Échelle: le nombre de candidates explorables simultanément augmente, l'espace d'hypothèses couvert par la recherche s'élargit d'autant, et la frontière de l'exploration passe de « quelques essais-erreurs » à un « déploiement par lots ».
Ce qui a changé dans la provenance des solutions candidates
Une fois l'ampleur du calcul ouverte, la provenance des candidates passe d'une « conception manuelle + échantillonnage limité » à un mode hybride :l'approvisionnement par lots via le calcul parallèle et la génération et la réécriture par les grands modèles produisent ensemble les candidates. Les grands modèles, capables de comprendre le langage naturel, le code et le contexte d'un projet, transforment plus rapidement l'intention de recherche en candidates exécutables, scripts ou ébauches d'opérateurs, tout en maintenant la liaison avec le contexte du projet ; le côté GPU se charge de valider ces ébauches par lots et de renvoyer les résultats au processus de recherche. L'un en amont, l'autre en aval, ils couvrent précisément les deux extrémités : la « génération » et la « validation ».
L'infrastructure ne remplace pas l'algorithme évolutionnaire
Il faut préciser que cette couche est uneinfrastructureet non l'algorithme en soi. Elle assume leDébit, l'entrée sémantique et liaison du contexte; la recherche, la sélection et la boucle de rétroaction restent du ressort de l'algorithme évolutionnaire. C'est en clarifiant la répartition des rôles que l'on acquiert du discernement en pratique : lorsqu'un système donne de mauvais résultats, il faut d'abord déterminer ce qui manque — le débit de calcul, l'entrée sémantique, ou le mécanisme de boucle fermée lui-même.
Dans la même logique d'ingénierie, l'infrastructure doit aussi soutenir la collaboration multi-Agent et la décomposition récursive des tâches — des modèles d'ingénierie où un objectif complexe est décomposé en plusieurs sous-tâches, prises en charge et menées par différents Agents. Pour que ces sous-tâches ne se désolidarisent pas, il faut unepersistance au niveau du projet: déposer objectifs, contraintes, produits intermédiaires et résultats d'évaluation au niveau du projet, afin qu'ils puissentfranchir les contextes des différents Agents et se perpétuer. Sinon, à chaque changement d'Agent, le contexte doit être réaligné, et la décomposition récursive dégénère en appels ponctuels sans lien les uns avec les autres.
Schéma d'architecture de la collaboration entre le parallélisme GPU et les grands modèlesObservez le schéma d'architecture de la collaboration entre le parallélisme GPU et les grands modèles, et demandez-vous quel est son lien avec « la capacité des grands modèles à comprendre le langage naturel, le code et le contexte du projet ».