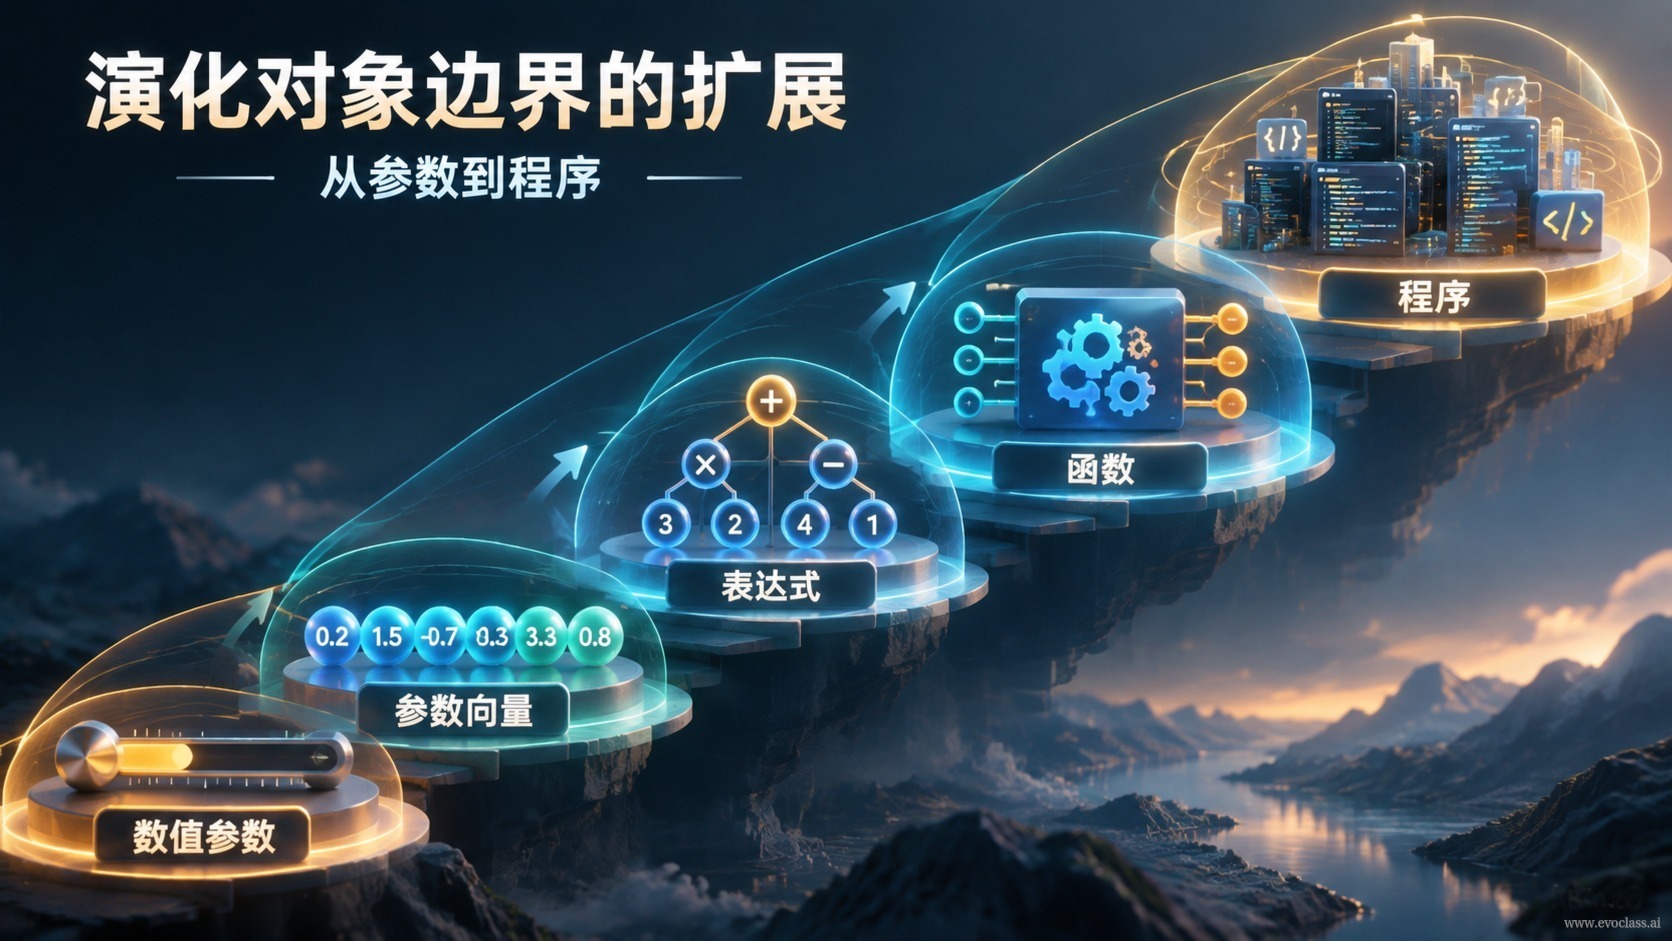
L'objet d'évolutiondésigne la partie du système évolutionnaire qui est réellement encodée, mutée, évaluée et sélectionnée. Les algorithmes évolutionnaires classiques supposent par défaut que cet objet n'est qu'un ensemble de paramètres numériques ; or, sur la base moderne constituée par les GPU et les grands modèles, cette frontière s'élargit : des paramètres numériques aux hyperparamètres et à l'architecture du modèle, puis aux mécanismes algorithmiques et aux opérateurs, et enfin aux programmes et à l'état persistant du génie logiciel.
La clé pour comprendre cette échelle est de saisir simultanément trois choses : comment l'objetest représenté, à quellescontraintes il est soumiset par quelsignal il est évalué. À chaque niveau franchi, ces trois éléments évoluent de concert.
- Niveau des paramètres numériques: l'objet est un vecteur réel continu θ \in \mathbb{R}^d, par exemple le taux d'apprentissage, les poids ou le facteur de mutation de l'évolution différentielle. Les contraintes portent principalement sur la plage de valeurs, et l'évaluation repose généralement sur un objectif scalaire f(θ).
- Niveau des hyperparamètres et de l'architecture du modèle: l'objet comporte des choix discrets, tels que le nombre de couches, la largeur, le mode de connexion et la stratégie d'augmentation des données. L'espace de recherche devient hybride et explose rapidement en combinatoire ; l'évaluation doit accorder une attention particulière à la capacité de généralisation et au surajustement.
- Niveau des mécanismes algorithmiques et des opérateurs: l'objet est lui-même le mécanisme à exécuter, par exemple la stratégie de mutation de l'évolution différentielle, la façon de combiner les coefficients d'inertie dans l'essaim particulaire, ou la forme concrète de la fonction de perte. Les candidats doivent satisfaire des contraintes syntaxiques et sémantiques, et l'évaluation passe de « qui obtient le meilleur score » à la robustesse, la stabilité et les compromis multi-objectifs.
- Niveau des programmes et de l'état d'ingénierie: l'objet devient un script d'entraînement, une configuration de pipeline, des dépendances et l'état du projet. Un candidat n'est considéré comme valide que s'il passe la compilation, les tests et la validation ; l'évaluation devient un retour au niveau du système : de combien la précision s'améliore, si le coût en ressources est acceptable, et si les résultats sont reproductibles.
Pourquoi la frontière s'élargit
Deux forces y contribuent. D'une part, l'échelle de la puissance de calcul ouvre la possibilité d'une exploration parallèle : les boucles séquentielles autrefois écrites autour d'un seul candidat sont remplacées par la tensorisation et le parallélisme par lots, permettant de générer et d'évaluer toute une population d'un seul coup. D'autre part, les grands modèles savent comprendre le langage naturel, le code et le contexte métier, ce qui permet au système de construire des candidats structurellement complexes — des modes d'encodage et de mutation qui devaient autrefois être conçus manuellement peuvent désormais être générés avec la participation du modèle.
Lorsque « la méthode qui produit les candidats » peut elle-même être exprimée et évaluée, une question naturelle surgit : puisque les solutions candidates peuvent être évoluées, la méthode qui les produit ne pourrait-elle pas devenir à son tour un objet d'évolution ? C'est précisément le palier qui mène de « l'optimisation de solutions » à « l'optimisation de l'algorithme lui-même ».
Le signal d'évaluation doit évoluer avec l'objet
Au niveau des paramètres, un objectif scalaire unique suffit à guider la recherche, par exemple \min f(θ). Au niveau des programmes, aucun scalaire ne peut résumer « si ce code mérite d'être conservé » : l'évaluation devient un compromis multi-objectifs sous contraintes, où il faut considérer simultanément la précision f1, le coût d'évaluation f2 et la stabilité f3, et, sous la contrainte C(x) ≤ 0 , rechercher un ensemble de candidats non dominés. La liste de critères couramment utilisée en ingénierie comprend : la compilation réussit-elle, les tests sont-ils couverts, les performances de référence s'améliorent-elles, le coût en ressources est-il acceptable, et les résultats sont-ils reproductibles.
Idée fausse courante : étendre ne signifie pas générer au hasard
Repousser la frontière de l'objet ne signifie pas pouvoir générer du code à volonté. Plus l'objet est libre, plus les contraintes ne disparaissent pas : elles se déplacent de la « plage de valeurs » vers la « syntaxe, les interfaces et l'exécutabilité » ; la responsabilité de validation n'est pas allégée, elle s'alourdit. Les équipes qui ouvrent l'évolution au niveau des scripts se heurtent généralement à deux problèmes concrets : une explosion de l'espace de recherche, et une multitude de candidats « qui tournent mais n'apportent rien » qui dévorent le budget d'évaluation.
Une approche plus sûre consiste donc à ouvrir par étapes : élargir progressivement le périmètre modifiable, écarter d'abord les candidats manifestement inutiles par un filtrage à faible coût ou un modèle de substitution, puis réserver l'évaluation haute fidélité à une minorité de pistes prometteuses, en arbitrant explicitement entre précision et coût.
Schéma hiérarchique de l'évolution de l'objet d'évolution, des paramètres numériques vers des structures de code complexesObservez le schéma hiérarchique de l'évolution de l'objet d'évolution, des paramètres numériques vers des structures de code complexes, et demandez-vous quel est son lien avec « l'extension de l'objet d'évolution des paramètres au programme, à l'architecture du modèle, aux mécanismes algorithmiques et à l'état du génie logiciel ».