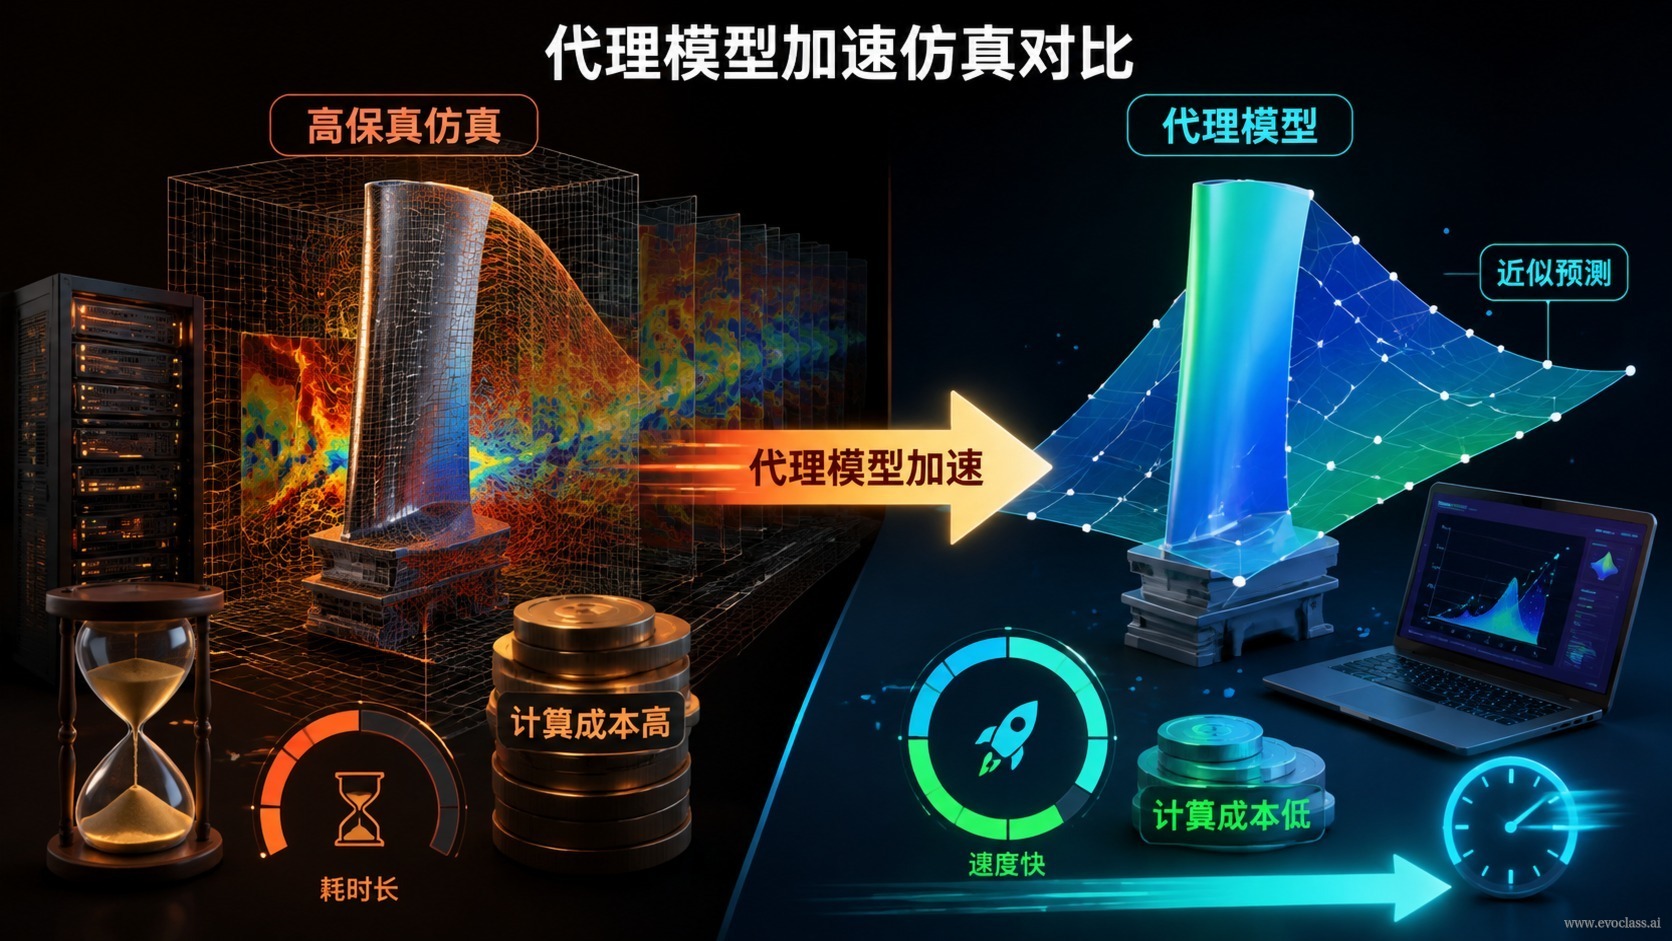
Dans la conception technique complexe, comme celle des profils d'aile supercritiques,la simulation haute fidélité(CFD, analyse par éléments finis) nécessite souvent de plusieurs dizaines de minutes à plusieurs heures pour une seule évaluation. Si l'on intègre directement ce type de simulation dans la boucle d'évolution, chaque génération de population doit être évaluée individuellement : le budget de calcul est rapidement épuisé en quelques dizaines de générations, et l'espace de recherche explorable s'en trouve réduit d'autant.
Le modèle de substitution(surrogate model, également appelé modèle approché ou méta-modèle) remplace en tout ou partie la simulation haute fidélité par un calcul approché peu coûteux : il apprend la correspondance entrée-sortie à partir d'échantillons de simulation existants et prédit rapidement les performances des solutions candidates dans l'optimisation évolutionnaire multi-objectif, ce qui permet de lever le goulot d'étranglement lié au coût élevé des simulations de haute précision.
Pourquoi il est impossible d'intégrer directement la simulation haute fidélité dans la boucle d'évolution
- Origine du goulot d'étranglement: pour des problèmes tels que les profils d'aile supercritiques ou la résistance structurelle, une seule simulation CFD / éléments finis est longue, tandis que l'algorithme évolutionnaire doit évaluer toute la population à chaque génération ; le nombre d'évaluations et le budget de calcul sont donc consommés de manière quasi linéaire.
- Conséquence directe: le budget est épuisé en quelques générations seulement ; la taille de la population et le nombre d'itérations se trouvent contraints à la baisse, le front multi-objectif est difficile à explorer pleinement, et le véritable espace de conception reste verrouillé par l'impossibilité d'évaluer.
Principe fondamental du modèle de substitution
À partir de donnéesexistantes, telles que des profils d'aile de base et des échantillons perturbés, on entraîne une correspondance « solution candidate → valeurs des objectifs et respect des contraintes », qui devient unévaluateur approché peu coûteux. Dans la boucle d'évolution, les solutions candidates sont d'abord notées par lots par le modèle de substitution ; seules les quelques candidates les mieux classées, ou celles dont l'incertitude est élevée, sont soumises à la vérification par simulation haute fidélité.
Les quatre étapes du chemin d'accélération
- Entraînement hors ligne: entraîner le modèle de substitution à partir des échantillons initiaux afin d'établir une première correspondance entrée-sortie.
- Prédiction par lots en ligne: à chaque génération, prédire simultanément plusieurs valeurs d'objectifs pour toutes les candidates, en remplacement de la simulation haute fidélité point par point.
- Sélection de points assistée par modèle: combiner les valeurs prédites et l'incertitude pour sélectionner les candidates à fort potentiel ou à forte information.
- Rétro-alimentation et correction: réinjecter un petit nombre de résultats haute fidélité dans la base d'échantillons et mettre à jour le modèle de substitution de façon incrémentale, afin que les prédictions suivantes restent proches de la vraie surface de réponse.
Compromis entre précision et coût
Plus le modèle de substitution est complexe (de la simple régression au processus gaussien ou au réseau profond), plus il est généralement précis, mais son coût d'entraînement et d'inférence augmente également. La contrainte essentielle est quele modèle de substitution doit être nettement plus rapide que la simulation haute fidélité, sinon il devient un nouveau goulot d'étranglement ; sa précision doit également être suffisante pour soutenir la pression de sélection, faute de quoi l'évolution serait orientée dans la mauvaise direction.
Limites et risques
Le modèle de substitution n'est fiable qu'à proximité de la distribution d'entraînement. Lorsque la recherche pousse les candidates hors de cette distribution, les prédictions peuvent fournir des valeurs d'apparence plausible mais fortement erronées, ce qui induit la recherche en erreur. Les pratiques recommandées sont les suivantes : fournir une estimation de l'incertitude, définir un filtrage par seuil de confiance, imposer une validation haute fidélité aux candidates hors domaine, et vérifier périodiquement la qualité du modèle à l'aide de statistiques d'erreur réelles.
Comparaison de l'accélération des simulations par modèle de substitutionCe schéma compare le processus d'évaluation de la simulation haute fidélité et du modèle de substitution dans l'optimisation évolutionnaire : le premier est coûteux point par point et ne peut soutenir la recherche sur de grandes populations pendant plusieurs générations ; le second apprend, à partir d'échantillons existants, la correspondance entre solutions candidates et valeurs d'objectifs, puis prédit rapidement par lots. Seules les candidates les mieux classées ou les plus incertaines sont soumises à la vérification haute fidélité, et les résultats sont réinjectés pour mettre à jour le modèle, concentrant ainsi le budget de simulation, ressource rare, sur les candidates clés.