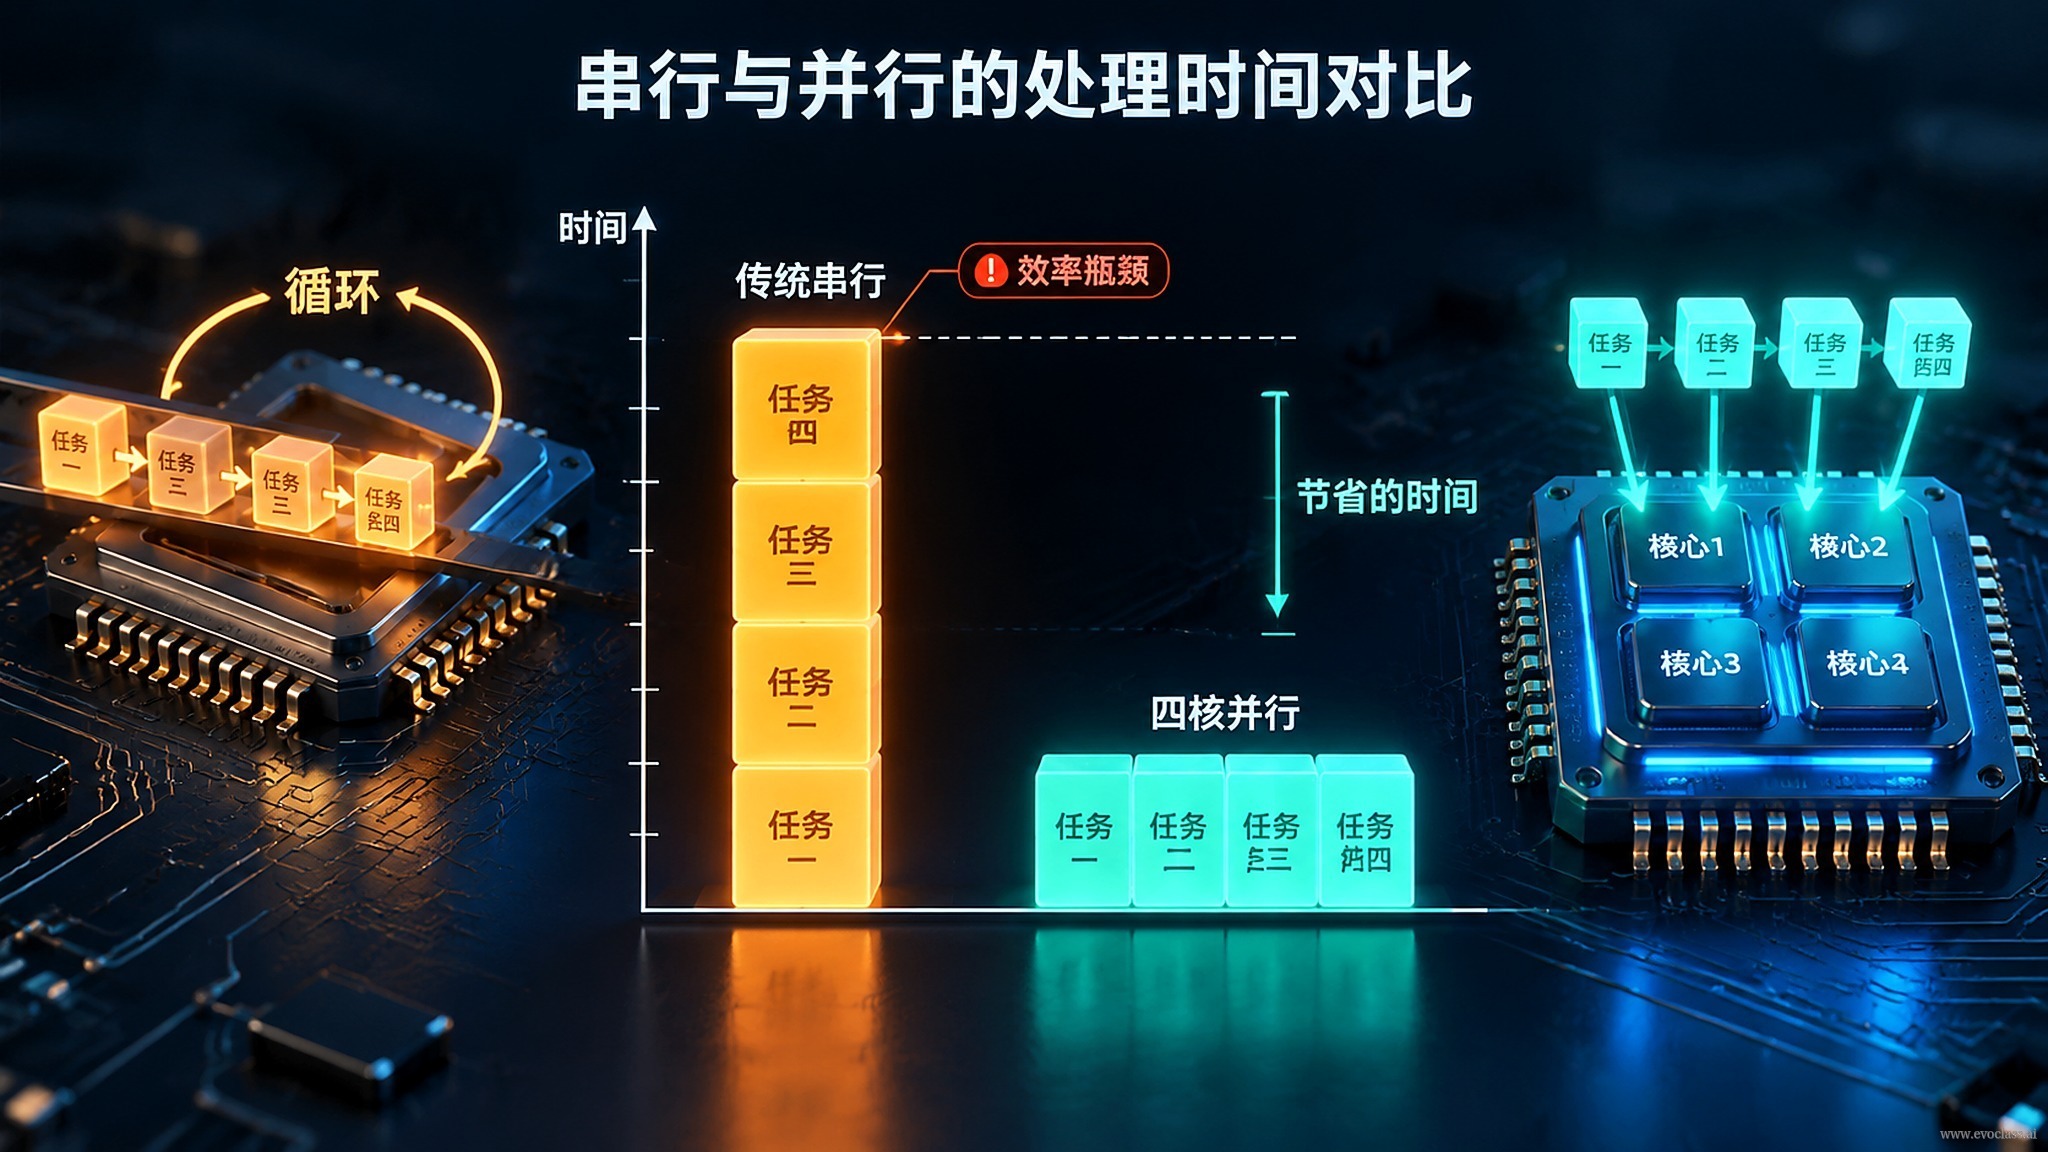
Le processus évolutif repose sur la diversité de la population, et cette diversité implique une multiplication de la taille de la population et du nombre d'évaluations. Lorsque le nombre d'évaluations de candidats atteint l'ordre de plusieurs dizaines de milliers,la boucle CPU séquentielle classiquedevient le segment le plus étroit de toute la chaîne : elle ne traite qu'un seul individu à la fois, laissant la capacité parallèle du matériel presque entièrement inexploitée.
Un à la fois : le modèle d'exécution de la boucle séquentielle
L'implémentation la plus simple consiste à traiter toute la population comme une liste et à extraire les individus un par un dans une boucle : sélection de l'individu → décodage en paramètres concrets → appel de la fonction d'évaluation → écriture de la fitness. Les itérations adjacentes ne peuvent presque jamais se chevaucher : tant que le résultat d'évaluation n'est pas revenu, l'écriture ne peut pas avancer ; tant que l'écriture n'est pas terminée, l'individu suivant n'a nulle part où déposer son résultat. Résultat : les unités parallèles comme les multicœurs, le SIMD et le GPU restent inactives la plupart du temps, se contentant de regarder un seul individu parcourir la chaîne.
D'où viennent réellement les surcoûts
- Nombre d'évaluations à croissance linéaire: le nombre total d'évaluations est approximativement égal à la taille de la population × le nombre de générations ; lorsqu'il atteint l'ordre de 10⁵, le temps réel d'exécution séquentielle croît de façon quasi linéaire.
- Exécution individuelle au niveau de l'interpréteur: les boucles individuelles, les vérifications de limites et la répartition des types entraînent des surcoûts constants fixes mais élevés.
- Accès mémoire non contigus et transferts de données: les individus extraits un par un sont souvent non contigus en mémoire, le taux de succès du cache est faible et les coûts de transfert sont payés à répétition.
- Synchronisation et ordonnancement: pour atteindre l'individu suivant, le flux d'exécution doit sans cesse s'interrompre puis reprendre.
Convertir l'échelle en temps
Prenons l'exemple d'une population de 1000 individus sur 100 générations, soit environ 100 000 évaluations de candidats. Si une évaluation dure en moyenne 1 ms, la seule phase d'évaluation en séquentiel prend environ 100 secondes, sans compter les coûts de calcul des opérateurs et d'ordonnancement ; si, pour maintenir la diversité, on fait passer le nombre de redémarrages de 1 à 5, le coût grimpe de façon quasi linéaire jusqu'à environ 500 secondes. À charge de travail égale, si l'on organise les traitements par lots et qu'on les confie à du matériel parallèle, le temps réel dépend principalement du nombre de lots et non du nombre d'individus.
Quand ce goulot d'étranglement se réduit
Les conditions aux limites sont tout aussi importantes : lorsque l'évaluation individuelle est extrêmement bon marché (de l'ordre de la microseconde) ou que la population est très petite (moins de quelques centaines d'individus), les coûts d'ordonnancement et de mémoire peuvent dépasser les coûts de calcul, l'écart entre séquentiel et parallèle se réduit nettement, le gain marginal de la tensorisation diminue et le goulot d'étranglement se déplace vers la granularité de l'ordonnancement et la bande passante mémoire. Il faut donc évaluer conjointement le coût d'évaluation et l'échelle avant de décider s'il vaut la peine de refondre le modèle d'exécution.
Comparaison des temps d'exécution séquentiel et parallèleAvec une population de 1000 individus sur 100 générations, on obtient environ 100 000 évaluations de candidats ; avec une évaluation de 1 ms, la seule phase d'évaluation en séquentiel nécessite environ 100 secondes, et avec 5 redémarrages, le temps croît de façon quasi linéaire jusqu'à environ 500 secondes. En organisant les traitements par lots et en les confiant à du matériel parallèle, le temps réel dépend principalement du nombre de lots et non du nombre d'individus.