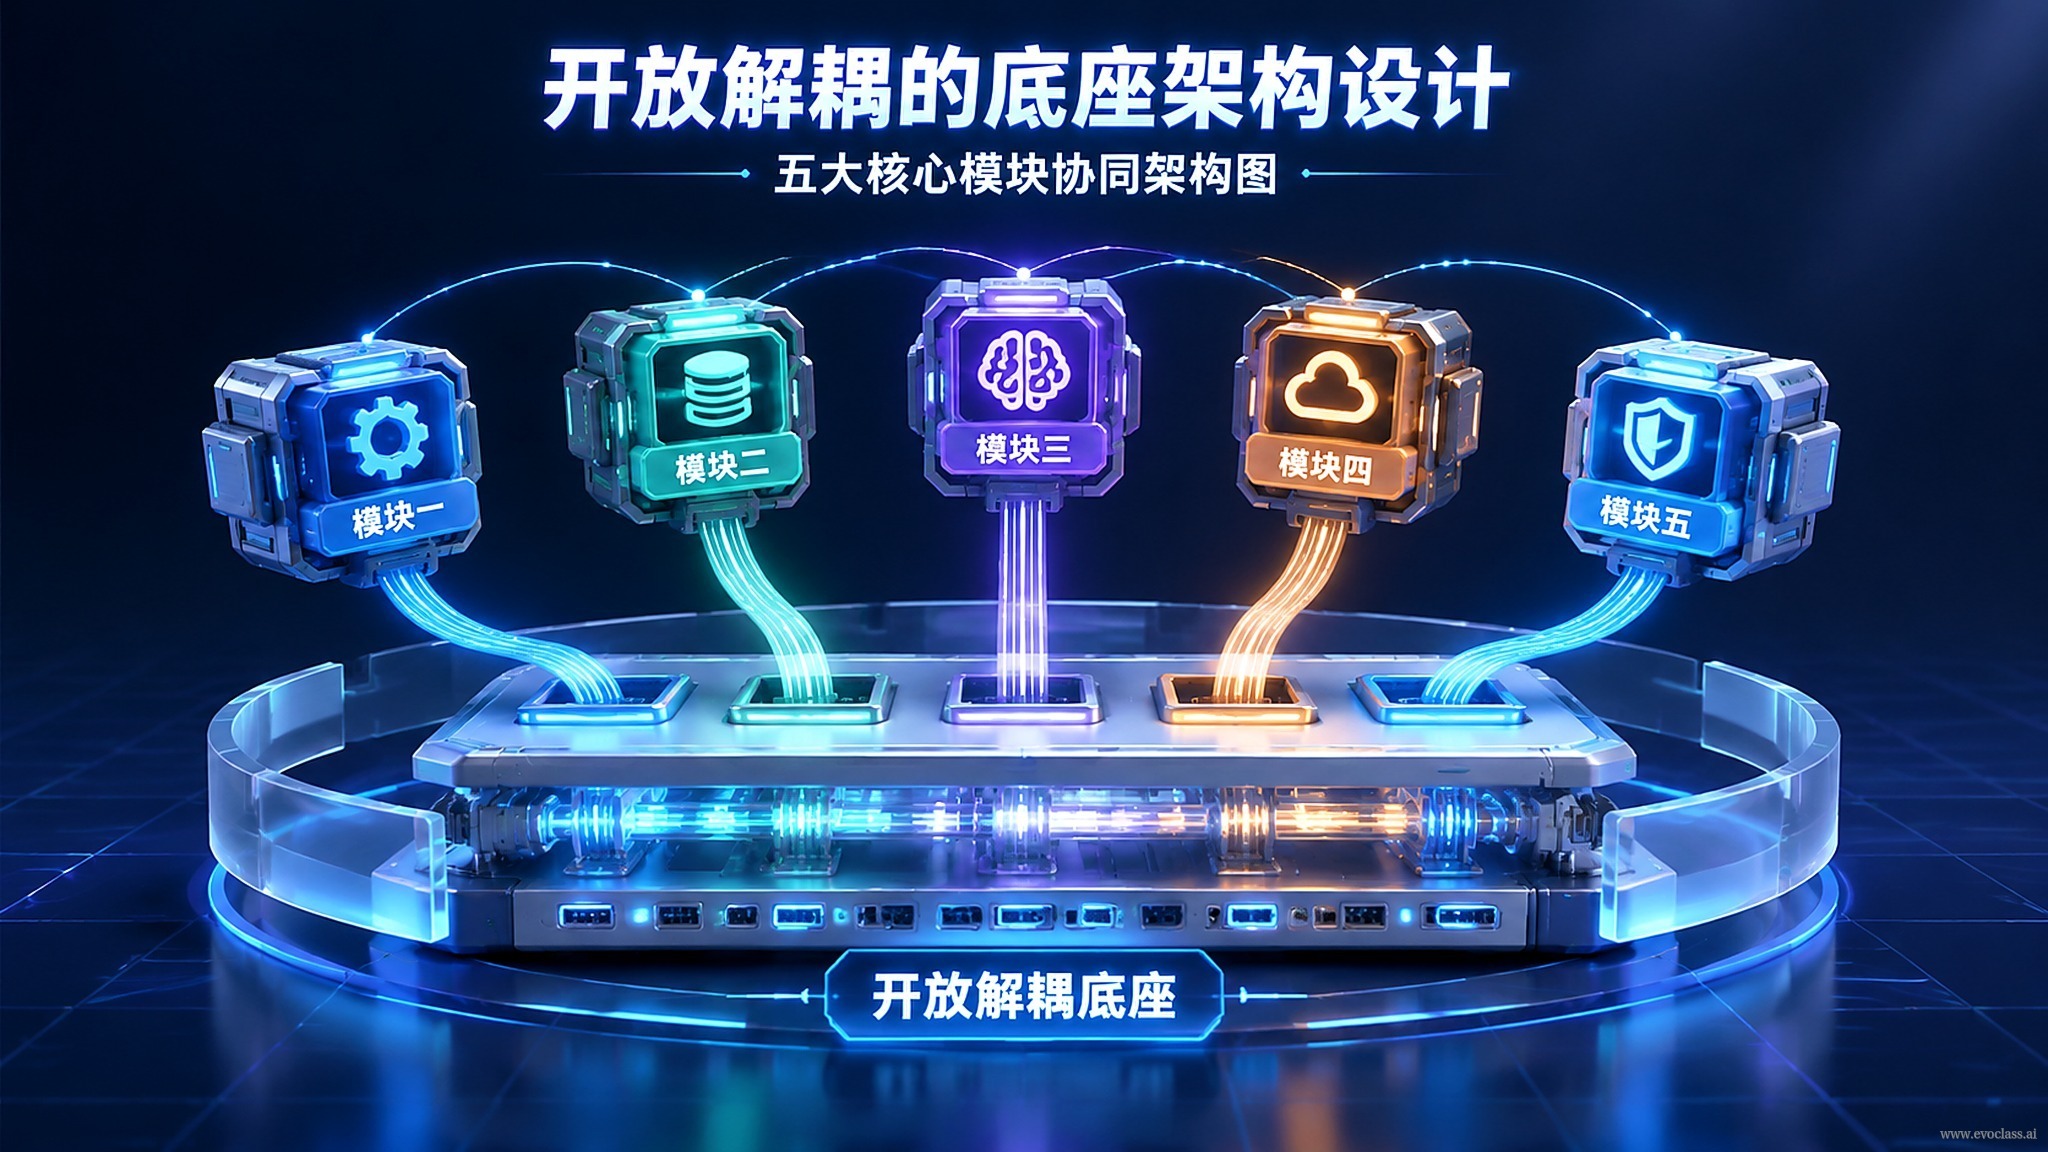
Le principe fondamental d'EvoX est le suivant : les chercheurs ne devraient pas consacrer leur temps à la communication parallèle, à l'allocation des appareils ni à la tolérance aux pannes distribuée. Le système est donc décomposé en cinq modules de premier niveau —algorithmes,problèmes,workflows,moniteurset RuntimeLes quatre premiers répondent aux questions « quoi faire évoluer, comment faire évoluer, comment organiser, comment observer », tandis que le Runtime répond à « où calculer, comment faire tenir le calcul ». Une fois cette frontière clairement établie, les chercheurs n'ont plus qu'à se concentrer sur « comment faire évoluer », le système sous-jacent se chargeant de répartir les calculs vers les GPU, les accélérateurs ou les clusters distribués.
Frontières de responsabilité des cinq modules
- Algorithmes: il décrit uniquement la logique de recherche et de mise à jour (sélection, croisement, mutation, règles de mise à jour), sans être lié à un problème concret ni savoir sur quelle carte les tenseurs sont placés.
- problèmes: il expose une interface d'évaluation unifiée, encapsulant les simulations, fonctions objectif ou environnements métier sous une forme directement appelable par le socle.
- workflows: il organise le processus d'évolution par étapes (initialisation, évolution itérative, critère de convergence, etc.) et détermine « quoi faire d'abord, quoi faire ensuite ».
- moniteurs: il collecte les indicateurs à chaque étape et enregistre l'état de la population ainsi que les courbes de convergence, à des fins d'analyse et de débogage.
- Runtime: en tant que couche d'exécution unifiée, il masque les différences de puissance de calcul hétérogène, répartit les calculs par lots vers les GPU, les accélérateurs ou les clusters distribués, et prend en charge les détails de parallélisme et de communication.
Les bénéfices de transférabilité apportés par le découplage
Ce mode de collaboration par interfaces « forte cohésion, faible couplage » rend les algorithmes et les problèmes mutuellement indépendants, tout comme les problèmes et la puissance de calcul. Lorsqu'un chercheur implémente un nouvel opérateur de mutation, il lui suffit de réaliser la logique d'évolution dans le module d'algorithmes ; le module de problèmes continue de fournir l'interface d'évaluation unifiée, les modules de workflow et de surveillance conservent leur organisation d'origine, et le Runtime répartit automatiquement les calculs tensoriels par lots vers les GPU ou les clusters distribués — sans aucune modification du code d'exécution sous-jacent.
C'est précisément parce que les interfaces sont stables que ce socle peut prendre en charge simultanément l'apprentissage par renforcement, la programmation génétique et l'optimisation combinatoire, entre autres scénarios d'évolution, évitant ainsi de reconstruire une infrastructure d'ingénierie parallèle, d'orchestration et d'exécution distribuée pour chaque domaine. Il convient toutefois de distinguer : ce que le découplage réduit, c'est l'« ingénierie redondante », et non la « puissance de calcul » : l'efficacité réelle de la stratification doit encore être vérifiée par des expériences de référence pour s'assurer que le coût d'orchestration reste acceptable.
Schéma de l'architecture collaborative des cinq modules principaux d'EvoXLe socle EvoX est composé de cinq modules de premier niveau : algorithmes, problèmes, workflows, moniteurs et Runtime : les quatre premiers répondent respectivement à quoi faire évoluer, comment évoluer, comment organiser et comment observer, tandis que le Runtime se charge de répartir les calculs par lots vers les GPU, les accélérateurs ou les clusters distribués. Une fois cette frontière établie, les chercheurs se concentrent uniquement sur la logique d'évolution, la communication parallèle, l'allocation des appareils et la tolérance aux pannes distribuée étant prises en charge de manière unifiée par la couche inférieure.