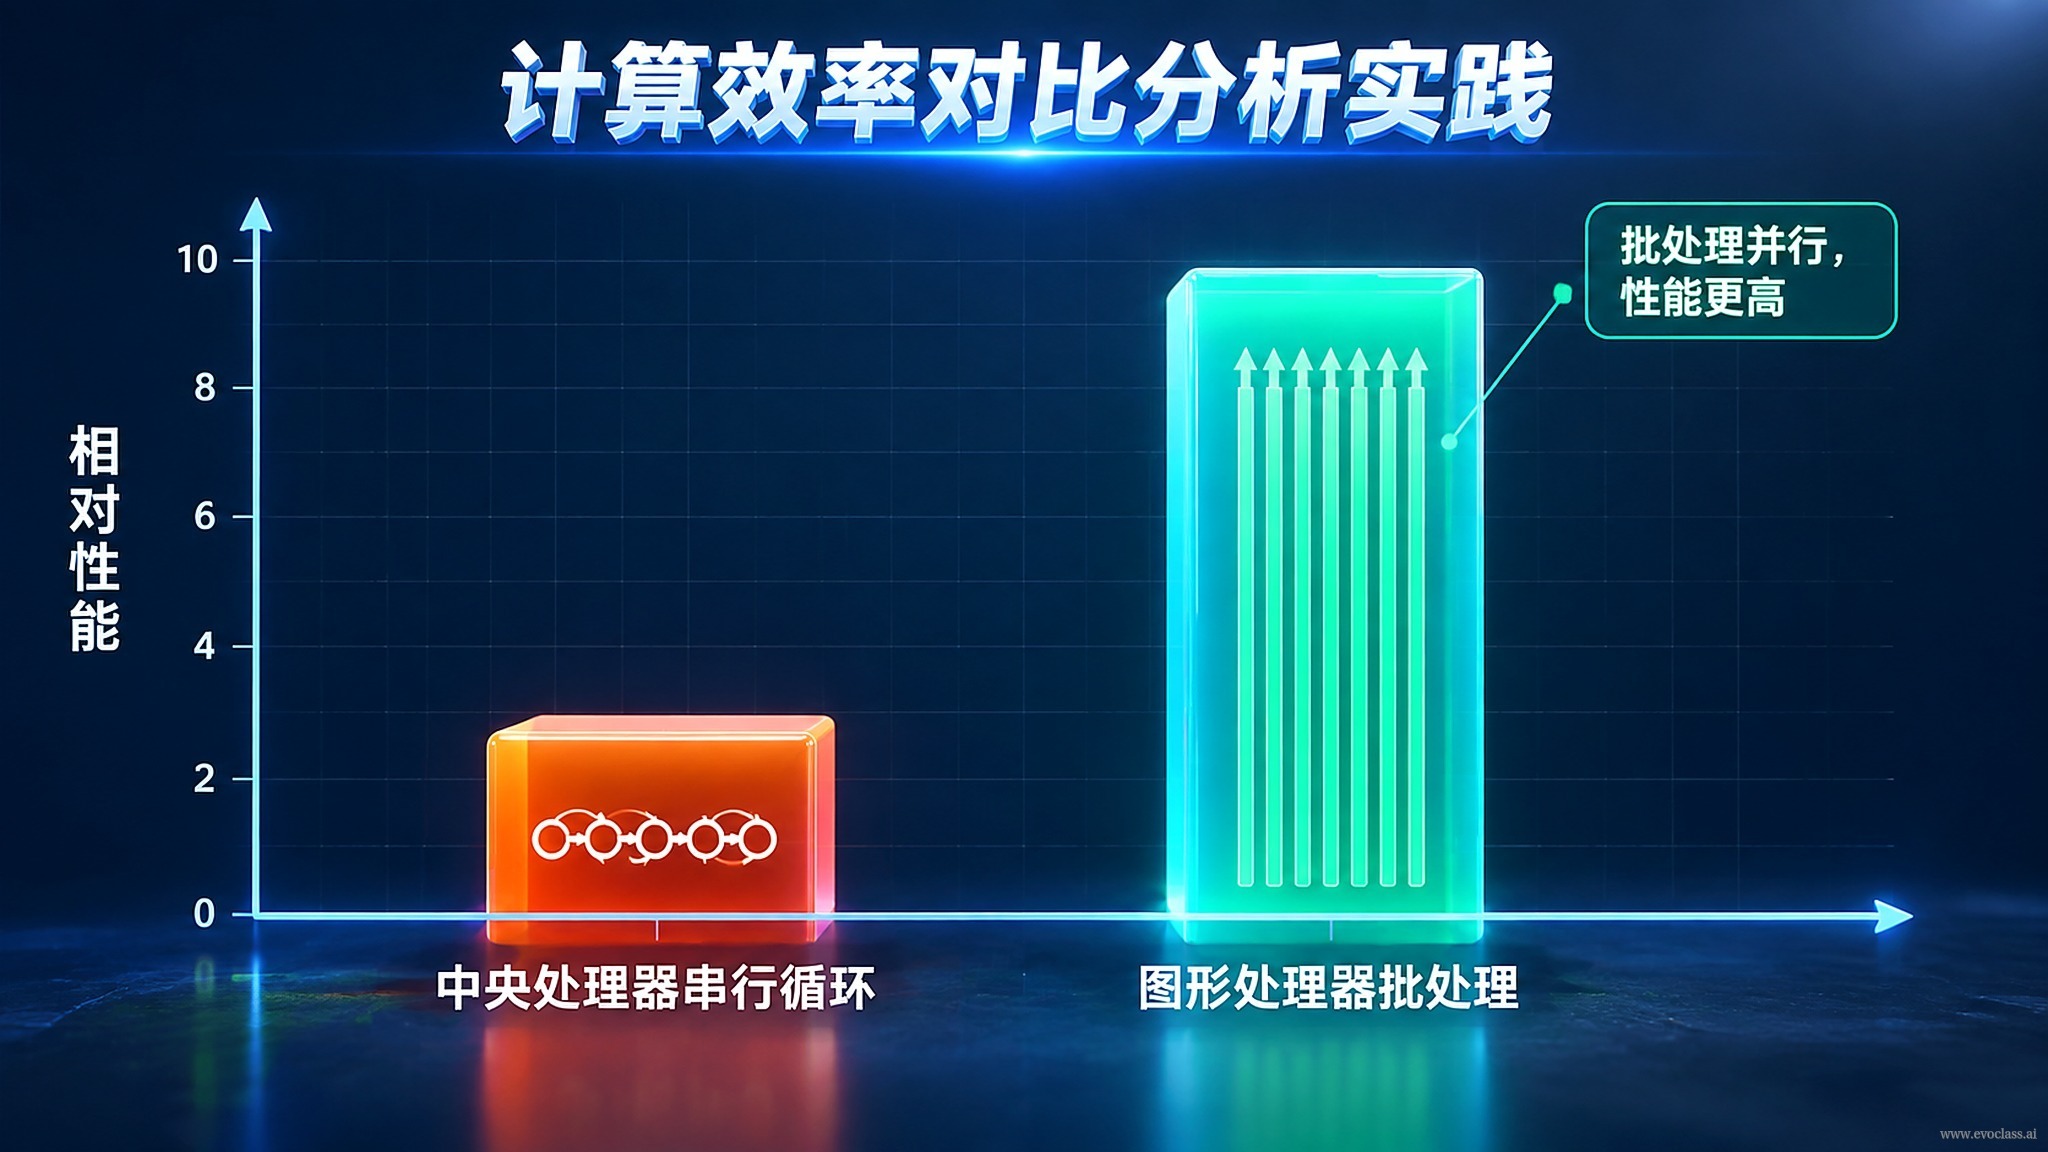
Cette page met la « comparaison de l'efficacité de calcul » en pratique dans une expérience reproductible :comparer l'efficacité de bout en bout, sur une même tâche évolutive, entre l'itération individuelle séquentielle sur CPU classique et le traitement par lots tensoriels sur GPU avec EvoX. L'objectif n'est pas de retenir la conclusion « le GPU est plus rapide », mais de comprendre d'où vient réellement l'accélération apportée par la parallélisation tensorisée, quel en est le coût et où se situent ses limites.
Deux références, une même tâche
- Référence séquentielle CPU: une boucle appelle la fonction d'évaluation individu par individu ; chaque génération nécessite N ordonnancements indépendants, mises à jour d'état et agrégations de résultats. Le contrôle de boucle, le surcoût de l'interpréteur et les accès mémoire dispersés diluent la puissance de calcul utile ; plus le nombre d'individus augmente, plus ces coûts « non calculatoires » pèsent.
- Implémentation tensorielle GPU de référence: EvoX organise la population, les entrées d'évaluation et l'état d'exécution sous forme de tenseurs, exécutant les évaluations et les opérateurs par lots sur le GPU ; un seul appel couvre l'ensemble du pool de candidats, réduisant considérablement les boucles séquentielles et le nombre d'ordonnancements.
Protocole de mesure : rendre la comparaison reproductible
Une comparaison reproductible doitfixer le problème, la taille de population, le nombre de générations et la graine aléatoire, puis enregistrer : le temps réel par génération, la durée totale, le débit (évaluations/seconde), le facteur d'accélération, ainsi que l'utilisation du GPU et l'occupation de la mémoire vidéo. Avant de chronométrer, il fautpréchaufferpour éliminer l'influence de la première compilation et de l'allocation mémoire, et effectuer aux points de mesure unesynchronisation du périphérique, en distinguant le temps de calcul du temps de transfert de données hôte-périphérique. Si l'un de ces éléments manque, le facteur d'accélération obtenu peut être faussé.
D'où vient la différence et par quoi est-elle contrainte
- Source des gains: le parallélisme par lots, les opérateurs tensorisés et le parallélisme intra-périphérique permettent de traiter tout le pool de candidats en un seul appel et d'effectuer davantage d'évaluations par unité de temps.
- Conditions contraignantes: la taille de lot, la dimension du problème, la vectorisabilité de la fonction d'évaluation, le surcoût de copie hôte-périphérique et le surcoût de lancement de noyau influencent tous l'accélération finale. Un lot trop petit voit ses gains absorbés par le surcoût de lancement ; si la fonction d'évaluation ne peut pas être vectorisée, le traitement par lots ne peut guère déployer ses effets.
Conclusion pratique
L'ordre correct est le suivant :vérifier d'abord si la fonction d'évaluation peut être mise en lots, puis comparer les implémentations CPU et GPU. L'avantage d'efficacité doit finalement se traduire par «obtenir davantage de générations ou de solutions candidates pour un même budget de calcul», et c'est sur cette base qu'il faut décider du mode de déploiement et de la conception des expériences, plutôt que de rechercher un simple chiffre d'accélération flatteur.
Comparaison d'efficacité : traitement séquentiel CPU et traitement par lots GPUDans cette comparaison, la référence séquentielle CPU évalue les individus un par un dans une boucle ; chaque génération nécessite N ordonnancements et mises à jour d'état, et les surcoûts de l'interpréteur et des accès mémoire diluent la puissance utile. Le traitement par lots GPU organise la population et les entrées d'évaluation en tenseurs, couvrant tout le pool de candidats en un seul appel. Le facteur d'accélération est contraint par la taille de lot, la vectorisabilité de la fonction d'évaluation et le surcoût de copie hôte-périphérique.