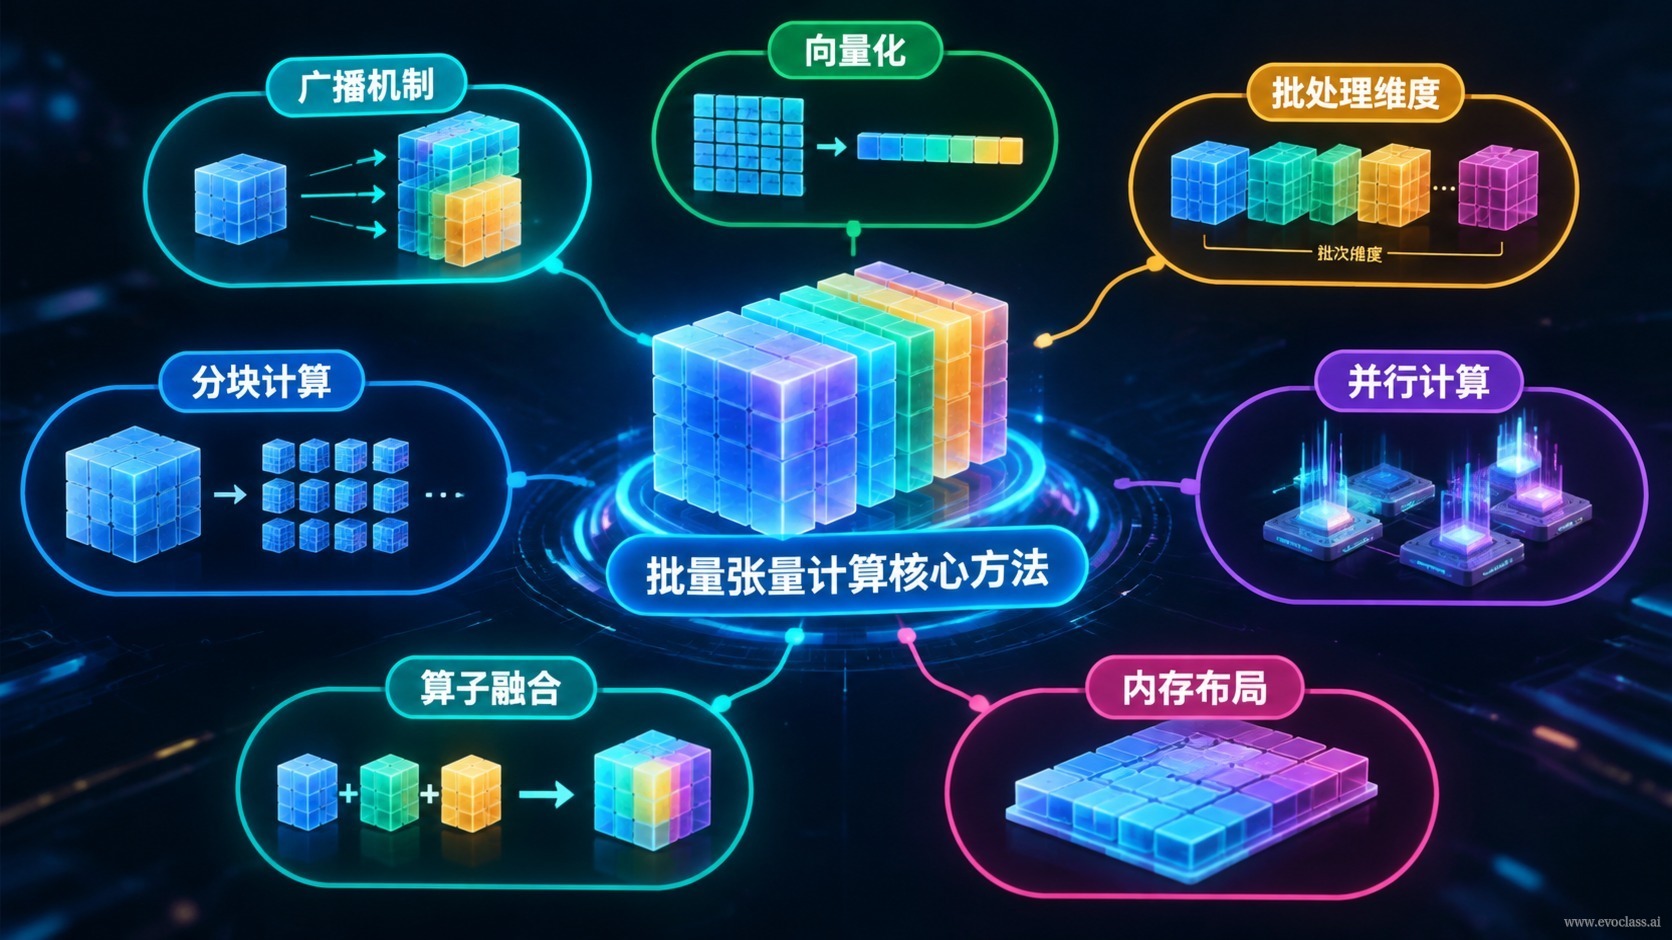
Dans la base tensorielle d'EvoX,le calcul tensoriel par lotsse situe au niveau de l'expression algorithmique : il unifie les candidats, les évaluations et les états de la boucle évolutive en les projetant sous forme detenseurs dotés d'une dimension de lot, puis les confie à des opérateurs par lots adaptés au GPU et à un graphe de calcul compilé pour l'exécution. L'objectif est clair : transformer « l'évolution sérielle individu par individu » en « évolution parallèle de la population entière », afin que la puissance de calcul serve réellement la recherche elle-même plutôt que d'être absorbée par l'ordonnancement et le lancement des tâches.
I. Exprimer le processus évolutif sous forme tensorielle
En convenant que la dimension de lot N représente le nombre de candidats (individus), les trois éléments clés de l'évolution se traduisent directement en tenseurs :
- Tenseur de candidats: la population X est organisée en [N × D], où D est le nombre de variables de décision d'un candidat.
- Tenseur d'objectifs: les objectifs et contraintes F sont organisés en [N × M], où M est le nombre de termes objectif/contrainte ; en cas de multi-objectif, chaque objectif correspond à une colonne distincte de F.
- Variables d'état: la génération, la meilleure valeur courante, le pas, etc. sont maintenus via des tampons scalaires ou de petits tenseurs, plutôt que consignés individu par individu dans des objets Python.
Ainsi, le croisement, la mutation, la sélection et l'évaluation sont tous traités par lots le long de la dimension N, et la boucle évolutive ne comporte plus de branchements ni de flux de contrôle individu par individu.
II. Opérateurs par lots : de N appels par candidat à une seule opération par lots
Trois expressions minimales, faciles à comparer, esquissent la forme fondamentale des opérateurs par lots :
- Mutation: X′ = X + σ·randn(X), toute la population de candidats reçoit ses perturbations aléatoires en une seule opération par lots, σ contrôle l'intensité de la perturbation.
- Sélection: idx = topk(F, k), sélectionne en une seule fois les indices des k meilleurs candidats parmi les aptitudes des N candidats.
- Évaluation: Y = fθ(X), remplace N appels par candidat par une seule passe avant groupée ou une seule simulation par lots.
L'essentiel ne réside pas dans un opérateur précis, mais dans le fait que tous les candidats partagent un même graphe d'opérations tensorielles : un seul appel par lots permet de réduire la surcharge de l'interpréteur et celle du lancement des noyaux, faisant ainsi servir réellement la puissance du GPU ou du calcul multicœur à la recherche évolutive. La gestion des contraintes et des dépassements de bornes peut également s'effectuer au sein de la même opération par lots à l'aide de tenseurs de masque, sans branchement spécifique pour certains candidats.
III. Optimisation du graphe de calcul et indicateurs de débit
Écrire l'évolution sur plusieurs générations sous forme de graphe de flux de données compilable permet d'extraire davantage de performances :Fusion d'opérateursréduit le nombre de lancements de noyaux,Parallélisme intra-lotfait exécuter tous les candidats simultanément,Exécution asynchronefait se chevaucher calcul et transfert de données,Réutilisation mémoireréduit l'allocation de tenseurs intermédiaires. En conséquence, les indicateurs de performance doivent aussi passer de la « latence par étape » audébit en candidats/s ou générations/s: en exécution par lots, un seul appel traite toute la population de candidats, et seul le débit global reflète réellement l'efficacité de la recherche.
Carte mentale des méthodes fondamentales du calcul tensoriel par lotsLa carte mentale exprime le processus évolutif sous forme de tenseurs dotés d'une dimension de lot : la population X est en N×D, les objectifs et contraintes F en N×M, et le croisement, la mutation, la sélection et l'évaluation sont tous traités par lots le long de la dimension N. La mutation, la sélection topk et l'évaluation par passe avant groupée ne nécessitent qu'un seul appel par lots, et les indicateurs de performance passent de la latence par étape au débit en candidats/s.