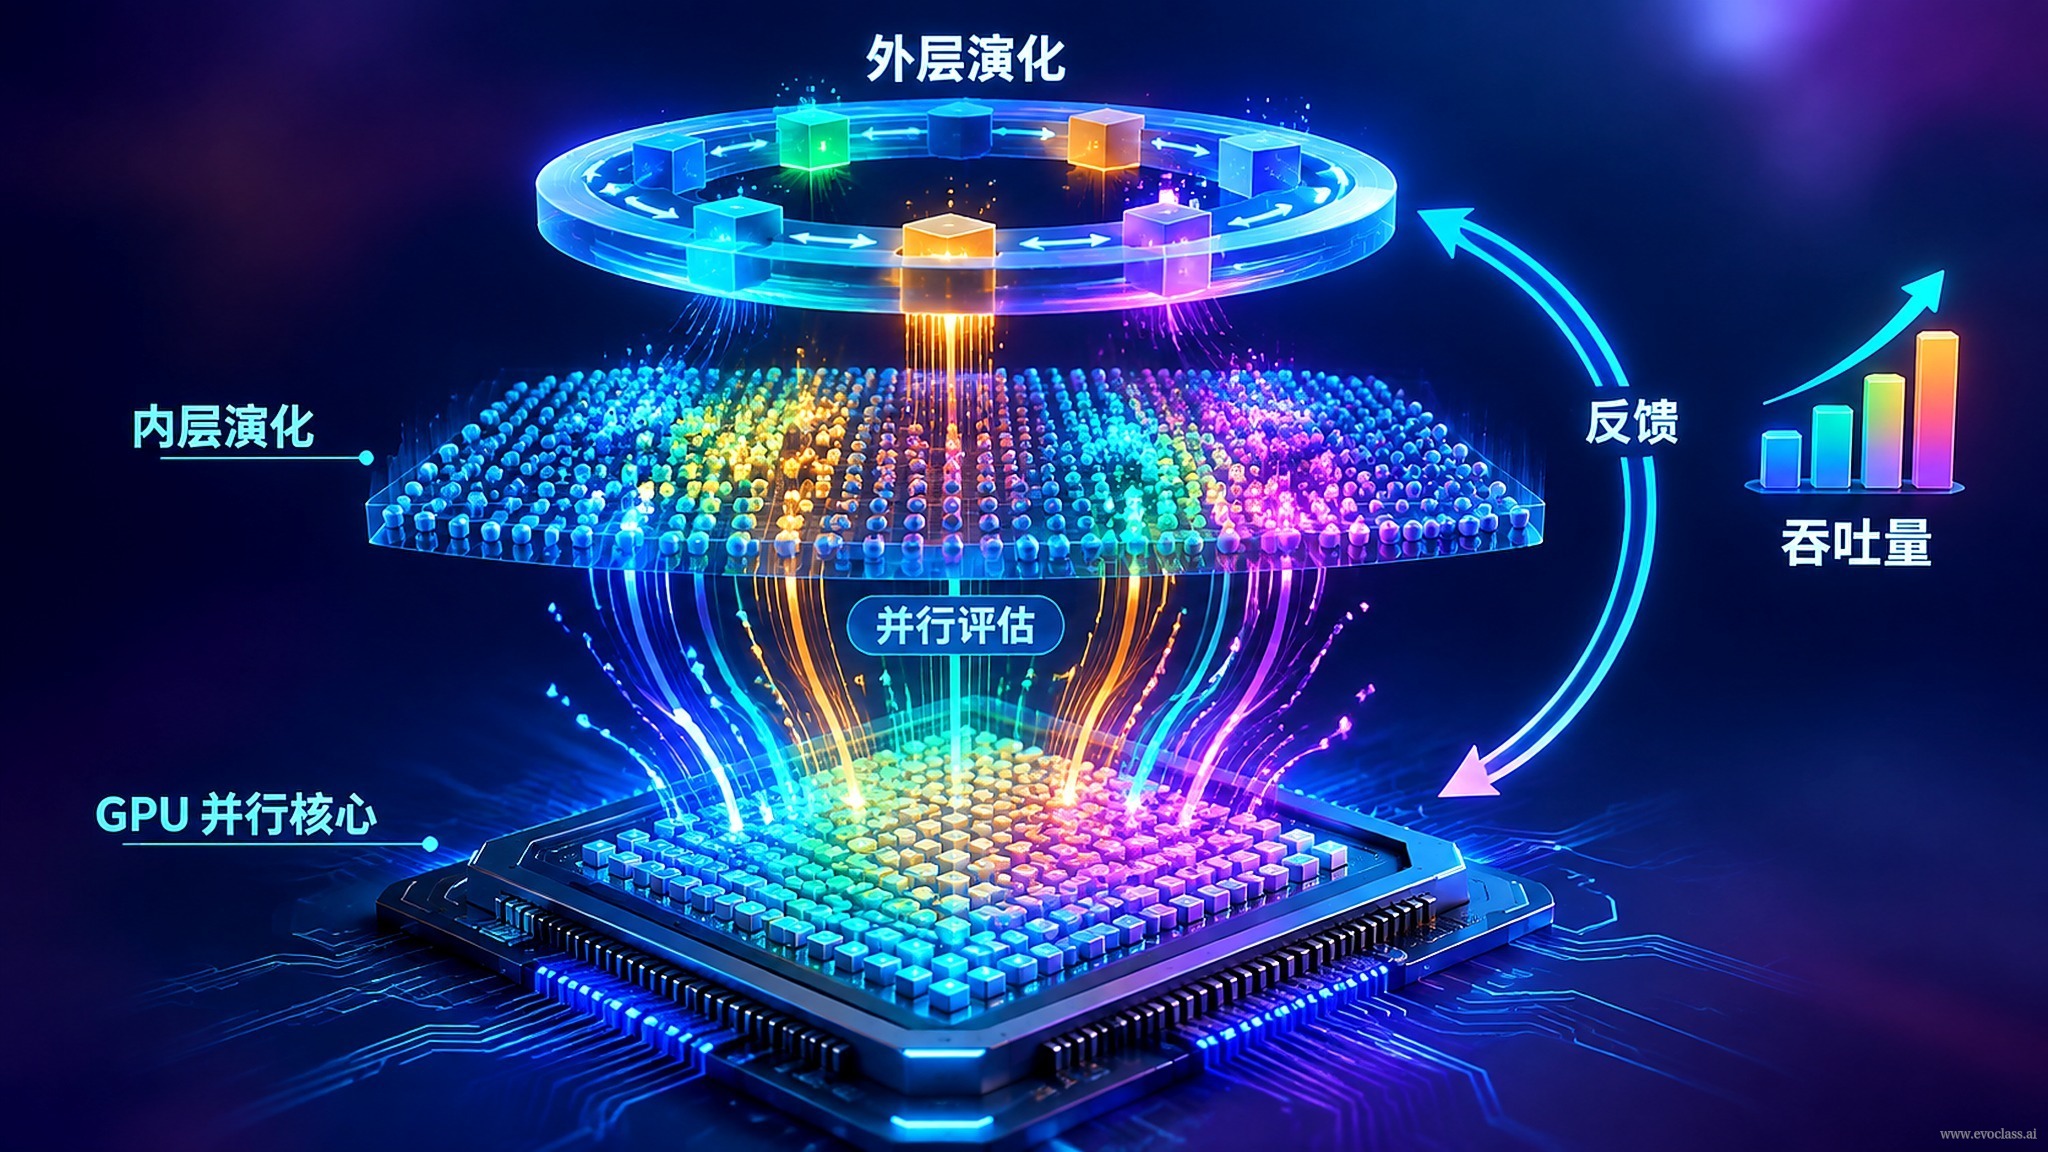
Lorsqu'un algorithme évolutionnaire est utilisé pouraméliorer l'algorithme évolutionnaire lui-même, deux niveaux de calcul coexistent dans le système : le niveau interne correspond à l'exécution et à l'évaluation d'un grand nombre de configurations d'algorithme sur de multiples instances de tâches, tandis que le niveau externe sélectionne, mute et met à jour les configurations à partir de ces résultats d'exécution. Sans une base de parallélisation puissante, l'évolution externe serait ralentie par l'évaluation séquentielle du niveau interne et deviendrait un goulot d'étranglement.La parallélisation GPUest précisément la clé qui transforme « l'amélioration de l'évolution par l'évolution » d'une idée théorique en un processus exécutable à haut débit : les tâches internes s'exécutent en parallèle par lots et produisent en continu des données de performance, et l'évolution externe utilise ces données comme retour d'information pour sélectionner en continu de meilleures configurations d'algorithme.
Chaque niveau a son rôle
- Niveau interne (exécution et évaluation): exécuter par lots sur le GPU un grand nombre de configurations d'algorithme candidates (différents hyperparamètres, opérateurs ou stratégies de recherche) et réaliser l'exécution et l'évaluation pour chaque instance de tâche. La granularité fine et le grand nombre de tâches correspondent parfaitement aux caractéristiques de débit par lots du GPU.
- Niveau intermédiaire (agrégation du retour): agréger les performances brutes d'une multitude de tâches internes en indicateurs statistiques, estimer la qualité de chaque configuration sur l'ensemble de la distribution des tâches et former la fitness utilisée par le niveau externe.
- Niveau externe (sélection de configuration): utiliser le retour statistique comme entrée pour effectuer la sélection, la mutation ou la mise à jour, générer la génération suivante de configurations et la renvoyer au niveau interne, formant ainsi une boucle fermée.
Pourquoi la parallélisation GPU est irremplaçable
Dans une boucle séquentielle traditionnelle, le temps réel d'une itération est déterminé conjointement par le « nombre de configurations candidates × nombre d'échantillons de tâches » ; dès que l'échelle augmente un peu, il devient insoutenable, et la boucle séquentielle devient donc le principal goulot d'étranglement limitant la taille des configurations candidates et des échantillons de tâches. La parallélisation GPU permet à un grand nombre d'algorithmes internes de s'exécuter simultanément, faisant passer la boucle séquentielle de « goulot d'étranglement principal » à « coût de traitement par lots acceptable », élargissant ainsi simultanément l'espace de configuration explorable et le volume d'échantillons de tâches.
Mécanisme central : une boucle fermée
L'ensemble du système peut se résumer à une boucle « débit parallèle des tâches internes → agrégation du retour de performance → sélection de configuration externe » : plus le degré de parallélisme est élevé, plus les échantillons de retour sont abondants, plus l'estimation de la fitness par le niveau externe est stable et plus la direction d'amélioration des configurations est fiable ; les configurations améliorées sont ensuite renvoyées au niveau inférieur pour entrer dans le cycle suivant de débit parallèle. C'est précisément cette boucle fermée qui confère à l'algorithme une capacité d'auto-optimisation continue et qui transforme « l'amélioration de l'évolution par l'évolution » d'une idée théorique en un processus efficient et exécutable.
Architecture de débit évolutionnaire à deux niveaux en parallélisation GPUL'illustration présente une boucle fermée : le niveau interne exécute par lots sur le GPU un grand nombre de configurations d'algorithme candidates et réalise leur évaluation ; le niveau intermédiaire agrège les performances massives du niveau interne en indicateurs statistiques et forme la fitness ; le niveau externe sélectionne, mute et génère la génération suivante de configurations en s'appuyant sur ces données, puis les renvoie au niveau interne. Plus le degré de parallélisme est élevé, plus les échantillons de retour sont denses, plus l'estimation de la qualité des configurations par le niveau externe est stable, et le goulot d'étranglement de l'évaluation séquentielle se réduit alors à un coût de traitement par lots acceptable.