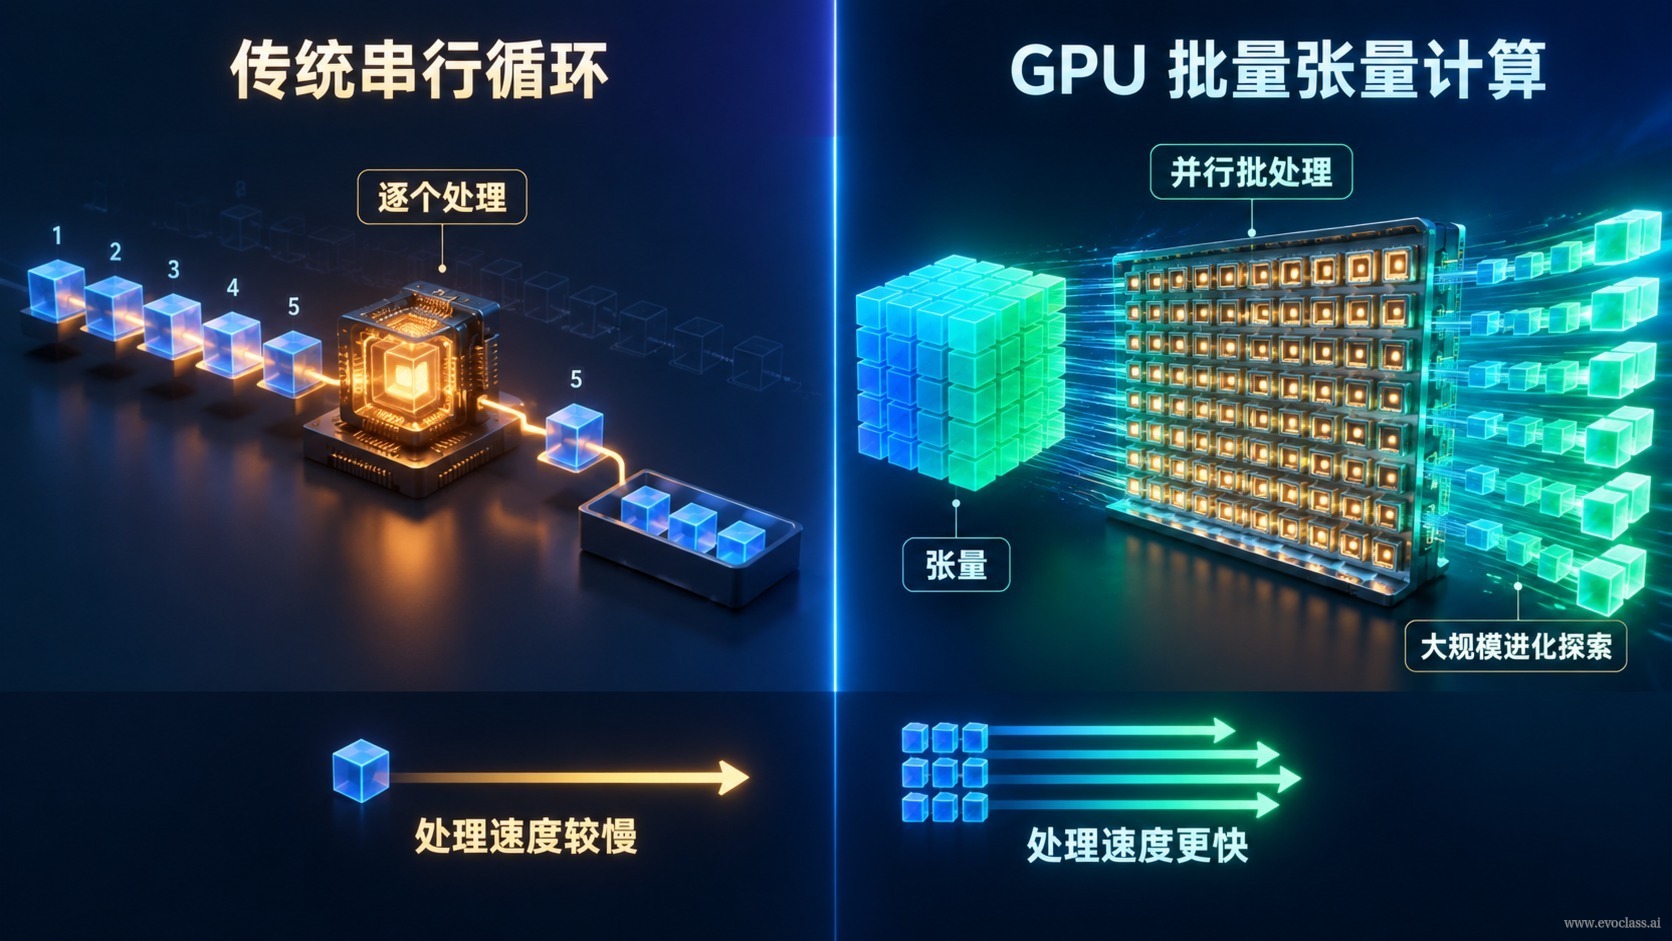
Lorsque la taille de la population passe de quelques dizaines à plusieurs milliers,le calcul évolutionnairen'a plus pour véritable goulot d'étranglement la question de savoir « s'il est possible de trouver une bonne solution », mais plutôt « s'il est possible d'évaluer suffisamment de candidats dans un temps limité ». La réponse d'ingénierie apportée par EvoX repose sur deux axes complémentaires :le calcul tensorielréécrit la boucle séquentielle individu par individu en opérations tensorielles par lots,l'architecture unifiéedécouple quant à elle les algorithmes, les problèmes, les workflows et l'ordonnancement du Runtime, permettant à ce mécanisme parallèle d'être réutilisé pour différents algorithmes évolutionnaires et différentes tâches.
Pourquoi la diversité nécessite du débit
La recherche évolutionnaire repose sur la diversité de la population : plus les candidats sont dispersés, plus la probabilité d'échapper à un optimum local est élevée. Mais « maintenir la diversité » est fondamentalement un problème de puissance de calcul — cela exige que chaque génération puisse évaluer et mettre à jour l'état d'un grand nombre de candidats. Si la méthode de génération des candidats reste fixée manuellement au préalable et que l'évaluation s'effectue encore individu par individu, le système ne peut que répéter des schémas prédéfinis, et les bénéfices de la diversité sont annulés par le goulot d'étranglement du débit de calcul.
L'évolution des méthodes : intégrer « la méthode qui produit les candidats » dans l'évolution
Une fois la puissance de calcul débloquée, EvoX fait monter d'un niveau l'objet de l'optimisation : il ne s'agit plus seulement de résoudre un problème, mais d'intégrer la méthode qui produit les solutions candidates elle-même comme objet d'évolution — c'est ce qu'on appellel'évolution des méthodes. Prenons MetaDE comme exemple : l'algorithme interne résout la tâche réelle, tandis que l'algorithme externe fait évoluer la configuration et la stratégie de l'algorithme interne (par exemple la stratégie de mutation et les hyperparamètres de l'évolution différentielle), et exécute en parallèle sur GPU un grand nombre de tâches internes, de sorte que les performances des tâches guident en retour le choix de la configuration externe ;AutoPSO et EvoGO franchissent ensuite le pas en combinant des composants d'essaim particulaire et en apprenant la génération de candidats à partir de retours historiques, passant ainsi du « réglage de paramètres » à la « modification de la structure de l'algorithme ». Cette double évolution interne-externe exige naturellement qu'un grand nombre de tâches internes soient évaluées et mises à jour par lots au sein d'une même génération, voire au même instant, ce qui impose des exigences accrues en matière de débit de calcul et de capacité de parallélisation.
Le graphe de calcul tensoriel : remplacer les boucles par des tenseurs par lots
La boucle CPU séquentielle traditionnelle exécute généralement « évaluation — enregistrement — mise à jour » individu par individu, ne déclenchant à chaque fois que des opérateurs de petite taille, ce qui engendre trois types de coûts :un coût d'ordonnancement élevé,la fragmentation des opérateurs,une sous-utilisation du GPU. L'approche du graphe de calcul tensoriel consiste à organiserla maintenance de la population, l'évaluation par lots et la mise à jour d'étatdans leur ensemble sous forme d'opérations tensorielles par lots, permettant de calculer en parallèle les candidats d'une même génération, voire de plusieurs générations. Par exemple : lorsqu'une même génération contient N solutions candidates, l'implémentation séquentielle boucle individu par individu, tandis que l'implémentation tensorielle organise la population en un seul tenseur, réalisant en une seule fois l'évaluation par lots et la mise à jour d'état parallèle, ce qui réduit considérablement le coût d'ordonnancement et augmente le taux d'occupation du GPU.
L'architecture unifiée : rendre le mécanisme parallèle réutilisable
Réécrire simplement les boucles en tenseurs ne suffit pas — si les algorithmes, les problèmes et la logique d'ordonnancement sont couplés entre eux, changer d'algorithme évolutionnaire ou de type de tâche oblige à tout réécrire. L'architecture unifiée découpleles algorithmes, les problèmes, les workflows et l'ordonnancement du Runtimeet d'autres modules, permettant au mécanisme parallèle tensoriel d'être réutilisé pour différents algorithmes évolutionnaires et tâches (tels que les scénarios d'évolution de méthodes comme MetaDE et AutoPSO) ; associée àl'ordonnancement de puissance de calcul hétérogène, elle permet une gestion des ressources CPU, GPU et autres au niveau des tâches par lots, soutenant ainsi une exploration parallèle composable et extensible.
Pourquoi il s'agit d'une capacité de niveau « socle »
Le socle d'ingénierie apporté par les GPU et les grands modèles fait passer le calcul tensoriel par lots d'une optimisation locale à une capacité fondamentale soutenant l'exploration évolutionnaire à l'échelle du système. Autrement dit, le calcul tensoriel résout le « aller vite », tandis que l'architecture unifiée ouverte et découplée résout le « pouvoir changer » : le premier fournit le débit, la seconde fournit une frontière de réutilisation composable et extensible. C'est leur combinaison qui permet à l'exploration évolutionnaire parallèle intensive et hautement diversifiée de devenir véritablement une capacité d'ingénierie.
Comparaison entre la boucle séquentielle et l'architecture de calcul tensoriel par lots sur GPUÀ gauche, la boucle CPU séquentielle traditionnelle exécute « évaluation — enregistrement — mise à jour » individu par individu, ne déclenchant que des opérateurs de petite taille, ce qui entraîne un coût d'ordonnancement élevé, une fragmentation des opérateurs et une sous-utilisation du GPU ; à droite, la maintenance de la population, l'évaluation par lots et la mise à jour d'état sont organisées dans leur ensemble sous forme d'opérations tensorielles, réalisant en une seule fois le calcul des candidats d'une même génération, voire de plusieurs générations, et découplées de l'ordonnancement du Runtime, ce qui permet au mécanisme parallèle d'être réutilisé pour différents algorithmes et tâches.