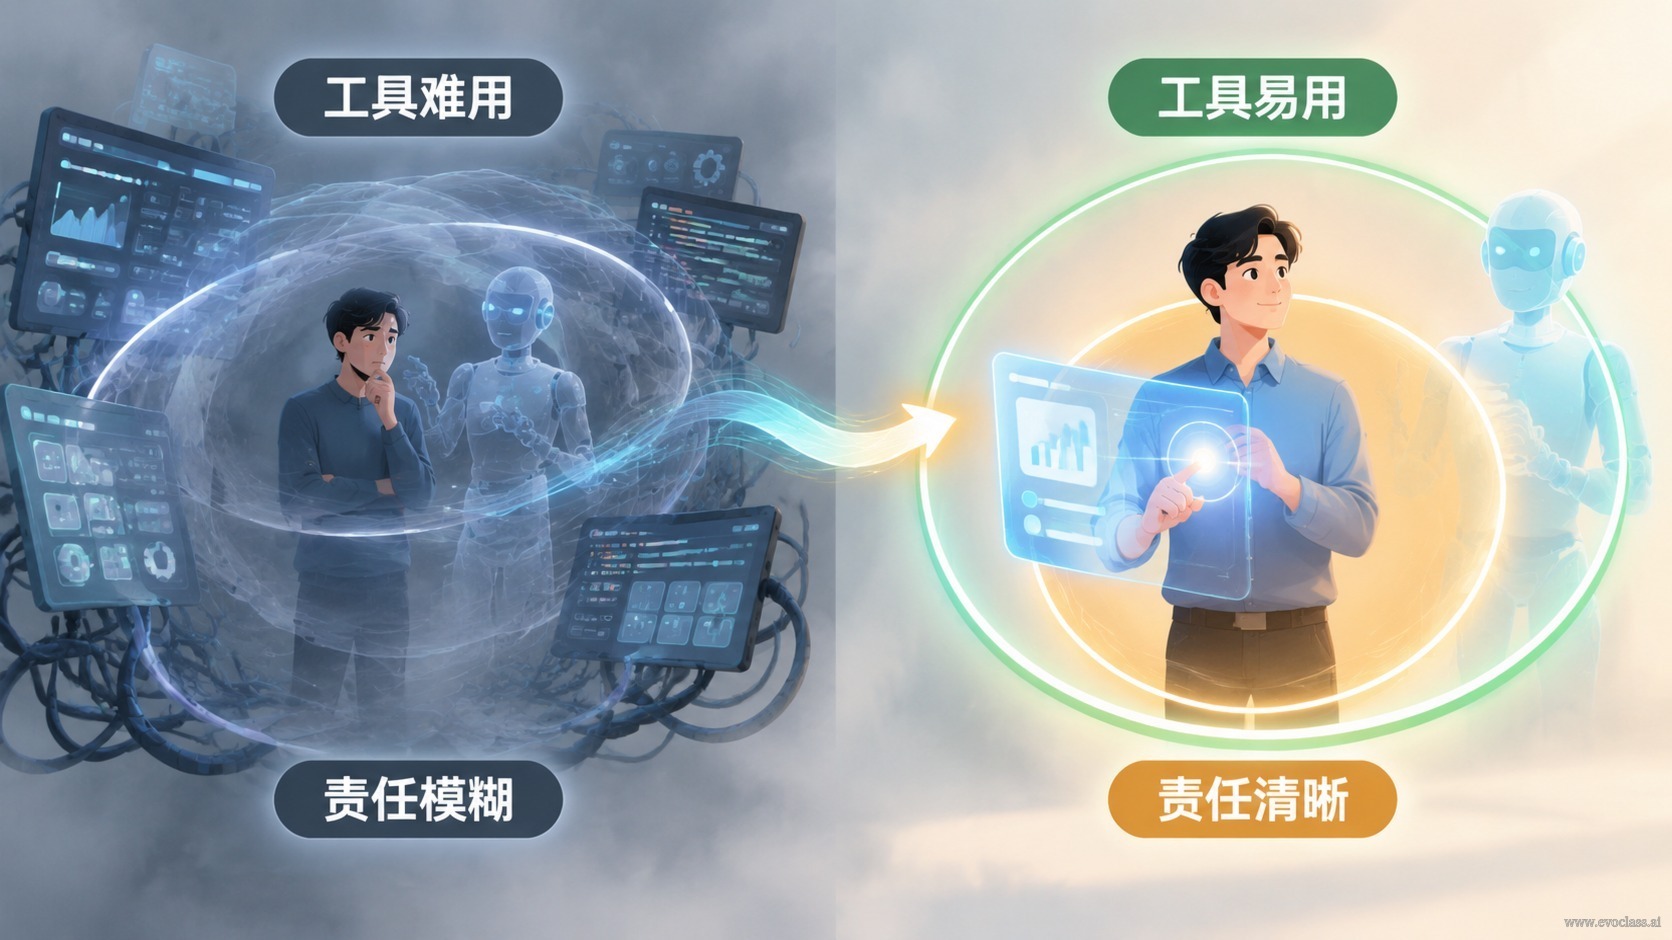
Lorsque l'IA et EvoX réduisent à presque rien le coût d'exécution du parcours « idée → code → expérience », l'illusion la plus fréquente consiste à croire que le jugement devient lui aussi bon marché. C'est exactement l'inverse —Plus l'outil est facile à utiliser, plus la responsabilité humaine est claire. Le modèle peut rapidement transformer une idée en implémentation candidate fonctionnelle, mais il ne peut pas décider à la place du chercheur si cette idée vaut la peine d'être étudiée, si l'objectif est pertinent ou si la comparaison est équitable.
Transfert de responsabilité : de l'implémentation à la définition et à la décision
- Baisse du coût d'exécution ≠ Disparition du coût du jugement: l'IA et EvoX accélèrent la génération de code et les cycles d'expérimentation, mais le choix du problème, la définition des objectifs et les critères d'évaluation restent à la charge de l'humain. Faire tourner le code ne produit qu'une modification candidate ; cela ne vaut pas validation d'une conclusion scientifique.
- Trois catégories de jugements non externalisables: la question vaut-elle la peine d'être étudiée ; l'objectif est-il pertinent ; la comparaison est-elle équitable. Ces trois éléments sont des conditions préalables à la validité scientifique et constituent des points de décision qu'aucun système automatisé ne peut remplacer.
- La frontière de la responsabilité se révèle avec l'automatisation: plus l'outil est puissant, plus il faut clarifier quelles décisions sont proposées par l'Agent, lesquelles doivent être approuvées par l'humain et quels critères de validation sont non négociables. La passerelle de validation de Genesis formalise cette frontière : une modification candidate doit passer la compilation, les tests, les vérifications comportementales et la validation de niveau supérieur pour entrer dans l'historique du projet.
La validité des résultats prime sur le succès d'exécution
Dans les expériences EvoX multi-objectifs, l'Agent peut rapidement générer des solutions candidates, régler les paramètres en lot et tracer de belles courbes de convergence ; mais il revient au chercheur d'examiner une à une les questions suivantes : la fonction objectif représente-t-elle un besoin réel, la diversité des candidats est-elle masquée par un indicateur unique, les modes d'échec sont-ils présentés de façon sélective. La véritable valeur de l'outil est de permettre aux implémentations de faible valeur d'être éliminées plus vite, et aux jugements de grande valeur de devenir plus tôt le goulot d'étranglement — c'est précisément là que se situe l'expertise du chercheur.
Frontière de responsabilité dans la collaboration humain-IACette figure illustre la frontière de responsabilité dans la collaboration humain-IA : l'IA et EvoX compressent le coût d'exécution de l'idée au code puis à l'expérience, tandis que la décision sur la pertinence de la question, la justesse de l'objectif et l'équité de la comparaison reste humaine. Une modification candidate doit franchir la passerelle de compilation, de tests, de vérifications comportementales et de validation de niveau supérieur pour entrer dans l'historique du projet ; la validité des résultats prime sur le succès d'exécution.