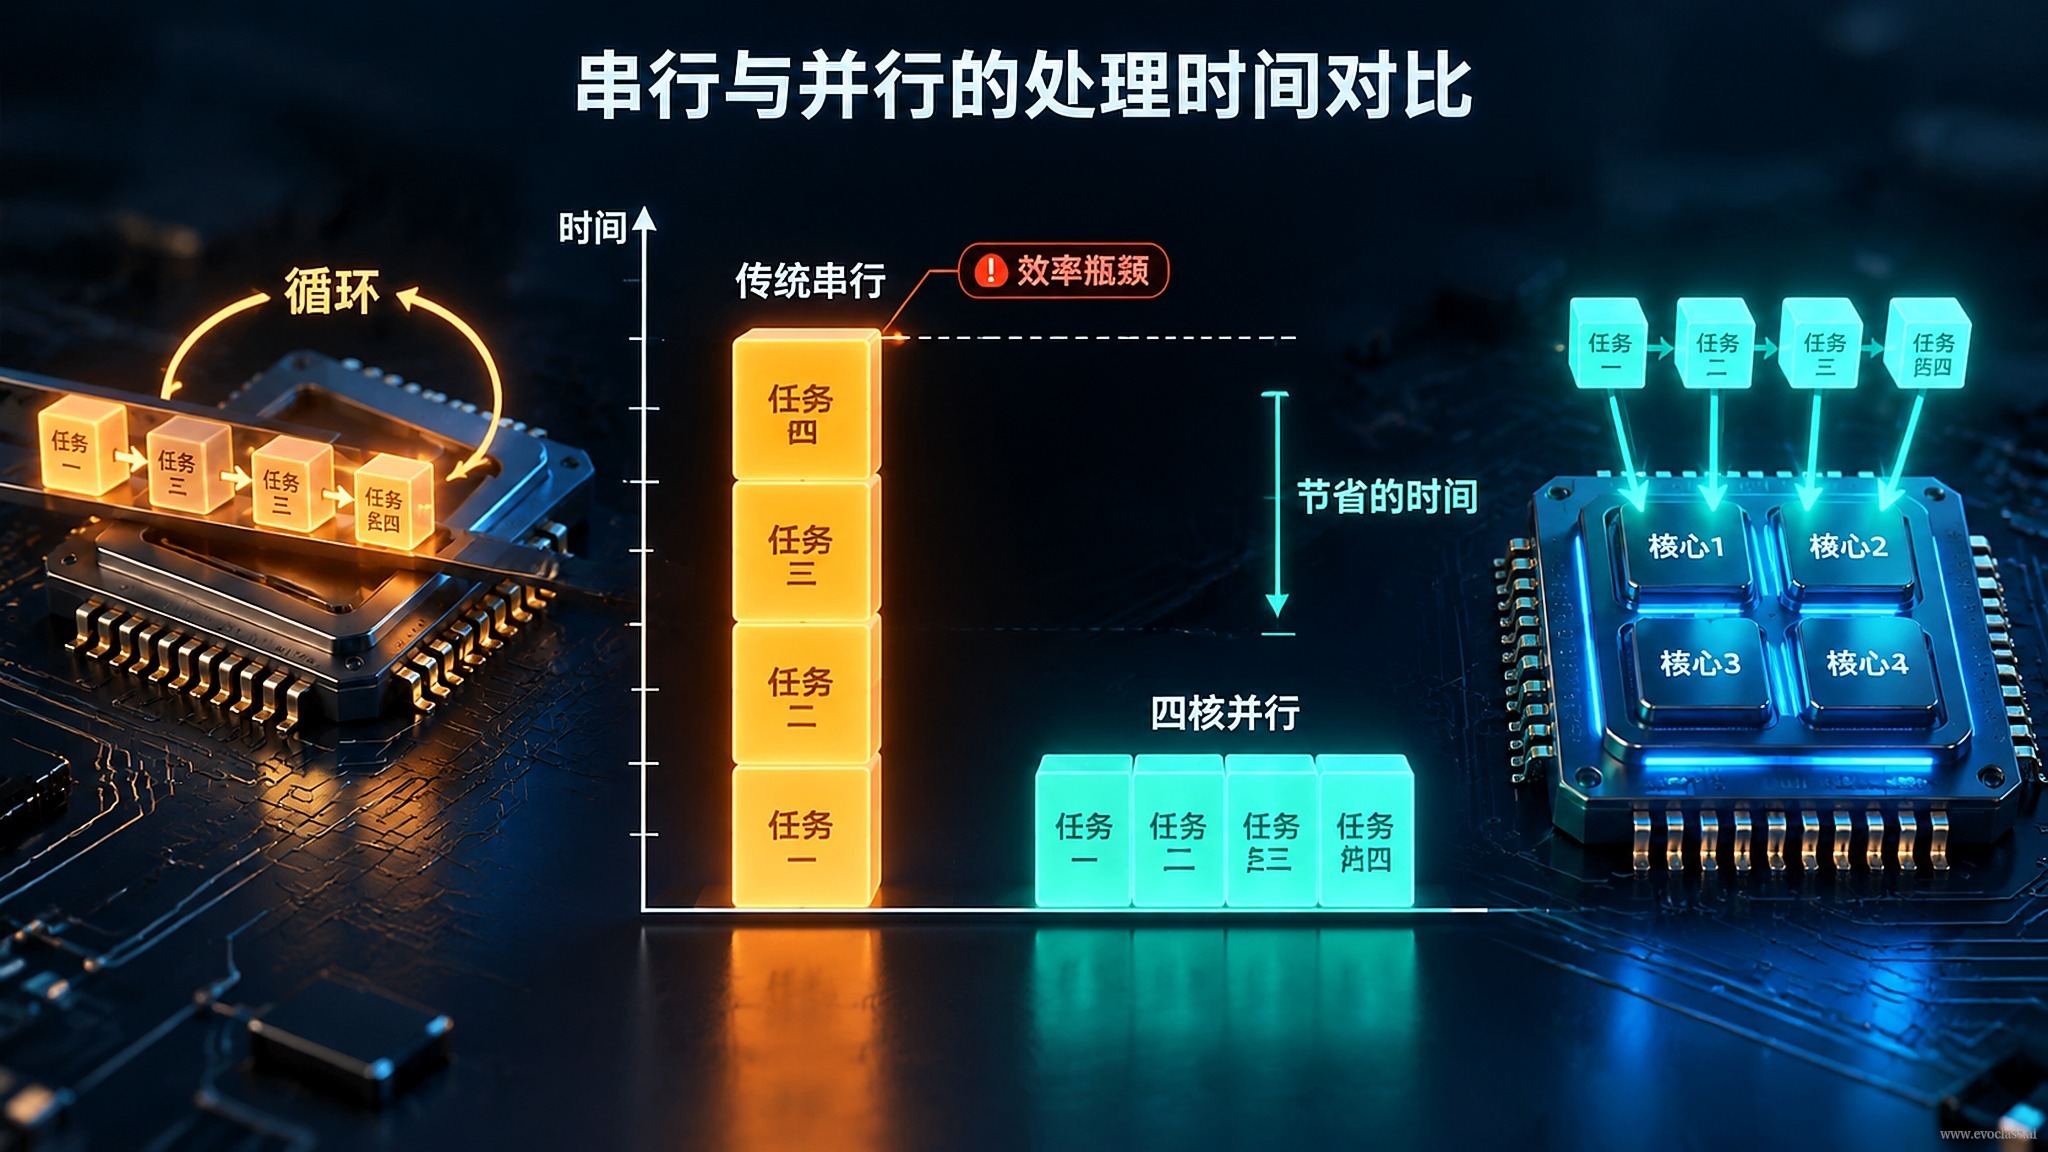
Proses evolusi bergantung pada keragaman populasi, dan keragaman berarti pertumbuhan berlipat ganda pada ukuran populasi serta jumlah evaluasi. Ketika evaluasi kandidat mencapai puluhan ribu kali,loop CPU serial tradisionalmenjadi bagian tersempit di seluruh alur: ia hanya memproses satu individu dalam satu waktu, sehingga kemampuan paralel perangkat keras hampir tidak terpakai.
Satu per satu: model eksekusi loop serial
Implementasi paling sederhana adalah memperlakukan seluruh populasi sebagai sebuah list, lalu mengambil individu satu per satu dengan loop: ambil individu → dekode menjadi parameter konkret → panggil fungsi evaluasi → tulis kembali nilai fitness. Iterasi yang berdekatan hampir tidak dapat tumpang tindih: tanpa hasil evaluasi, penulisan kembali tidak dapat dilanjutkan; tanpa penyelesaian penulisan kembali, individu berikutnya tidak punya tempat untuk menampung hasilnya. Akibatnya unit paralel seperti multi-core, SIMD, dan GPU sebagian besar waktu menganggur, hanya bisa melihat satu individu menyelesaikan prosesnya di alur.
Dari mana sebenarnya biaya itu berasal
- Jumlah evaluasi yang membengkak secara linear: total evaluasi kira-kira sama dengan ukuran populasi × jumlah generasi; saat mencapai orde 10⁵, waktu wall-clock serial tumbuh hampir linear.
- Eksekusi satu per satu di lapisan interpreter: loop per individu, pemeriksaan batas, dan pengiriman tipe menghasilkan biaya konstan yang tetap namun mahal.
- Akses memori tidak berurutan dan pemindahan data: individu yang diambil satu per satu sering kali tidak berurutan di memori, tingkat cache hit rendah, dan biaya pemindahan harus dibayar berulang kali.
- Sinkronisasi dan penjadwalan: untuk mengambil individu berikutnya, alur eksekusi harus berhenti dan dilanjutkan berulang kali.
Mengonversi skala menjadi waktu
Sebagai contoh, dengan populasi 1000 dan 100 generasi, totalnya sekitar 100 ribu evaluasi kandidat. Jika satu evaluasi rata-rata memerlukan 1 ms, tahap evaluasi saja secara serial membutuhkan sekitar 100 detik, belum termasuk biaya komputasi operator dan penjadwalan; jika untuk menjaga keragaman jumlah restart ditingkatkan dari 1 menjadi 5 kali, biayanya naik hampir linear menjadi sekitar 500 detik. Dengan beban kerja yang sama, jika diorganisir per batch dan ditangani perangkat keras paralel, waktu wall-clock terutama ditentukan oleh jumlah batch, bukan jumlah individu.
Kapan bottleneck ini akan menyempit
Kondisi batas juga penting: ketika satu evaluasi sangat murah (skala mikrodetik) atau populasi sangat kecil (di bawah ratusan), biaya penjadwalan dan memori bisa melebihi biaya komputasi, selisih antara serial dan paralel menyempit secara signifikan, manfaat marginal tensorisasi menurun, dan bottleneck akan berpindah ke granularitas penjadwalan serta bandwidth memori. Karena itu, apakah model eksekusi layak dirombak perlu dievaluasi dengan mempertimbangkan biaya evaluasi dan skala secara bersamaan.
Perbandingan waktu proses serial vs paralelSebagai contoh, dengan populasi 1000 dan 100 generasi, totalnya sekitar 100 ribu evaluasi kandidat; jika satu evaluasi memerlukan 1 milidetik, tahap evaluasi saja secara serial membutuhkan sekitar 100 detik, dan dengan 5 kali restart naik hampir linear menjadi sekitar 500 detik. Setelah diorganisir per batch dan diserahkan ke perangkat keras paralel, waktu wall-clock terutama ditentukan oleh jumlah batch, bukan jumlah individu.