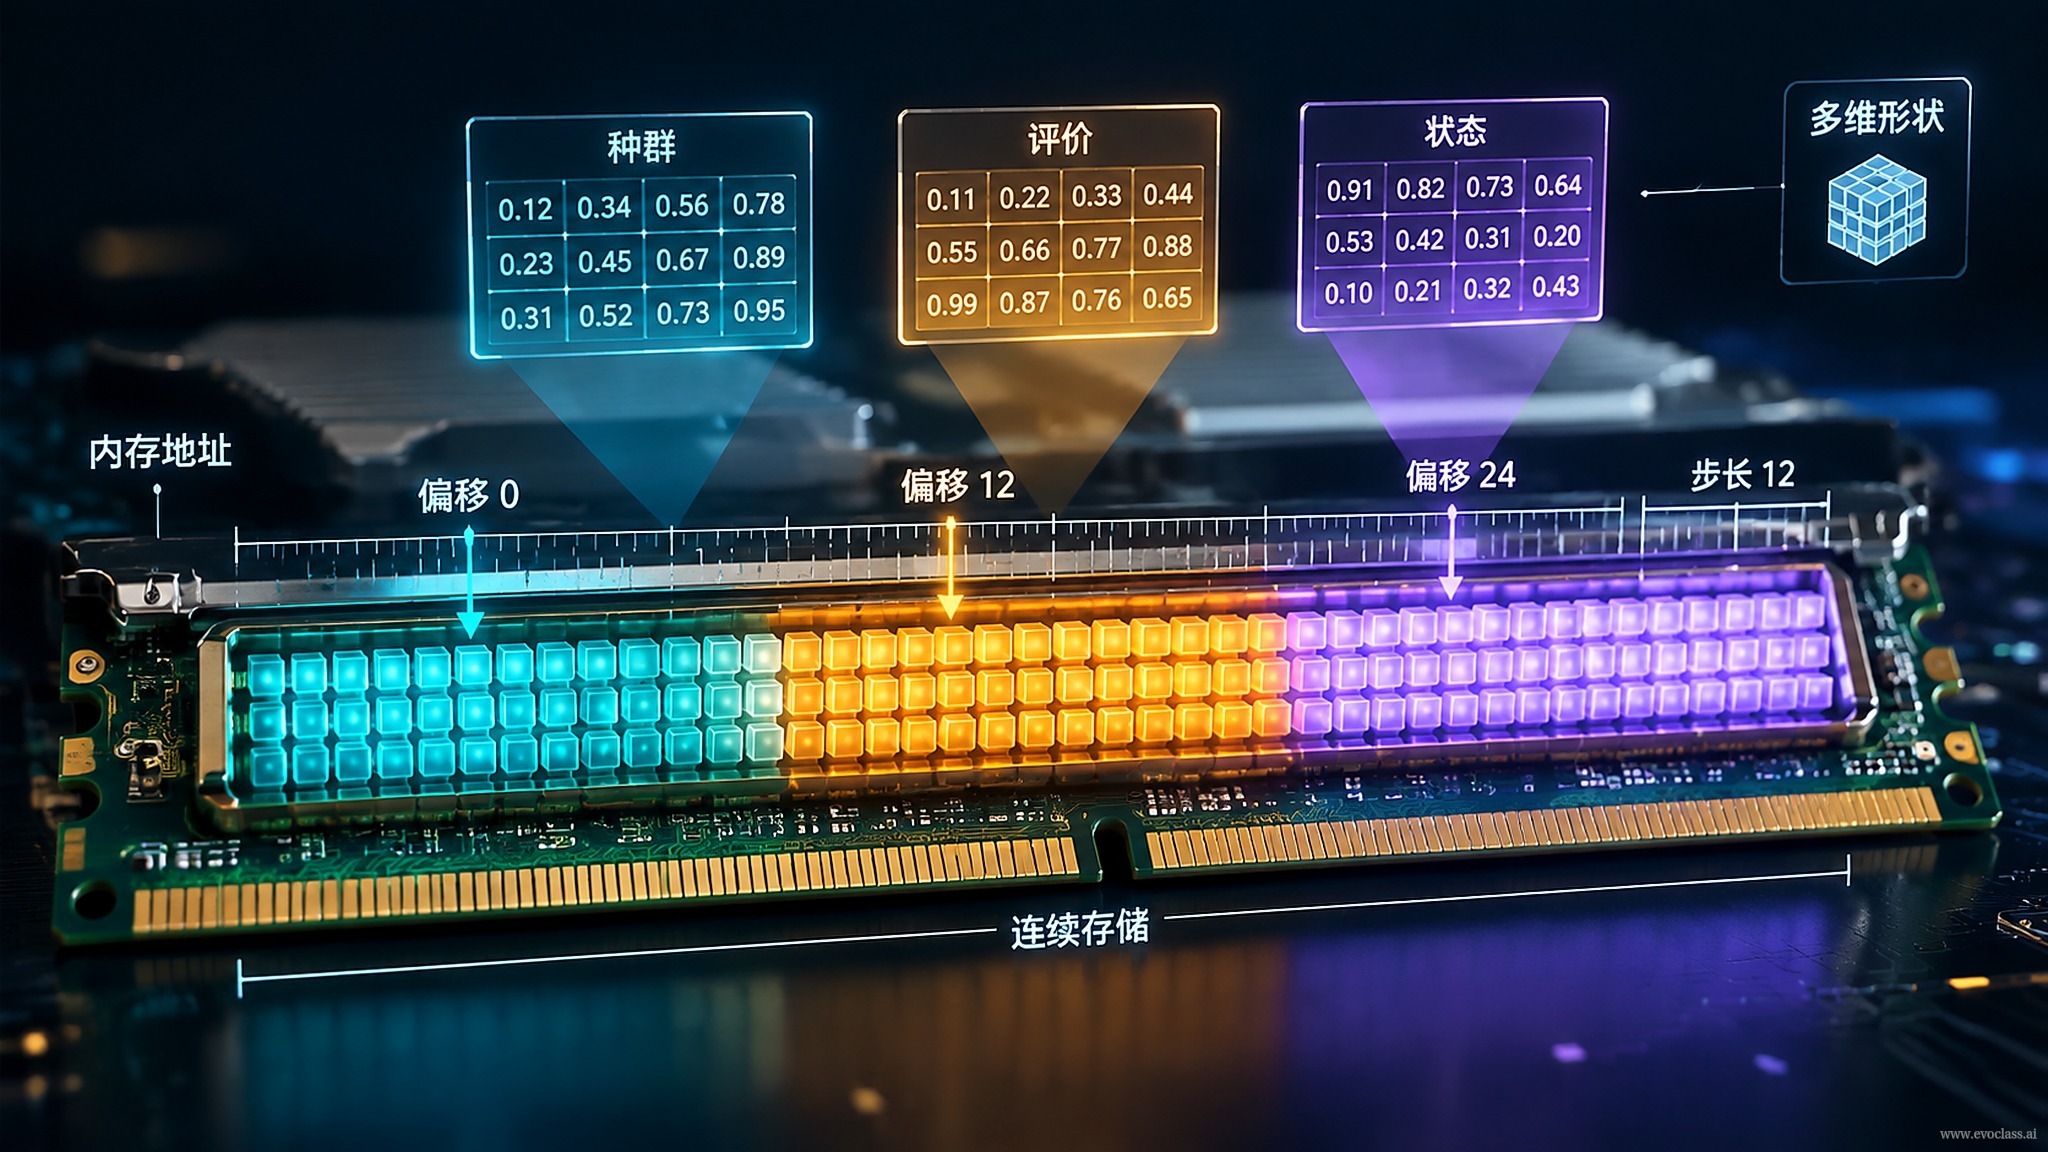
Dalam implementasi rekayasa algoritma evolusi,organisasi berbasis tensormemetakan secara seragam pertanyaan “apa itu populasi, bagaimana hasil evaluasinya, dan sejauh mana proses berjalan” dari objek dan daftar yang tersebar menjadi tensor yang teratur. Intinya adalah membangun kontrak data yang terpadu untuk populasi, evaluasi, dan status, sehingga komputasi batch, penempatan di perangkat, dan penjadwalan paralel selanjutnya memiliki semantik memori yang sama.
Tensorisasi Populasi: Dikodekan sebagai [N, D]
Mengorganisasi N solusi kandidat berdasarkan dimensi batch menjadi tensor pengkodean berbentuk [N, D]. Variabel kontinu, variabel diskret, atau pengkodean multi-segmen dapat dinyatakan sebagai tensor bidang atau blok terkelompok, dengan tetap menjaga keseragaman tipe data dan lokasi perangkat.
- Dimensi batch di luar: umumnya menempatkan N di lapisan terluar, agar operator yang sama dijalankan secara tervektorisasi pada seluruh batch.
- Pemblokan bidang: jika individu terdiri dari beberapa segmen parameter, dapat dipecah menjadi [N, D1] + [N, D2] + … dan tetap tersimpan secara berurutan.
- Penanganan panjang variabel: individu dengan panjang variabel ditangani dengan padding plus mask atau bucketing, untuk mencegah struktur heterogen mengganggu komputasi batch.
Matriksisasi Hasil Evaluasi: [N, M] dan [N, K]
Satu evaluasi batch menghasilkan matriks fitness [N, M]; multi-tujuan, multi-kendala, dan metrik tambahan dapat digabungkan menjadi [N, M+K] atau disimpan dalam tabel terpisah, untuk menghindari pemanggilan fungsi evaluasi secara berulang per individu.
Pengelolaan Terpadu Tensor Status
Generasi, status bilangan acak, hyperparameter strategi, solusi terbaik, cache riwayat, peringkat atau status sampling juga dimasukkan ke dalam tensor atau wadah status terstruktur, guna menjamin reproduktibilitas, keterlacakan, dan pembaruan batch.
Manfaat dan Batasan Organisasi
Tensor yang terpadu dapat mengurangi lalu lintas bolak-balik antara host dan perangkat, menurunkan overhead perulangan, serta menyediakan dasar data untuk paralelisasi operator berikutnya; namun perlu menangani validitas mask, pemborosan padding, pertumbuhan skala multi-tujuan, dan biaya sinkronisasi status.
Tata Letak Tensor untuk Populasi, Evaluasi, dan StatusPopulasi dikodekan sebagai tensor [N, D], satu evaluasi batch menghasilkan matriks fitness [N, M], multi-tujuan atau kendala dapat diperluas menjadi [N, M+K]; generasi, solusi terbaik, status bilangan acak, dan lainnya juga disimpan secara seragam di perangkat sebagai tensor, sehingga pembaruan setiap generasi selesai secara menyeluruh pada dimensi batch yang sama, mengurangi lalu lintas bolak-balik antara host dan perangkat serta overhead perulangan per individu.