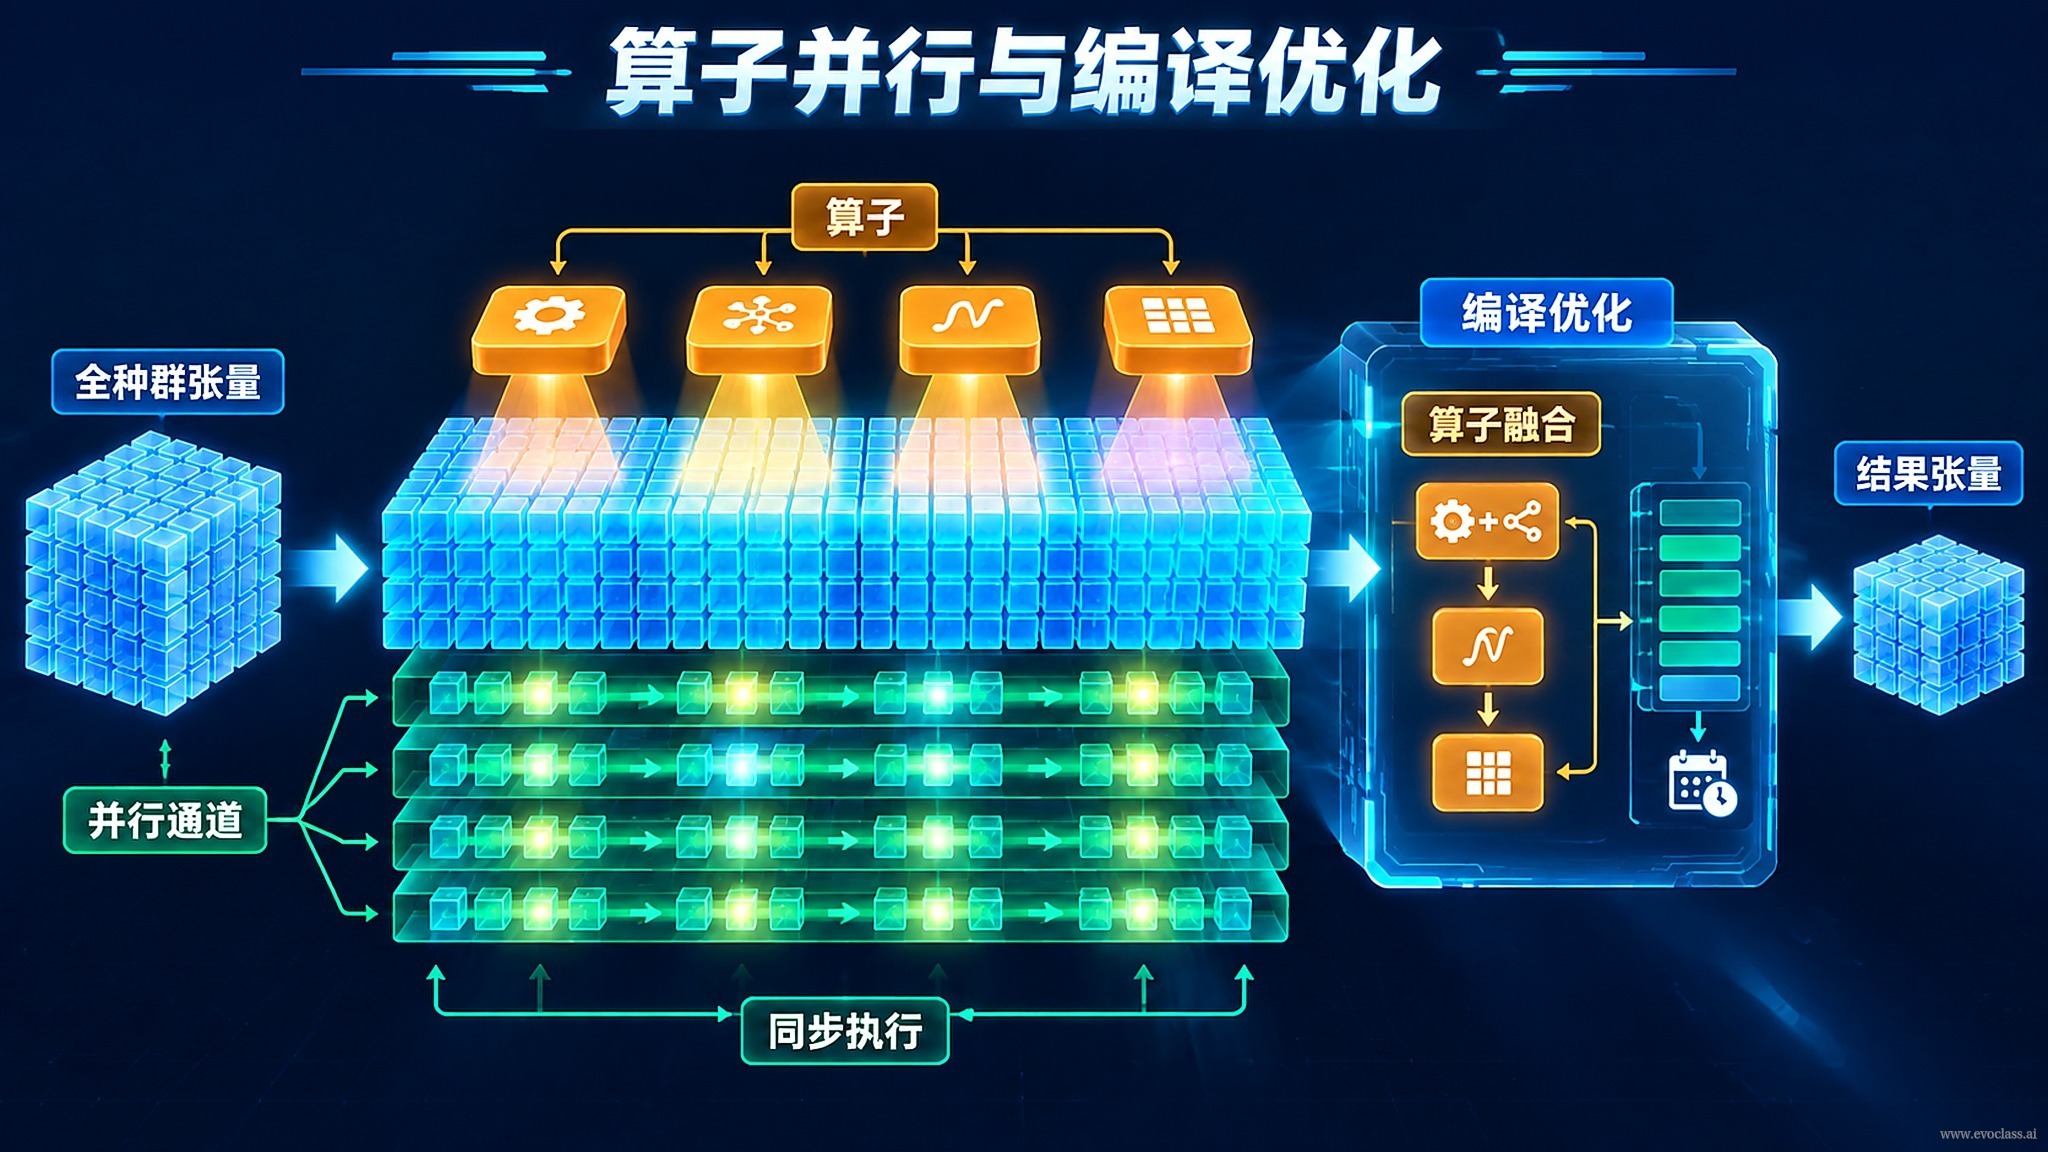
Dalam EvoX sebagai basis komputasi modern, unit eksekusi terkecil operator evolusi bukan lagi "individu", melainkan seluruhtensor populasi: operator seperti mutasi, persilangan, dan seleksi dapat mencakup seluruh individu dalam satu pemanggilan; di atas itu,kompilasi graf komputasimenyusun urutan operator menjadi rencana eksekusi yang dapat dioptimalkan, meningkatkan efisiensi eksekusi tanpa mengubah semantik algoritma.
Paralelisasi operator: evolusi batch berbasis tensor
- Operator tingkat tensor: mutasi, persilangan, dan seleksi dapat bekerja langsung pada tensor populasi berbentuk [N, D] (N adalah ukuran populasi, D adalah dimensi variabel keputusan), satu pemanggilan operator mencakup seluruh N individu.
- Menghilangkan loop per individu: tidak perlu lagi menulis
for ind in population: ind = mutate(ind)loop serial Python/CPU seperti ini, sehingga mengurangi overhead penjadwalan fungsi dan pemanggilan framework yang sering. - Menukar dimensi batch dengan throughput: setelah dimensi individu berperan sebagai dimensi batch, operator dieksekusi secara paralel berskala besar di perangkat, dan throughput evolusi batch meningkat seiring ukuran populasi.
Kompilasi graf komputasi: dari urutan operator ke rencana eksekusi
Menyusun hubungan dependensi operator "mutasi → persilangan → seleksi" menjadi sebuahgraf komputasi, sehingga kompilator dapat melakukan optimasi global pada seluruh graf, bukan hanya memanggil implementasi siap pakai per operator:
- Fusi operator: menggabungkan beberapa operasi element-wise menjadi satu kernel, mengurangi pembentukan tensor perantara dan pembacaan/penulisan berulang.
- Generasi dan penjadwalan kernel: menghasilkan kernel efisien untuk subgraf yang telah difusi, menyelesaikan seluruh generasi evolusi dengan peluncuran kernel yang lebih sedikit.
- Penggunaan ulang memori: merencanakan buffer terlebih dahulu untuk hasil perantara, mengurangi overhead alokasi memori GPU dan pemindahan data.
Efisiensi berubah, semantik tidak
Perlu dibedakan antara"bagaimana menghitung"dengan"menghitung apa". Paralelisasi operator dan optimasi kompilasi hanya mengubah cara eksekusi—jumlah kernel, skala tensor perantara, memori dan strategi penjadwalan—tanpa mengubah makna logis dari mutasi, persilangan, dan seleksi itu sendiri. Lapisan algoritma tetap menggabungkan operator sesuai semantik evolusi, sehingga dengan seed acak yang sama, lintasan evolusi dan hasil sebelum dan sesudah optimasi harus konsisten. Dalam satu kalimat: tensorisasi menyelesaikan "seberapa cepat batch dihitung", kompilasi graf komputasi menyelesaikan "seberapa optimal penjadwalan kernel", sedangkan "apa yang dihitung" tetap tidak berubah.
Alur paralel operator pada tensor seluruh populasiMutasi, persilangan, dan seleksi tidak lagi diulang per individu, melainkan masing-masing dipanggil sekali untuk mencakup seluruh tensor populasi [N, D], dengan dimensi individu berperan sebagai dimensi batch untuk memperbesar throughput; setelah operator-operator ini disusun menjadi graf komputasi berdasarkan hubungan dependensi, kompilator dapat melakukan fusi operator, generasi kernel, dan penggunaan ulang memori, hanya mengubah cara eksekusi, sedangkan semantik algoritma dan lintasan evolusi dengan seed acak tetap tidak berubah.