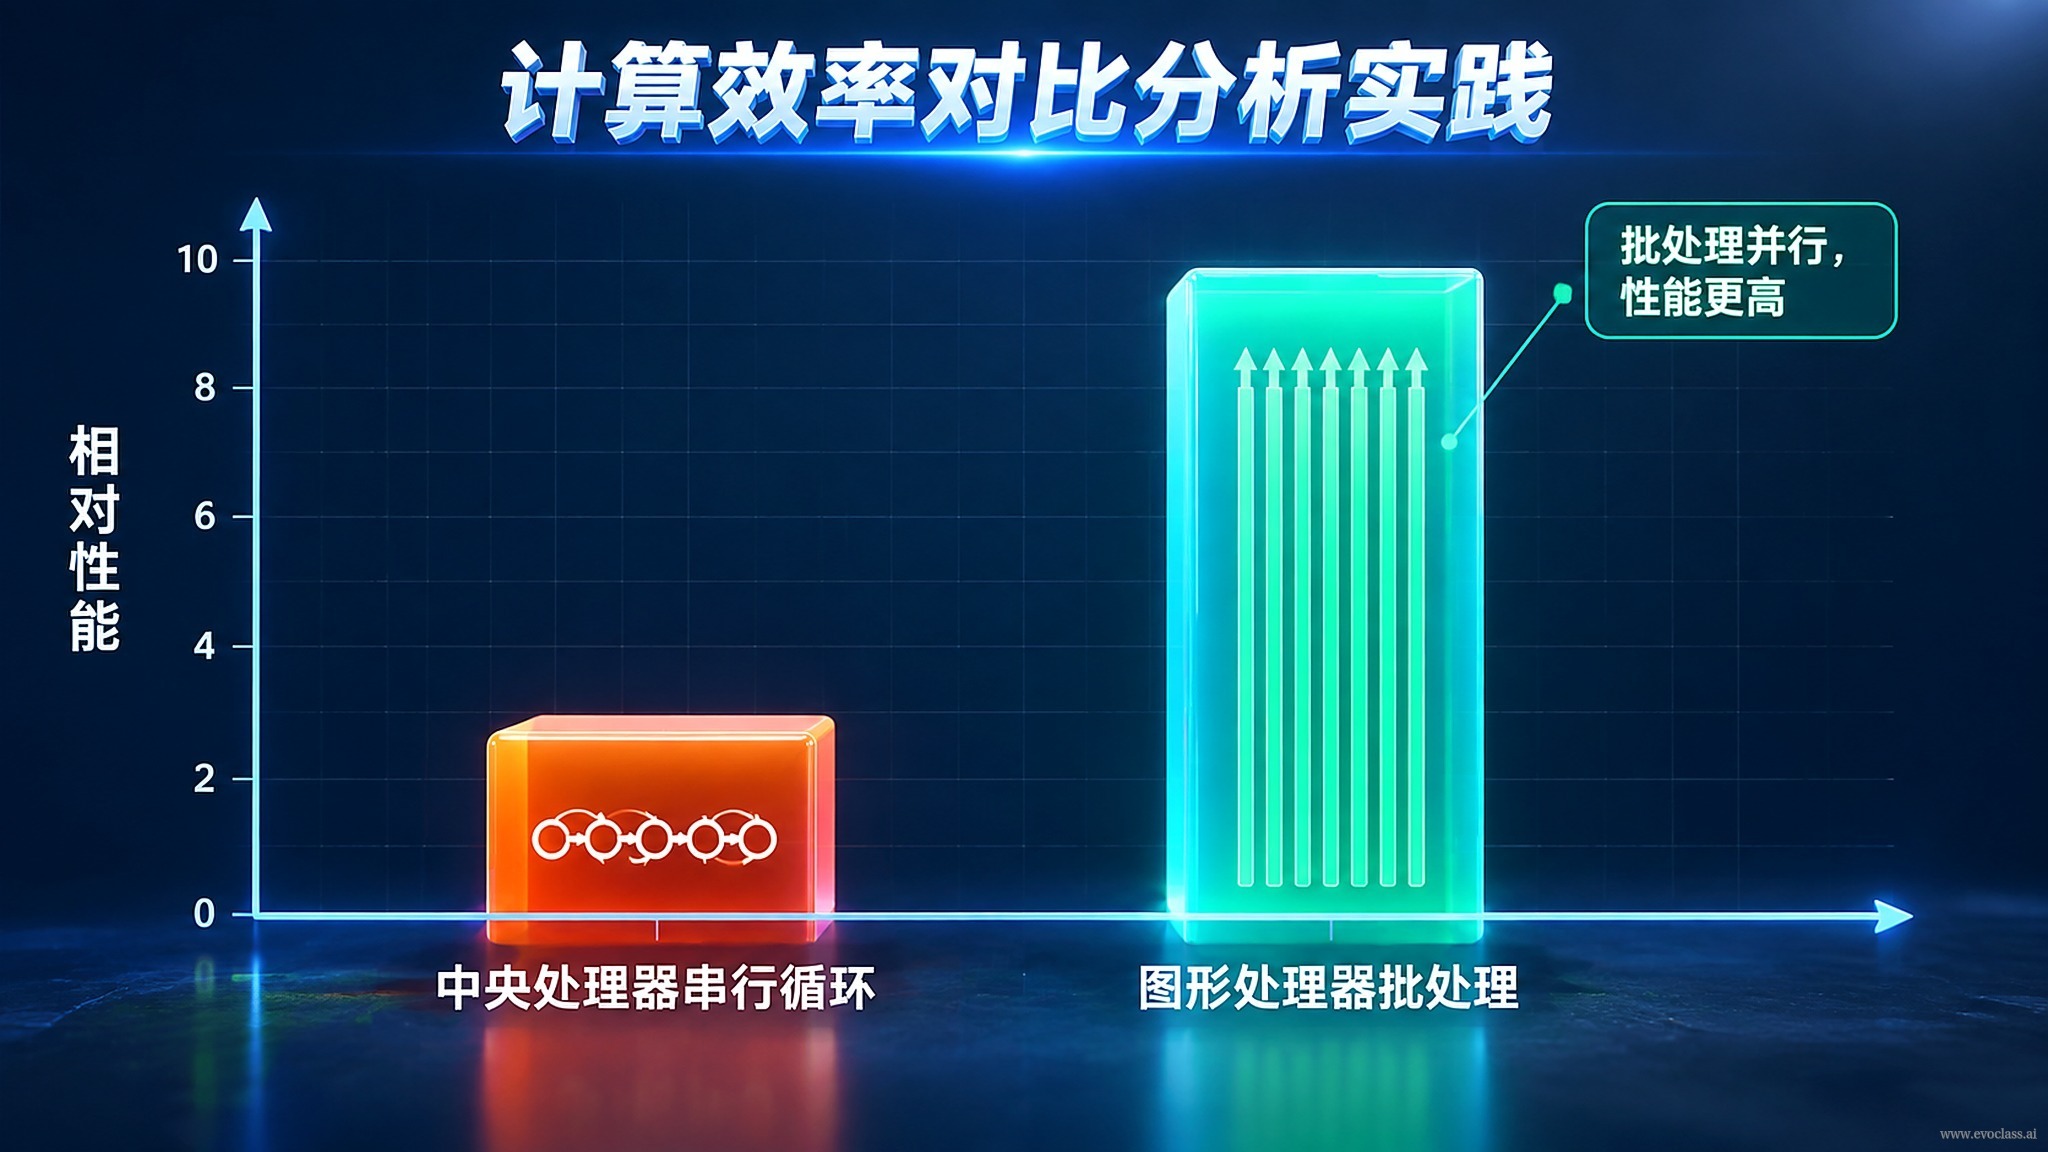
Halaman ini mewujudkan "perbandingan efisiensi komputasi" menjadi sebuah praktik yang dapat direproduksi:pada tugas evolusi yang sama, bandingkan efisiensi end-to-end antara penelusuran individu serial CPU tradisional dan pemrosesan batch tensor GPU EvoX. Tujuannya bukan menghafal kesimpulan "GPU lebih cepat", melainkan memahami dari mana percepatan dari paralelisasi tensor berasal, apa biayanya, dan di mana batasnya.
Dua Baseline, Tugas yang Sama
- Baseline Serial CPU: menggunakan loop untuk memanggil fungsi evaluasi pada setiap individu satu per satu, setiap generasi membutuhkan N kali penjadwalan independen, pembaruan status, dan agregasi hasil. Kontrol loop, overhead interpreter, dan akses memori yang tersebar akan mengencerkan daya komputasi efektif; semakin banyak individu, semakin tinggi proporsi biaya "non-komputasi" ini.
- Implementasi Tensor GPU sebagai Pembanding: EvoX mengorganisasi populasi, input evaluasi, dan status eksekusi sebagai tensor, menjalankan evaluasi dan operator secara batch di GPU, satu pemanggilan mencakup seluruh kumpulan kandidat, sehingga sangat mengurangi loop serial dan jumlah penjadwalan.
Protokol Pengukuran: Membuat Perbandingan Dapat Direproduksi
Perbandingan yang dapat direproduksi harusmenetapkan soal, ukuran populasi, jumlah iterasi generasi, dan benih acak, lalu mencatat: wall-clock per generasi, total waktu, throughput (evaluasi/detik), rasio percepatan, serta utilisasi GPU dan penggunaan memori GPU. Sebelum mengukur waktu perlu dilakukanpemanasanuntuk menyingkirkan pengaruh kompilasi pertama dan alokasi memori GPU, serta melakukansinkronisasi perangkatpada titik pengukuran waktu, sekaligus mencatat waktu komputasi dan waktu transfer data host-perangkat secara terpisah. Jika salah satu langkah ini tidak ada, rasio percepatan yang diperoleh bisa jadi tidak akurat.
Dari Mana Perbedaannya Berasal, dan Kendala Apa yang Membatasinya
- Sumber Manfaat: paralelisme batch, operator tensor, dan paralelisme dalam perangkat memungkinkan satu pemanggilan memproses seluruh kumpulan kandidat, sehingga lebih banyak evaluasi selesai per satuan waktu.
- Kendala: ukuran batch, dimensi soal, tingkat vektorisasi fungsi evaluasi, biaya penyalinan host-perangkat, dan biaya peluncuran kernel semuanya memengaruhi percepatan akhir. Batch yang terlalu kecil akan membuat manfaatnya termakan biaya peluncuran; jika fungsi evaluasi tidak dapat divektorisasi, pemrosesan batch hampir tidak dapat berperan.
Kesimpulan Praktik
Urutan yang benar adalah:verifikasi terlebih dahulu apakah fungsi evaluasi dapat dijadikan batch, baru bandingkan implementasi CPU dan GPU. Keunggulan efisiensi pada akhirnya harus berpulang pada "memperoleh lebih banyak generasi atau lebih banyak solusi kandidat dengan anggaran komputasi yang sama", dan berdasarkan itu menentukan cara penerapan serta desain eksperimen, bukan sekadar mengejar angka rasio percepatan yang bagus.
Perbandingan Efisiensi Serial CPU vs Batch GPUDalam perbandingan ini, baseline serial CPU mengevaluasi individu satu per satu dalam loop, setiap generasi memerlukan N kali penjadwalan dan pembaruan status, overhead interpreter dan akses memori mengencerkan daya komputasi efektif; pemrosesan batch GPU mengorganisasi populasi dan input evaluasi sebagai tensor, satu pemanggilan mencakup seluruh kumpulan kandidat. Rasio percepatan dibatasi oleh ukuran batch, tingkat vektorisasi fungsi evaluasi, dan biaya penyalinan host-perangkat.