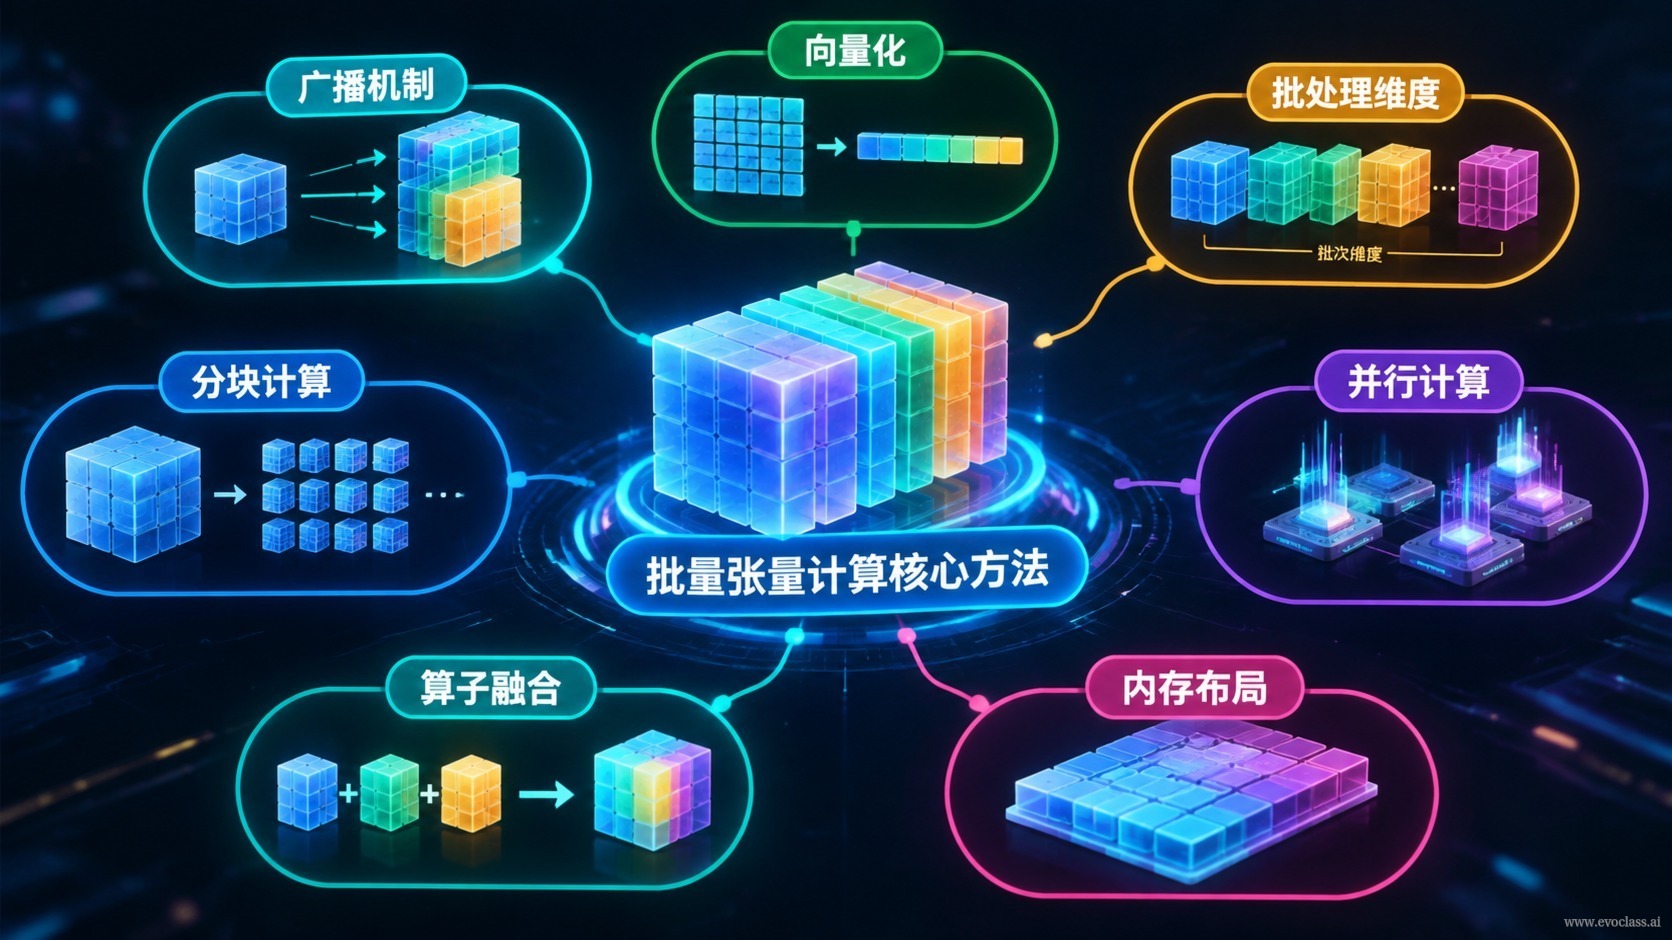
Dalam fondasi tensorisasi EvoX,komputasi tensor batchberada di lapisan ekspresi algoritma: ia memetakan kandidat, evaluasi, dan status dalam siklus evolusi secara seragam menjaditensor dengan dimensi batch, lalu diserahkan ke operator batch yang ramah GPU dan grafik komputasi terkompilasi untuk dieksekusi. Tujuannya sangat jelas—mengubah "evolusi serial per individu" menjadi "evolusi paralel seluruh populasi", sehingga daya komputasi benar-benar bekerja pada pencarian itu sendiri, bukan terbuang pada penjadwalan dan peluncuran.
I. Merepresentasikan Proses Evolusi sebagai Tensor
Dengan menetapkan dimensi batch N sebagai jumlah kandidat (individu), maka tiga elemen dalam evolusi dapat langsung dituangkan menjadi tensor:
- Tensor kandidat: populasi X diorganisasi sebagai [N × D], D adalah jumlah variabel keputusan dari satu kandidat.
- Tensor tujuan: tujuan dan kendala F diorganisasi sebagai [N × M], M adalah jumlah item tujuan/kendala; dalam kasus multi-tujuan, setiap tujuan adalah kolom berbeda dari F.
- Besaran status: nomor generasi, nilai optimal saat ini, ukuran langkah, dan sebagainya dipelihara dengan buffer skalar atau tensor kecil, bukan dicatat per individu menggunakan objek Python.
Dengan demikian, persilangan, mutasi, seleksi, dan evaluasi semuanya diproses secara batch sepanjang dimensi N, dan tidak ada lagi percabangan maupun alur kontrol per individu dalam siklus evolusi.
II. Operator Batch: dari N Panggilan Kandidat Tunggal menjadi Satu Operasi Batch
Tiga ekspresi minimal yang dapat dibandingkan menggambarkan bentuk dasar operator batch:
- Mutasi: X′ = X + σ·randn(X), seluruh kandidat dalam batch masing-masing mendapatkan perturbasi acak dalam satu operasi batch, σ mengontrol kekuatan perturbasi.
- Seleksi: idx = topk(F, k), memilih indeks k kandidat teratas sekaligus dari nilai fitness N kandidat.
- Evaluasi: Y = fθ(X), menggantikan N panggilan kandidat tunggal dengan satu forward batch atau simulasi batch.
Yang kunci bukanlah operator tertentu, melainkan bahwa semua kandidat berbagi grafik operasi tensor yang sama: satu panggilan batch dapat memangkas biaya interpreter dan biaya peluncuran kernel, sehingga daya komputasi GPU/multi-core benar-benar bekerja pada pencarian evolusioner. Penanganan kendala dan pelanggaran batas juga dapat dilakukan dengan tensor mask dalam operasi batch yang sama, tanpa perlu bercabang khusus untuk kandidat tertentu.
III. Optimasi Grafik Komputasi dan Metrik Throughput
Menuliskan evolusi multi-generasi sebagai grafik aliran data yang dapat dikompilasi dapat lebih jauh mengoptimalkan performa:Fusi operatormengurangi jumlah peluncuran kernel,Paralelisme dalam batchmembuat semua kandidat dieksekusi bersamaan,Eksekusi asinkronmembuat komputasi dan transfer data saling tumpang tindih,Penggunaan ulang memorimengurangi alokasi tensor perantara. Sejalan dengan itu, metrik performa juga harus beralih dari "latensi per langkah" kekandidat/detik atau generasi/detikdalam hal throughput—eksekusi batch memproses seluruh kandidat dalam satu panggilan, dan hanya throughput keseluruhan yang benar-benar mencerminkan efisiensi pencarian.
Peta Metode Inti Komputasi Tensor BatchPeta ini merepresentasikan proses evolusi sebagai tensor dengan dimensi batch: populasi X adalah N×D, tujuan dan kendala F adalah N×M, persilangan, mutasi, seleksi, dan evaluasi semuanya diproses secara batch sepanjang dimensi N. Mutasi, seleksi topk, dan evaluasi forward batch hanya memerlukan satu panggilan batch, dan metrik performa pun beralih dari latensi per langkah ke throughput kandidat/detik.