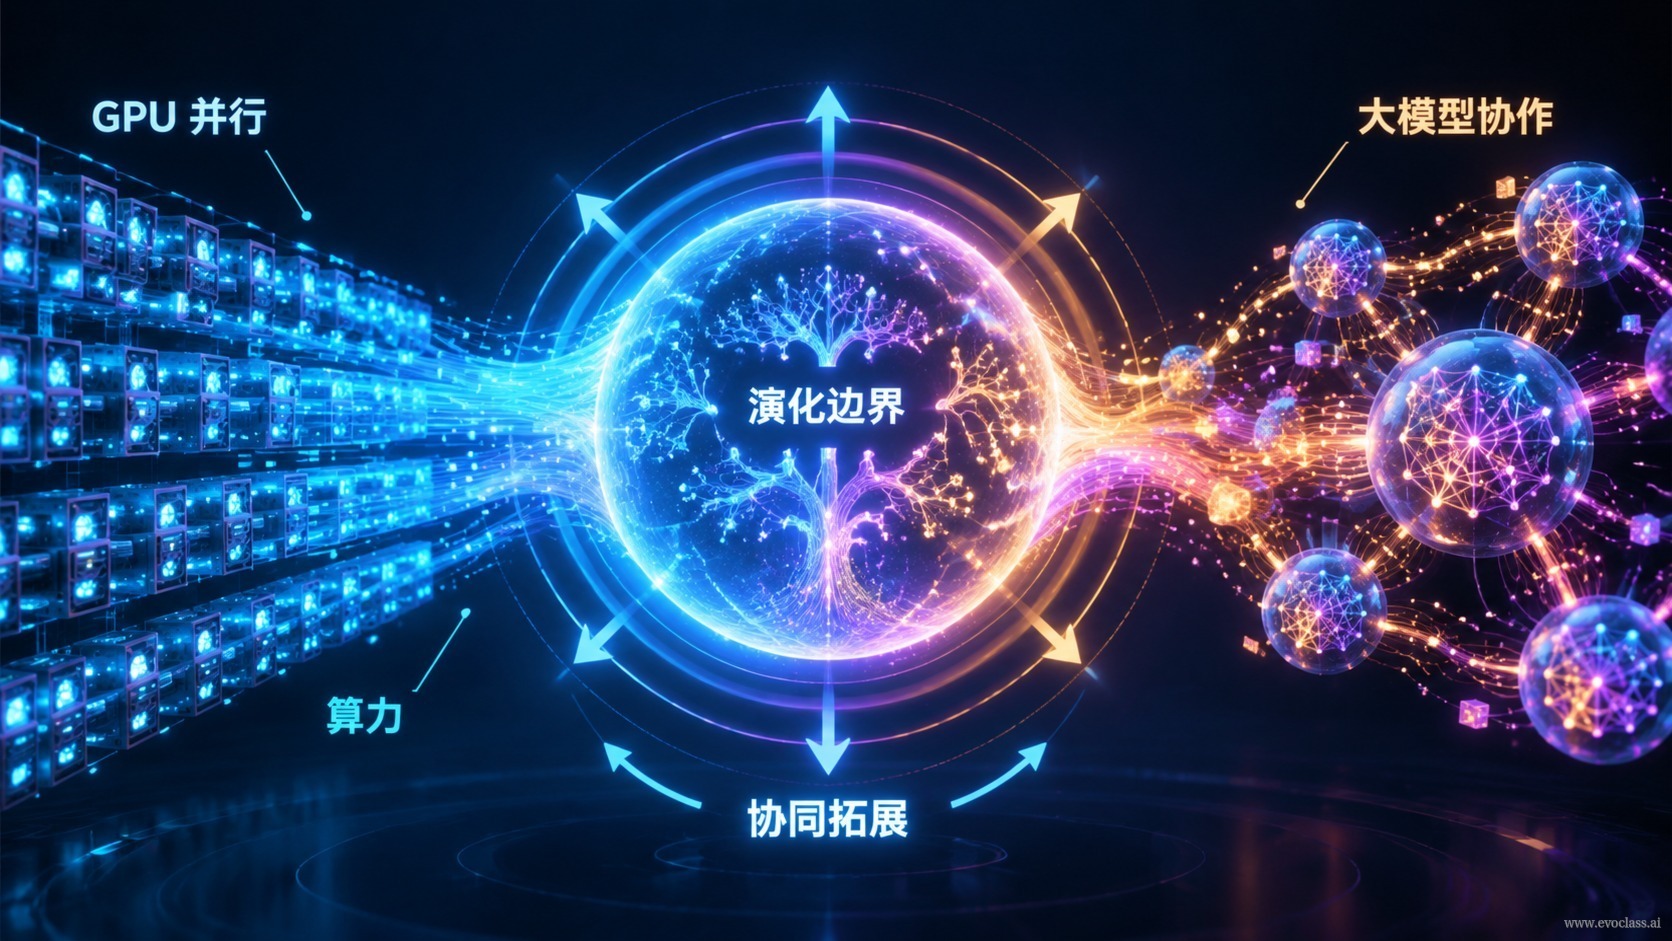
Komputasi evolusioner lama dibatasi oleh satu kendala nyata: berapa banyak kandidat yang benar-benar dapat dievaluasi dalam waktu terbatas. Kini kendala itu dilonggarkan oleh dua kekuatan rekayasa sekaligus—daya komputasi paralel GPUdangenerasi semantik model besar. Keduanya bersama-sama membentuk fondasi rekayasa ganda bagi komputasi evolusioner:daya komputasi menentukan “berapa banyak kandidat yang dapat dijelajahi sekaligus”, model besar menentukan “bagaimana bentuk kandidat yang dapat dijelajahi”, keduanya bersama-sama memperluas batas objek evolusi dari parameter numerik hingga ke program, struktur model, dan mekanisme algoritma itu sendiri.
Fondasi daya komputasi: memindahkan ruang kandidat dari serial ke tensor
Dalam implementasi tradisional, evaluasi populasi adalah loop serial di CPU: hanya memproses satu individu dalam satu waktu, dan biaya penjadwalan menumpuk seiring ukuran populasi. Fondasi sumber terbuka seperti EvoX mengorganisasi kandidat, hasil evaluasi, dan status algoritma secara terpadu menjaditensor yang dapat dihitung secara utuh: mutasi bekerja pada seluruh populasi, evaluasi dan pembaruan status bersama seleksi masuk ke dalam graf komputasi untuk menerima optimasi kompilasi. Hasil langsung secara rekayasa adalah “eksplorasi puluhan ribu kandidat sekaligus” berubah dari trik laboratorium menjadi praktik umum.
Fondasi semacam ini membagi sistem menjadi algoritma, modul masalah, alur kerja, dan penjadwal Runtime: peneliti cukup berfokus pada “bagaimana berevolusi”, sementara Runtime bertanggung jawab menjadwalkan komputasi batch ke GPU, perangkat akselerator, atau klaster terdistribusi. Yang perlu dipahami dengan jelas: daya komputasi menyelesaikan masalahthroughput, bukan “kepintaran”. Ia tidak menilai baik buruknya kandidat, hanya bertanggung jawab menghitung fitness seluruh populasi dalam satu kali proses. Ia adalahpenopang dasarbagi perluasan ruang kandidat, tetapi tidak menentukan bagaimana bentuk kandidat.
Fondasi semantik: mengangkat bentuk kandidat dari vektor numerik ke solusi struktural
Kontribusi model besar bukan pada kemampuan menghitung lebih cepat, melainkan pada pemahamannya terhadap kode, pengetahuan domain, dan konteks tugas, sehingga memilikikemampuan generasi tingkat semantik. Karena itu ia dapat menyusun kandidat dengan struktur kompleks—sepotong kode penyelesaian yang dapat langsung dipanggil, sebuah topologi model proksi—bukan sekadar mengeluarkan vektor numerik. Ruang “bentuk” kandidat pun terbuka.
Perluasan batas objek evolusi dalam tiga tingkat
- Parameter numerik: pengaturan klasik, anggota populasi adalah sekumpulan nilai parameter dalam struktur tetap.
- Program / struktur model: anggota populasi berubah menjadi potongan kode yang dapat dieksekusi, atau topologi jaringan dan model proksi. Kemampuan generasi model besar justru menjadi pintu masuk ke tingkat ini.
- Mekanisme algoritma: bahkan proses “bagaimana menghasilkan, bagaimana mengevaluasi” itu sendiri masuk menjadi objek yang dievolusikan. Inilah prasyarat yang memungkinkan “memperbaiki evolusi dengan evolusi” (seperti MetaDE, AutoPSO) di kemudian hari.
Ambil contoh optimasi airfoil: pendekatan tradisional hanya dapat mencari pada sejumlah parameter numerik yang telah ditetapkan; ketika model besar dapat membaca dan menulis kode penyelesaian, menyusun struktur model proksi, dan GPU dapat mengevaluasi satu populasi secara paralel dalam batch, objek pencarian bergeser dari “sekumpulan nilai parameter” menjadi “satu rangkaian skema generasi dan evaluasi itu sendiri”.
Saling melengkapi, bukan saling menggantikan
Keduanya memiliki hubungan komplementer: daya komputasi memperluasCakupanpencarian, model besar meningkatkankualitas dan kompleksitas bentuk kandidat; tanpa salah satu pihak, perluasan batas tidak akan terwujud. Hanya ada daya komputasi tanpa generasi semantik, objek pencarian tetap terbatas pada pengodean yang telah ditulis mati sebelumnya; hanya ada kemampuan generasi tanpa evaluasi batch, kandidat yang sangat banyak tidak dapat disaring dalam waktu yang dapat diterima.
Harga dari perluasan batas
Perluasan batas sekaligus menghadirkan kendala baru: pertama,biaya evaluasi meningkat, satu kali evaluasi bisa berubah dari tingkat milidetik menjadi tingkat menit; kedua,verifikasi kebenaran menjadi lebih sulit, kode yang dihasilkan mungkin tidak dapat dikompilasi, atau tidak memenuhi batasan fisika dan rekayasa; ketiga,kriteria penentuan “jawaban yang dapat digunakan” menjadi lebih kabur, sehingga perlu berpadu dengan penyeimbangan multi-objektif, pengambilan keputusan pakar, dan tahapan lainnya.
Diagram alur perluasan batas evolusi melalui kolaborasi paralel GPU dan model besarIlustrasi ini menjelaskan bahwa perluasan batas evolusi bergantung pada fondasi ganda: GPU dan Runtime termensorisasi memindahkan evaluasi populasi dari loop serial ke paralel batch, menentukan berapa banyak kandidat yang dapat dijelajahi sekaligus; model besar menyediakan generasi tingkat semantik, menentukan bentuk kandidat yang dapat disusun. Setelah keduanya saling melengkapi, objek evolusi dapat diperluas dari parameter numerik ke program/struktur model, lalu lebih jauh ke mekanisme algoritma, tetapi juga menghadirkan kendala baru seperti biaya evaluasi, verifikasi kebenaran, dan kriteria penentuan jawaban.