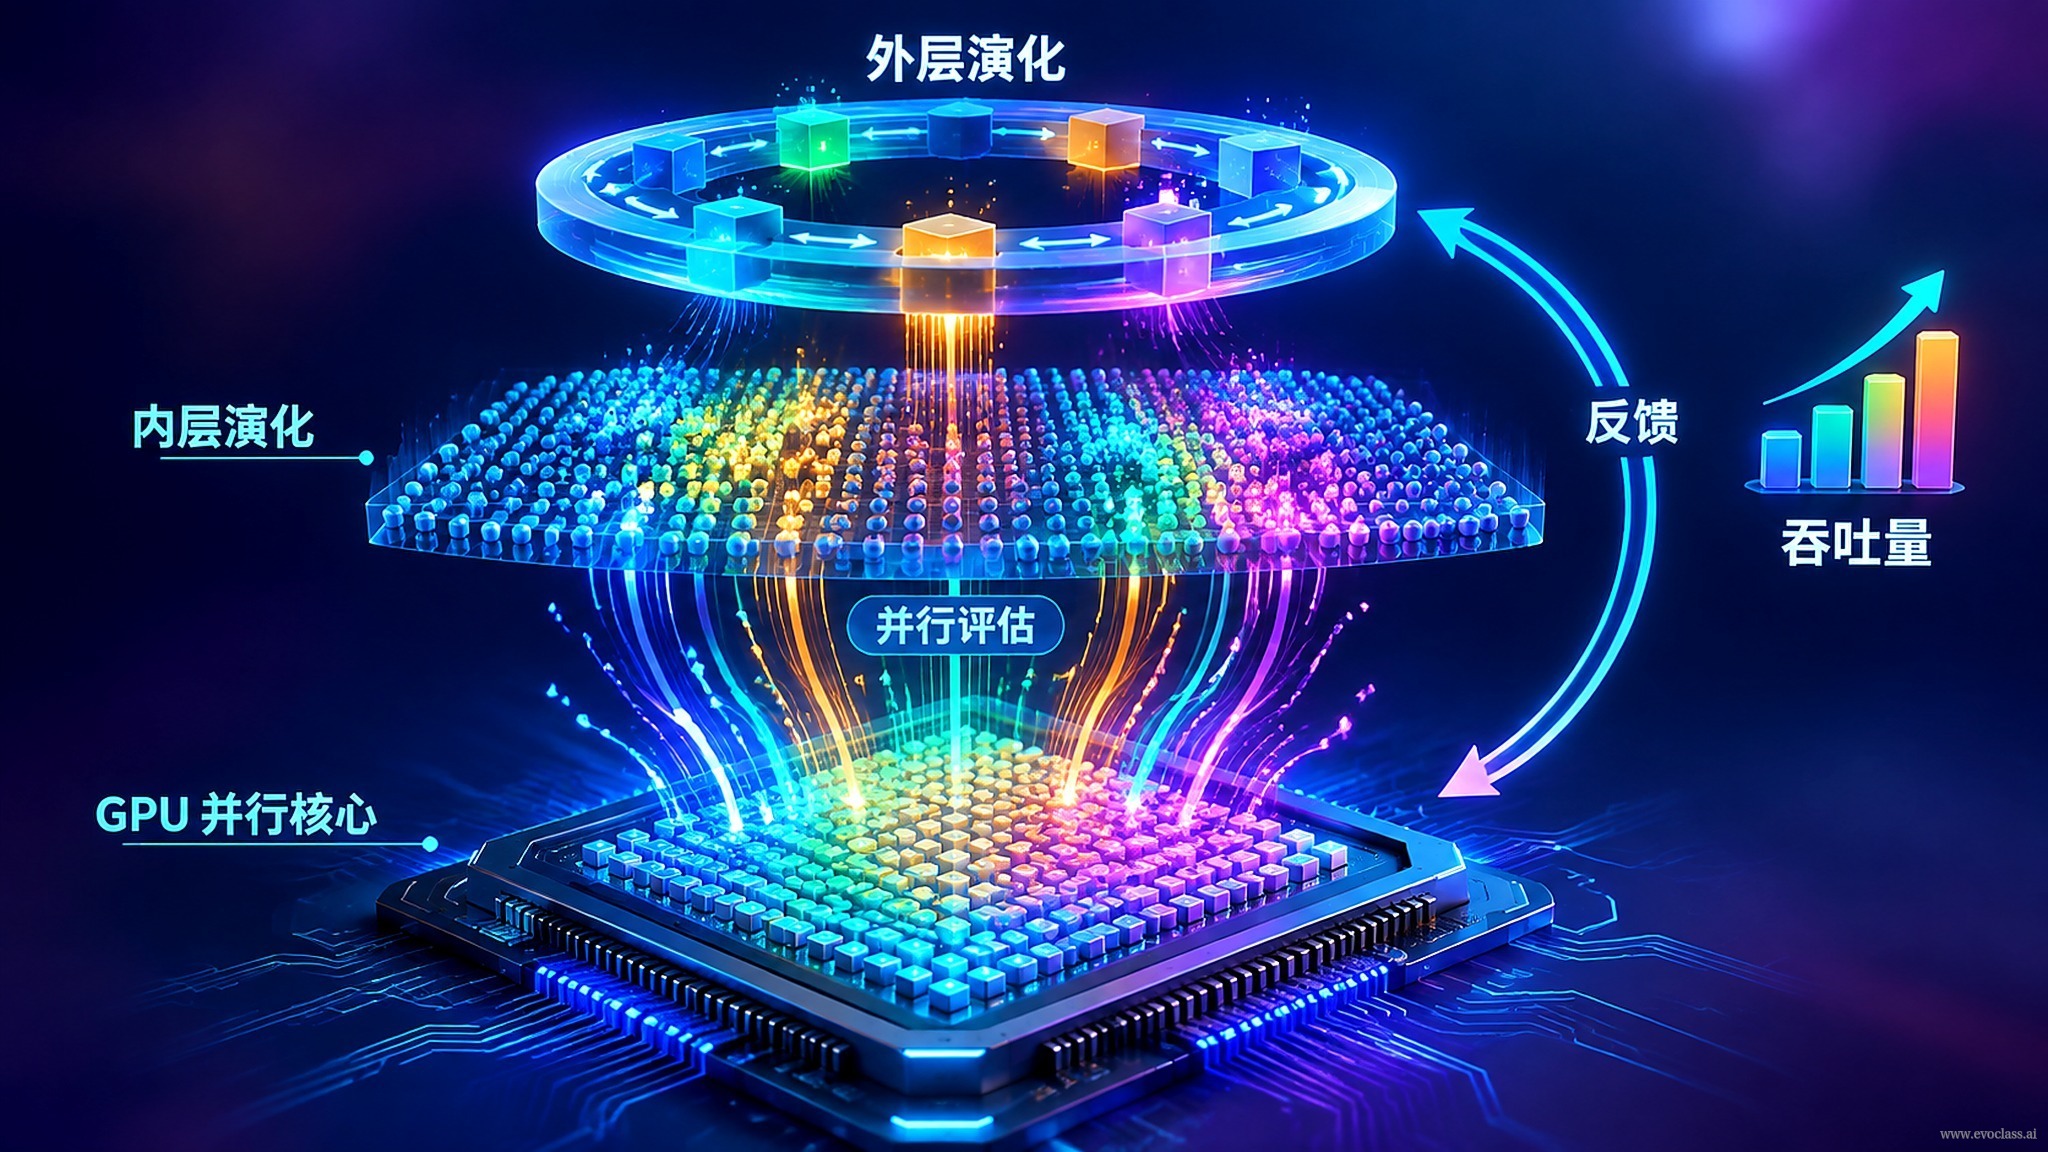
Ketika algoritma evolusioner digunakan untukmeningkatkan algoritma evolusioner itu sendiri, maka terdapat dua lapisan komputasi dalam sistem: lapisan dalam adalah eksekusi dan evaluasi sejumlah besar konfigurasi algoritma pada banyak instans tugas, sedangkan lapisan luar memilih, memutasi, dan memperbarui konfigurasi berdasarkan hasil eksekusi tersebut. Tanpa fondasi paralel yang kuat, evolusi lapisan luar akan menjadi hambatan karena evaluasi serial pada lapisan dalam.Paralelisme GPUjustru menjadi kunci yang mengubah "meningkatkan evolusi dengan evolusi" dari gagasan teoretis menjadi proses eksekusi berthroughput tinggi: tugas lapisan dalam dijalankan secara paralel dalam batch dan terus menghasilkan data performa, sementara evolusi lapisan luar menggunakan data tersebut sebagai umpan balik untuk terus memilih konfigurasi algoritma yang lebih baik.
Dua lapisan dengan perannya masing-masing
- Lapisan dalam (eksekusi dan evaluasi): mengeksekusi sejumlah besar konfigurasi algoritma kandidat (hyperparameter, operator, atau strategi pencarian yang berbeda) secara batch di GPU, lalu menyelesaikan eksekusi dan penilaian untuk setiap instans tugas. Granularitas tugas yang kecil dan jumlahnya yang besar sangat cocok dengan karakteristik throughput pemrosesan batch GPU.
- Lapisan tengah (agregasi umpan balik): merangkum performa mentah dari banyak tugas lapisan dalam menjadi metrik statistik, mengestimasi keunggulan atau kelemahan setiap konfigurasi pada keseluruhan distribusi tugas, dan membentuk fitness yang digunakan oleh lapisan luar.
- Lapisan luar (seleksi konfigurasi): menggunakan umpan balik statistik sebagai masukan untuk melakukan seleksi, mutasi, atau pembaruan, menghasilkan konfigurasi generasi berikutnya dan mengirimkannya kembali ke lapisan dalam, membentuk lingkaran tertutup.
Mengapa paralelisme GPU tidak tergantikan
Pada perulangan serial tradisional, waktu wall-clock satu iterasi ditentukan oleh "jumlah konfigurasi kandidat × jumlah sampel tugas"; begitu skalanya sedikit besar saja sudah tidak tertahankan, sehingga perulangan serial menjadi hambatan utama yang membatasi skala konfigurasi kandidat dan sampel tugas. Paralelisme GPU memungkinkan banyak algoritma lapisan dalam berjalan bersamaan, menurunkan perulangan serial dari "hambatan utama" menjadi "overhead pemrosesan batch yang dapat diterima", sehingga sekaligus memperbesar ruang konfigurasi yang dapat dijelajahi dan jumlah sampel tugas.
Mekanisme inti: satu lingkaran tertutup
Seluruh sistem dapat diringkas sebagai "throughput paralel tugas lapisan dalam → agregasi umpan balik performa → seleksi konfigurasi lapisan luar" sebuah siklus: semakin tinggi derajat paralelisme, semakin memadai sampel umpan balik, semakin stabil estimasi fitness oleh lapisan luar, dan semakin andal arah perbaikan konfigurasi; konfigurasi yang telah diperbaiki kemudian dikirim kembali ke lapisan bawah dan masuk ke putaran throughput paralel berikutnya. Lingkaran tertutup inilah yang memberi algoritma kemampuan mengoptimalkan diri secara berkelanjutan, sekaligus mengubah "meningkatkan evolusi dengan evolusi" dari gagasan teoretis menjadi proses eksekusi yang efisien.
Arsitektur Throughput Evolusi Dua Lapis Paralel GPUDiagram menunjukkan sebuah lingkaran tertutup: lapisan dalam mengeksekusi sejumlah besar konfigurasi algoritma kandidat secara batch di GPU dan menyelesaikan penilaiannya, lapisan tengah merangkum performa lapisan dalam yang sangat banyak menjadi metrik statistik dan membentuk fitness, lalu lapisan luar berdasarkan hal tersebut memilih, memutasi, dan menghasilkan konfigurasi generasi berikutnya, kemudian mengirimkannya kembali ke lapisan dalam. Semakin tinggi derajat paralelisme, semakin padat sampel umpan balik, semakin stabil estimasi lapisan luar terhadap keunggulan atau kelemahan konfigurasi, dan hambatan evaluasi serial pun turun menjadi overhead pemrosesan batch yang dapat diterima.