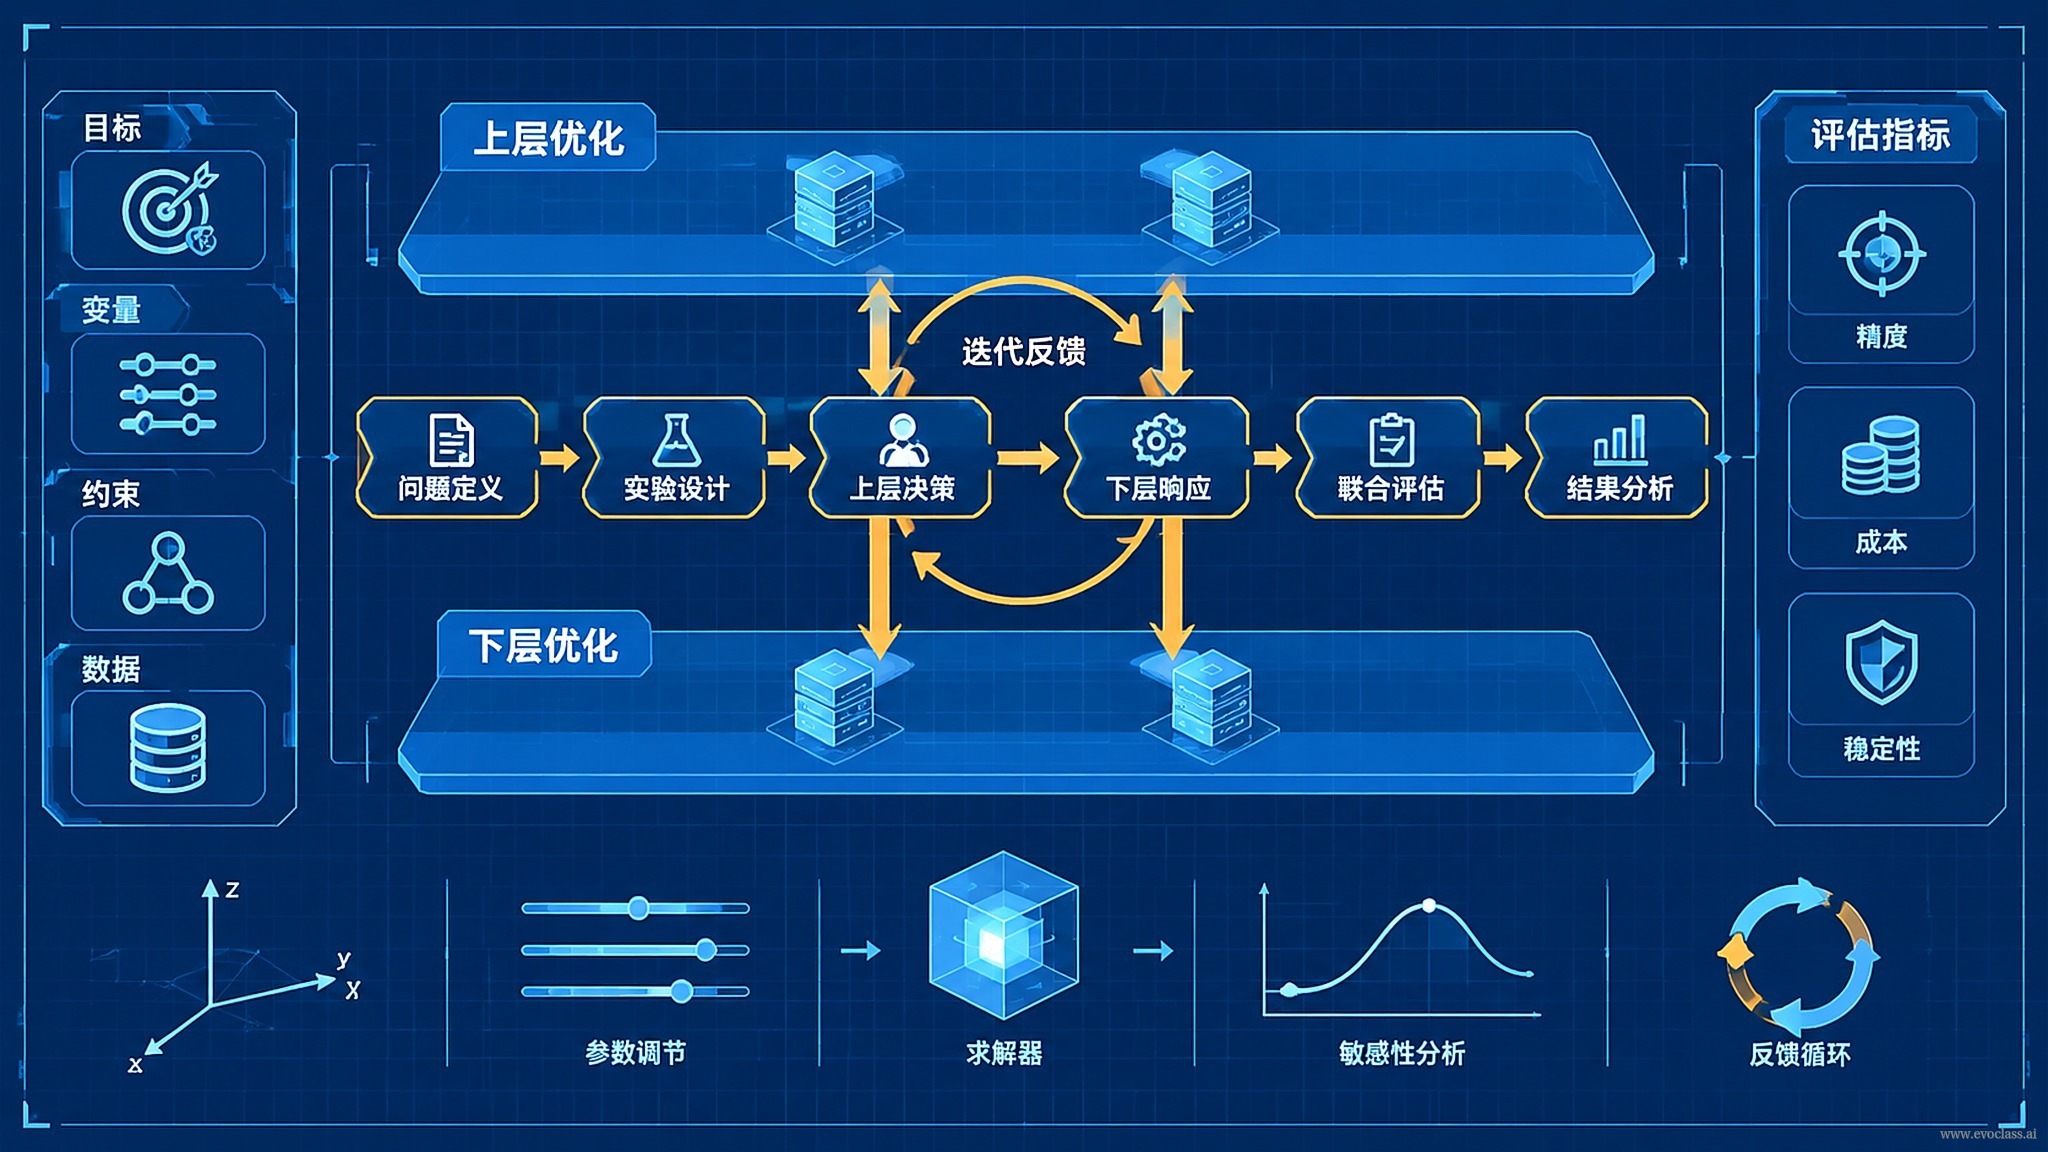
Cetak biru eksperimen optimasi dua lapis harus menjawab satu pertanyaan konkret:berapa nilai yang seharusnya ditetapkan untuk faktor mutasi F pada Differential Evolution (DE). Pendekatannya bukan lagi menyetel secara manual, melainkan mengangkat F dari hiperparameter tetap menjadiobjek yang dapat dievolusikan pada lapisan luar, dan menjadikan “menjalankan satu tugas penyelesaian DE dengan suatu pengaturan F” sebagaiproses evaluasi lapisan dalam; lapisan luar memperbarui konfigurasi berdasarkan kinerja tugas lapisan dalam. Cetak biru ini dapat berjalan karena dibangun di atas fondasi komputasi modern EvoX: populasi, hasil evaluasi, dan status algoritma diorganisasi menjaditensoryang dapat dihitung secara menyeluruh, sehingga konfigurasi kandidat dapat dimutasi secara batch, dievaluasi secara batch, dan masuk ke dalam graf komputasi untuk menerima optimasi kompilasi, lalu oleh penjadwal Runtimekomputasi dikirim ke GPU, perangkat akselerasi, atau klaster terdistribusi, sehingga siklus eksperimen serial yang semula panjang dapat dipadatkan ke dalam jendela waktu yang dapat diterima.
Tugas lapisan dalam: mengubah kinerja menjadi sinyal yang dapat dibandingkan
Lapisan dalam adalah sebuaheksperimen yang dapat diulang. Pertama, pilih satu tugas optimasi atau himpunan fungsi tolok ukur, lalu kunci seluruh struktur utama DE, dimensi, anggaran evaluasi, dan himpunan benih acak — satu-satunya besaran yang berubah adalah konfigurasi F yang dikirim dari lapisan luar. Setiap eksekusi harus mencatat: nilai terbaik, kecepatan konvergensi (jumlah generasi untuk mencapai ambang), tingkat keberhasilan, pelanggaran kendala, metrik multiobjektif (seperti hypervolume), serta keragaman kandidat. Catatan inilah satu-satunya informasi yang dapat “dilihat” oleh lapisan luar, dan menjadi satu-satunya dasar bagi lapisan luar untuk menilai baik-buruk. Evaluasi dijalankan secara batch dalam bentuk tensor, dengan kandidat dalam satu batch berbagi satu graf komputasi, sehingga menghindari overhead evaluasi serial per individu.
Objek strategi lapisan luar: F bukan lagi sebuah konstanta
Lapisan luar tidak mencari sebuah nilai numerik, melainkan sebuah strategi F. Terdapat tiga jenis pengodean yang umum: F konstan; konstanta bertahap, misalnya gen [F1, F2, F3] yang beralih menurut interval generasi; fungsi penjadwalan yang dikendalikan oleh sedikit gen, misalnya memicu F yang berbeda berdasarkan tingkat keberhasilan saat ini, varians populasi, atau proporsi generasi. Pada pengodean berbasis strategi, selain gen itu sendiri, fitur masukan dan aturan keluaran juga wajib dituliskan; jika tidak, rangkaian gen yang sama dapat menghasilkan hasil yang sangat berbeda pada implementasi yang berbeda.
Cara pemetaan: dari genotipe ke konfigurasi saat runtime
Pemetaan dari genotipe lapisan luar ke konfigurasi runtime lapisan dalam haruseksplisit dan dapat direproduksi. Misalnya gen [Fawal, Fakhir, peluruhan] dipetakan menjadi penjadwalan yang meluruh seiring generasi: F(t) = Fawal + (Fakhir − Fawal) × e^(−peluruhan × t / T), dengan t adalah generasi saat ini dan T adalah total generasi; gen [F1, F2, F3] dipetakan menjadi peralihan tiga segmen konstanta. Genotipe yang sama harus selalu dipetakan ke konfigurasi runtime yang sama; jika tidak, “gen baik” yang dipelajari lapisan luar tidak dapat dijelaskan maupun ditransfer ke tugas baru.
Alur loop tertutup dan log wajib
Siklus lengkapnya adalah: populasi lapisan luar menghasilkan sekumpulan konfigurasi F → penjadwal Runtime mengirim tugas DE lapisan dalam secara paralel dalam batch tensor → evaluasi batch GPU → ringkasan metrik → seleksi, mutasi, crossover, dan pembaruan lapisan luar → masuk ke putaran berikutnya. Di sini digunakan organisasi berlapis EvoX: lapisan algoritma menampung evolusi lapisan luar dan logika DE lapisan dalam, modul masalah menyediakan tugas tolok ukur, penjadwal Runtime bertanggung jawab mengirim komputasi batch ke GPU atau klaster terdistribusi, dan modul pemantauan mengumpulkan metrik. Pada loop tertutup harus ditinggalkan catatan yang dapat diputar ulang: benih acak, anggaran evaluasi, ID tugas, model perangkat keras, dan kondisi berhenti. Setiap kesimpulan “lapisan luar menang” harus dapat dijalankan ulang pada kondisi yang sama.
Kondisi batas dan garis dasar: tiga lapis perlindungan
Perlindungan terhadap derau:Ketika fluktuasi evaluasi lapisan dalam besar, hasil dari satu kali eksekusi tidak dapat dipercaya; perlu dilakukan beberapa kali eksekusi independen dan dilaporkan interval kepercayaannya. Fitness dapat diagregasi menggunakan rata-rata, median, atau kuantil terburuk, sekaligus memisahkan tugas pelatihan dan tugas validasi untuk mencegah lapisan luar hanya mengalami overfitting terhadap beberapa benih yang beruntung.Perlindungan terhadap biaya:Ketika tugas lapisan dalam mahal, lakukan penyaringan awal dengan model fidelitas rendah atau evaluasi proksi, lalu evaluasi ulang dengan fidelitas tinggi untuk sebagian kecil kandidat.Perlindungan terhadap garis dasar:F tetap = 0.5 dan DE adaptif klasik harus dibandingkan secara langsung, dan eksperimen ablasi digunakan untuk memastikan bahwa keuntungan berasal dari evolusi lapisan luar itu sendiri, bukan dari jumlah evaluasi yang lebih banyak. Jika ruang pencarian lapisan luar terlalu kecil, optimasi dua lapis akan merosot menjadi penyetelan manual; dalam hal ini ruang pengodean harus diperluas, bukan sekadar menambah anggaran.
Cetak Biru dan Alur Eksperimen Optimasi Dua LapisDiagram ini menggunakan faktor mutasi F dari Differential Evolution sebagai contoh: lapisan dalam mengunci tugas, dimensi, anggaran evaluasi, dan benih acak, sehingga hanya strategi F yang dikirim dari lapisan luar yang berubah, dan mencatat nilai terbaik, kecepatan konvergensi, tingkat keberhasilan, pelanggaran kendala, hypervolume, serta keragaman kandidat; lapisan luar dapat mengodekan F konstan, F bersegmen, atau fungsi penjadwalan, yang setelah pemetaan eksplisit dievaluasi secara batch dan dipilih untuk pembaruan. Loop tertutup juga perlu menyimpan benih, anggaran, ID tugas, perangkat keras, dan kondisi berhenti untuk memastikan kesimpulan dapat dijalankan ulang.