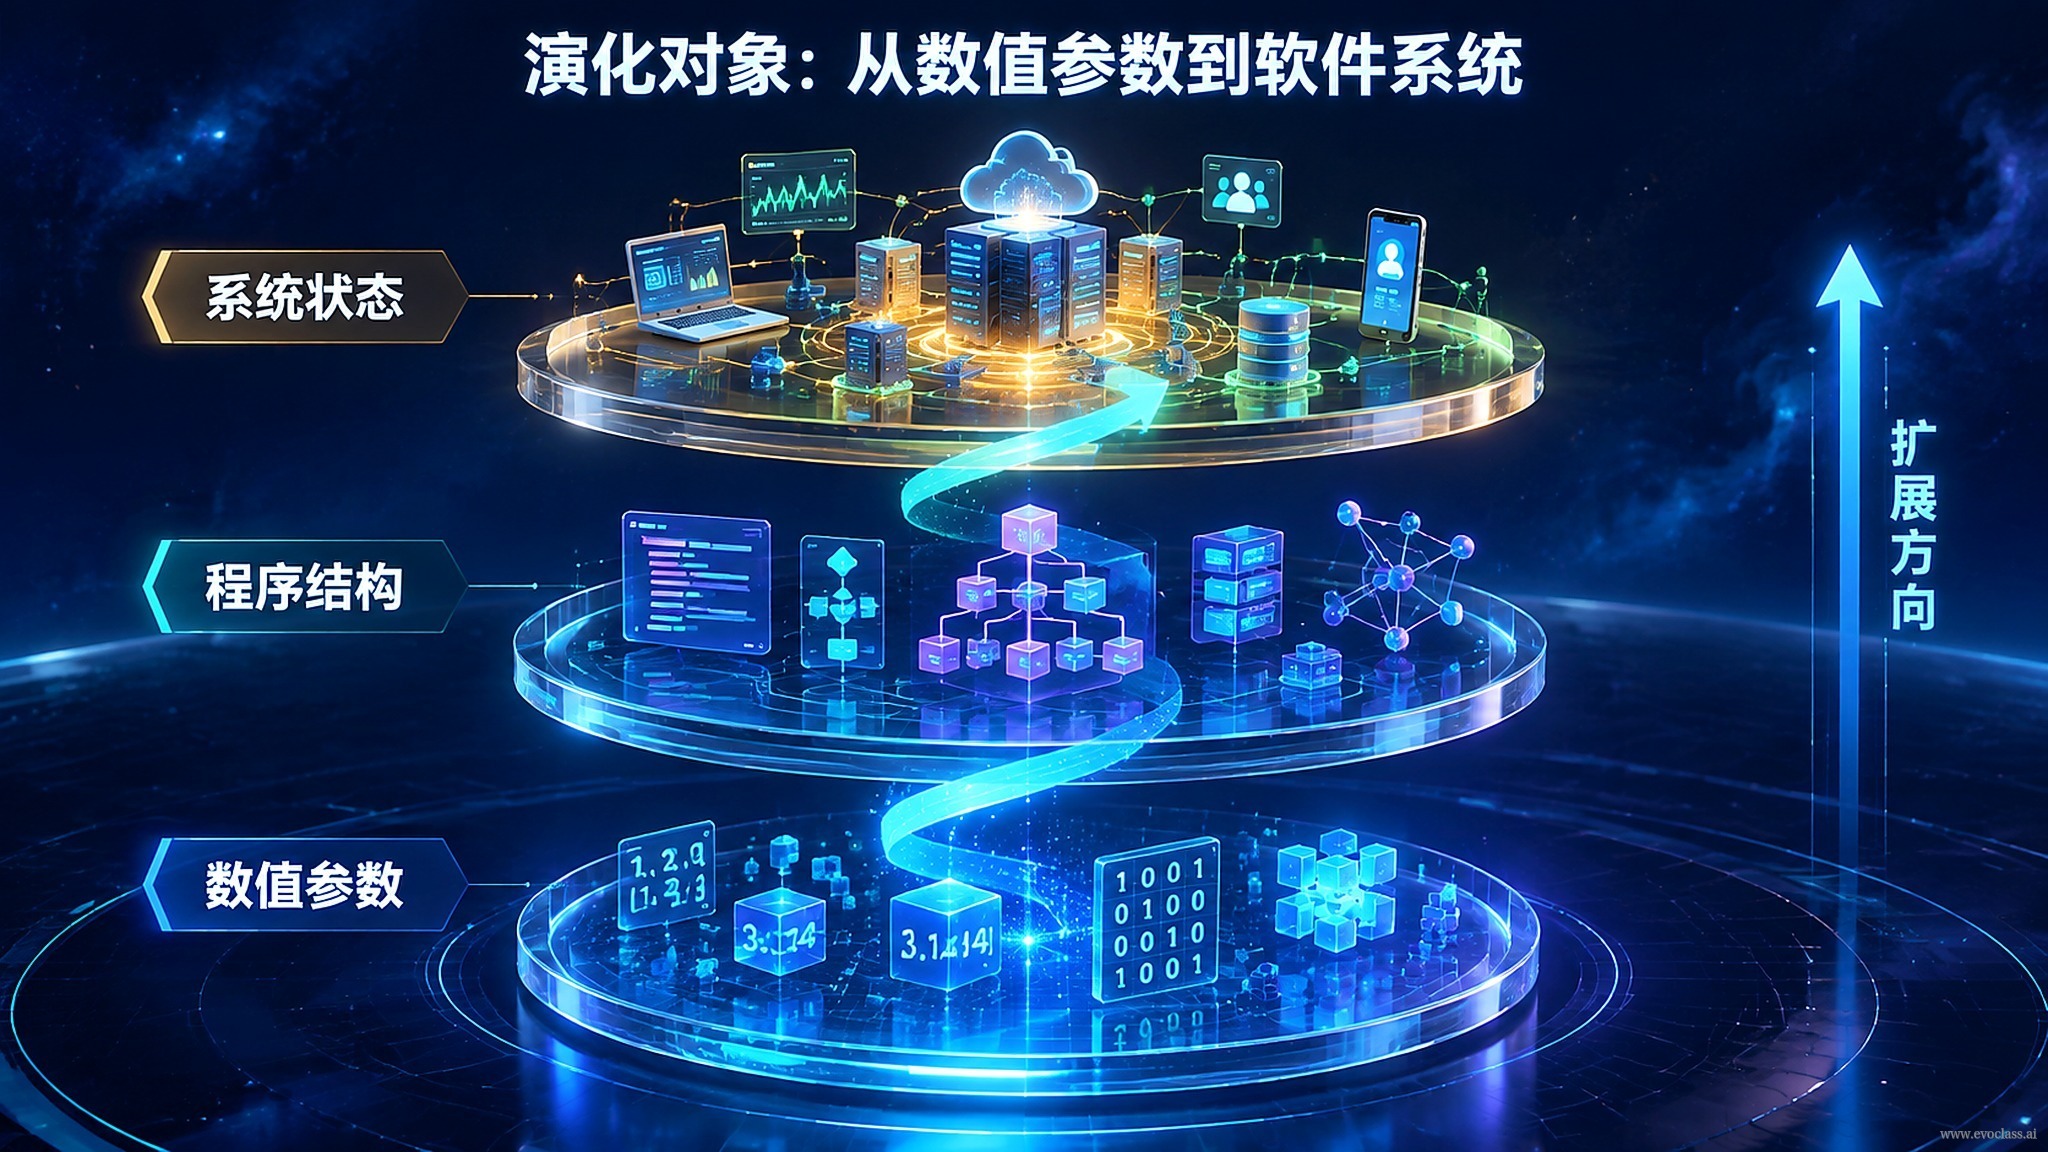
Nelle prime pratiche del calcolo evolutivo, gli oggetti "evoluti" erano quasi sempreparametri numerici— tasso di apprendimento, dimensione del batch, intensità della regolarizzazione, modalità di inizializzazione dei pesi. Lo spazio di ricerca era un insieme di numeri e la valutazione consisteva in un addestramento più una verifica. Con l'aumento della potenza di calcolo e la maturazione delle capacità dei grandi modelli, gli oggetti evolvibili si sono ampliati in modo evidente: programmi, architetture dei modelli, meccanismi algoritmici e persino interistati di ingegneria del software(configurazioni, versioni delle dipendenze, contratti delle interfacce, strategie di deployment e di esecuzione).
Questo percorso di estensione può essere rappresentato con una chiara catena di frecce: parametri numerici → programmi e architetture dei modelli → stati di ingegneria del software e candidati a livello di sistema. Più ci si sposta verso destra, maggiore è l'espressività e più numerosi sono i tipi di cambiamento coperti, rendendo così possibile l'evoluzione a livello di sistema.
Tre livelli di oggetti evolutivi, ciascuno con costi diversi
- Livello dei parametri numerici: il candidato è un insieme di numeri, economico da generare e rapido da valutare, ma può rispondere solo a "se è stato ottimizzato bene", senza poter colmare un meccanismo che manca fin dall'inizio.
- Livello dei programmi e delle architetture dei modelli: il candidato è un'architettura di rete, una combinazione di operatori, un workflow di prompt o una patch di codice; il cambiamento modifica "ciò che il sistema può fare", non solo "quanto è accurato".
- Livello degli stati di ingegneria del software: il candidato è una configurazione, una versione di dipendenza, un contratto di interfaccia e una strategia di deployment, che determinano direttamente se il sistema può funzionare in modo stabile e se può essere riprodotto.
Spostamento del baricentro: da "come generare i candidati" a "come eseguirli e valutarli"
Quando i candidati passano dai numeri ai programmi, la fase di "generazione dei candidati" non è più il collo di bottiglia: i grandi modelli possono produrre in massa architetture, meccanismi e patch. Ciò che determina davvero l'efficacia dell'evoluzione èil meccanismo di esecuzione e valutazione— chi riesce a far girare davvero i candidati e chi riesce a stabilire, entro costi accettabili, se meritano di essere mantenuti.
Maggiore è l'espressività, più pesante è il carico di valutazione. Un parametro numerico richiede un solo addestramento per essere valutato; una patch di codice, invece, necessita di isolamento in sandbox, test di regressione e confronto con il benchmark per rispondere a tre domande: è davvero efficace, comporta rischi, i risultati sono riproducibili? Sandbox, test di regressione e benchmark sono proprio i dispositivi ingegneristici che servono a contenere costi, rischi e riproducibilità, e che permettono di mantenere o scartare i cambiamenti in modo stabile.
Compromessi ingegneristici: più candidati non significa un'evoluzione migliore
Nella pratica dei team, il percorso comune è iniziare con la messa a punto del tasso di apprendimento e degli iperparametri, per poi estendersi gradualmente alla ricerca su architetture di rete, combinazioni di operatori, workflow di prompt o patch di codice. A ogni livello di estensione occorre rispondere in parallelo: quanta potenza di calcolo e quanto tempo richiede la valutazione? I candidati falliti potrebbero contaminare il sistema esistente? Gli stessi risultati saranno riproducibili la prossima volta? Solo raggiungendo un equilibrio tra espressività, costi di valutazione, riproducibilità e sicurezza l'evoluzione a livello di sistema diventa davvero praticabile.
La triplice estensione degli oggetti evolutiviNel diagramma la catena di frecce va dai parametri numerici ai programmi e alle architetture dei modelli, per poi giungere agli stati di ingegneria del software e ai candidati a livello di sistema: più si va verso destra, più numerosi sono gli oggetti modificabili e maggiore è l'espressività. Tuttavia, il costo aumenta di pari passo: i parametri numerici richiedono solo un addestramento per essere valutati, mentre le patch di codice necessitano di isolamento in sandbox, test di regressione e confronto con il benchmark per determinarne efficacia, rischio e riproducibilità.