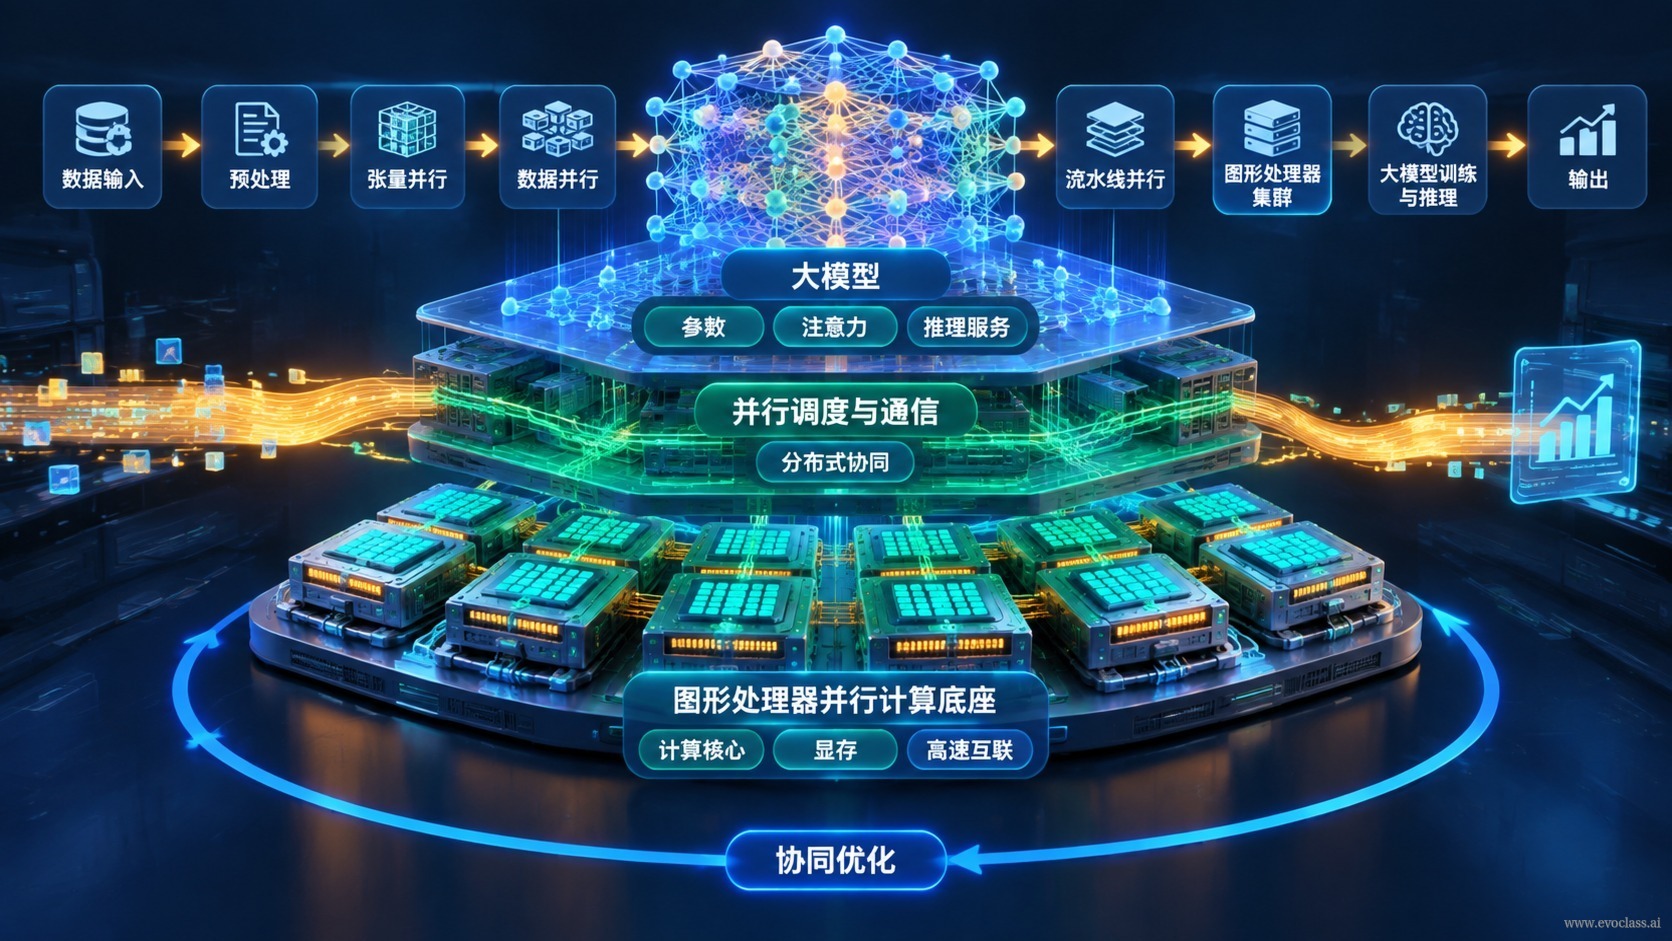
Questa pagina illustral'infrastruttura ingegneristicache permette a EvoX di condurre esplorazioni evolutive su larga scala:la GPU fornisce potenza di calcolo parallela ad alte prestazioni,mentre i grandi modelli offrono capacità di comprensione e generazione relative al linguaggio naturale, al codice e al contesto progettuale. Dalla loro combinazione deriva un'apertura della scala computazionale, che trasforma radicalmente l'origine, il numero e il raggio d'azione esplorativo delle soluzioni candidate.
Cosa apre la potenza di calcolo: dal piccolo batch seriale all'esplorazione simultanea su larga scala
Con risorse di calcolo limitate, valutare una soluzione candidata richiede spesso di attendere in coda e la ricerca può procedere solo in piccoli lotti seriali: «provare qualche soluzione in più» è un lusso. La capacità parallela della GPU porta valutazione e ricerca a svolgersi simultaneamente su larga scala: popolazioni o grandi lotti di soluzioni candidate possono essere inviati in una sola volta alla valutazione parallela e il feedback ritorna quasi nello stesso momento. Così «tentare simultaneamente molte possibilità» non è più un espediente speciale, ma diventa una capacità ingegneristica predefinita.
- Throughput: la valutazione in batch comprime il tempo di attesa di ogni singola iterazione entro limiti accettabili, permettendo al ciclo evolutivo di girare ad alta frequenza invece di essere rallentato dalla fase di valutazione.
- Scala: aumenta il numero di candidati esplorabili simultaneamente e con esso lo spazio delle ipotesi copribile dalla ricerca; il confine esplorativo passa da «qualche tentativo per prova ed errore» a «dispiegamento in lotti».
Come sono cambiate le fonti delle soluzioni candidate
Una volta aperta la scala computazionale, le fonti dei candidati passano da «progettazione manuale + campionamento limitato» a una modalità ibrida:l'approvvigionamento in batch tramite calcolo parallelo e la generazione e riscrittura da parte dei grandi modelli producono insieme i candidati. I grandi modelli sono in grado di comprendere il linguaggio naturale, il codice e il contesto progettuale, e possono tradurre più rapidamente l'intento di ricerca in candidati eseguibili, script o bozze di operatori, mantenendo il raccordo con il contesto del progetto; il lato GPU si occupa invece di validare queste bozze in batch e di restituire i risultati al processo di ricerca. Uno davanti e l'altro dietro, coprono esattamente le due estremità della «generazione» e della «verifica».
L'infrastruttura non sostituisce l'algoritmo evolutivo
È bene precisare che questo livello èun'infrastrutturae non l'algoritmo in sé. Si occupa diThroughput,porta semantica e raccordo contestuale; ricerca, selezione e ciclo chiuso di feedback restano di competenza dell'algoritmo evolutivo. Solo chiarendo la divisione dei compiti si acquisisce capacità di giudizio nella pratica: quando un sistema non funziona bene, occorre prima stabilire se manchi il throughput di calcolo, la porta semantica o il meccanismo di ciclo chiuso stesso.
Sullo stesso filo conduttore ingegneristico, l'infrastruttura deve sostenere anche la collaborazione multi-Agent e la scomposizione ricorsiva dei compiti e modelli ingegneristici simili: un obiettivo complesso viene scomposto in diversi sotto-compiti, che differenti Agent prendono in carico e portano avanti. Perché questi sotto-compiti non si scolleghino tra loro, serve lapersistenza a livello di progetto— depositare obiettivi, vincoli, prodotti intermedi e risultati di valutazione a livello di progetto, così che possanoattraversare i contesti degli Agent e proseguire. In caso contrario, ogni volta che si cambia Agent occorre riallineare il contesto, e la scomposizione ricorsiva degenera in chiamate isolate senza alcun legame tra loro.
Schema architetturale della sinergia tra parallelismo GPU e grandi modelliOsserva lo schema architetturale della sinergia tra parallelismo GPU e grandi modelli e rifletti su come si colleghi al fatto che «i grandi modelli sono in grado di comprendere linguaggio naturale, codice e contesto progettuale».