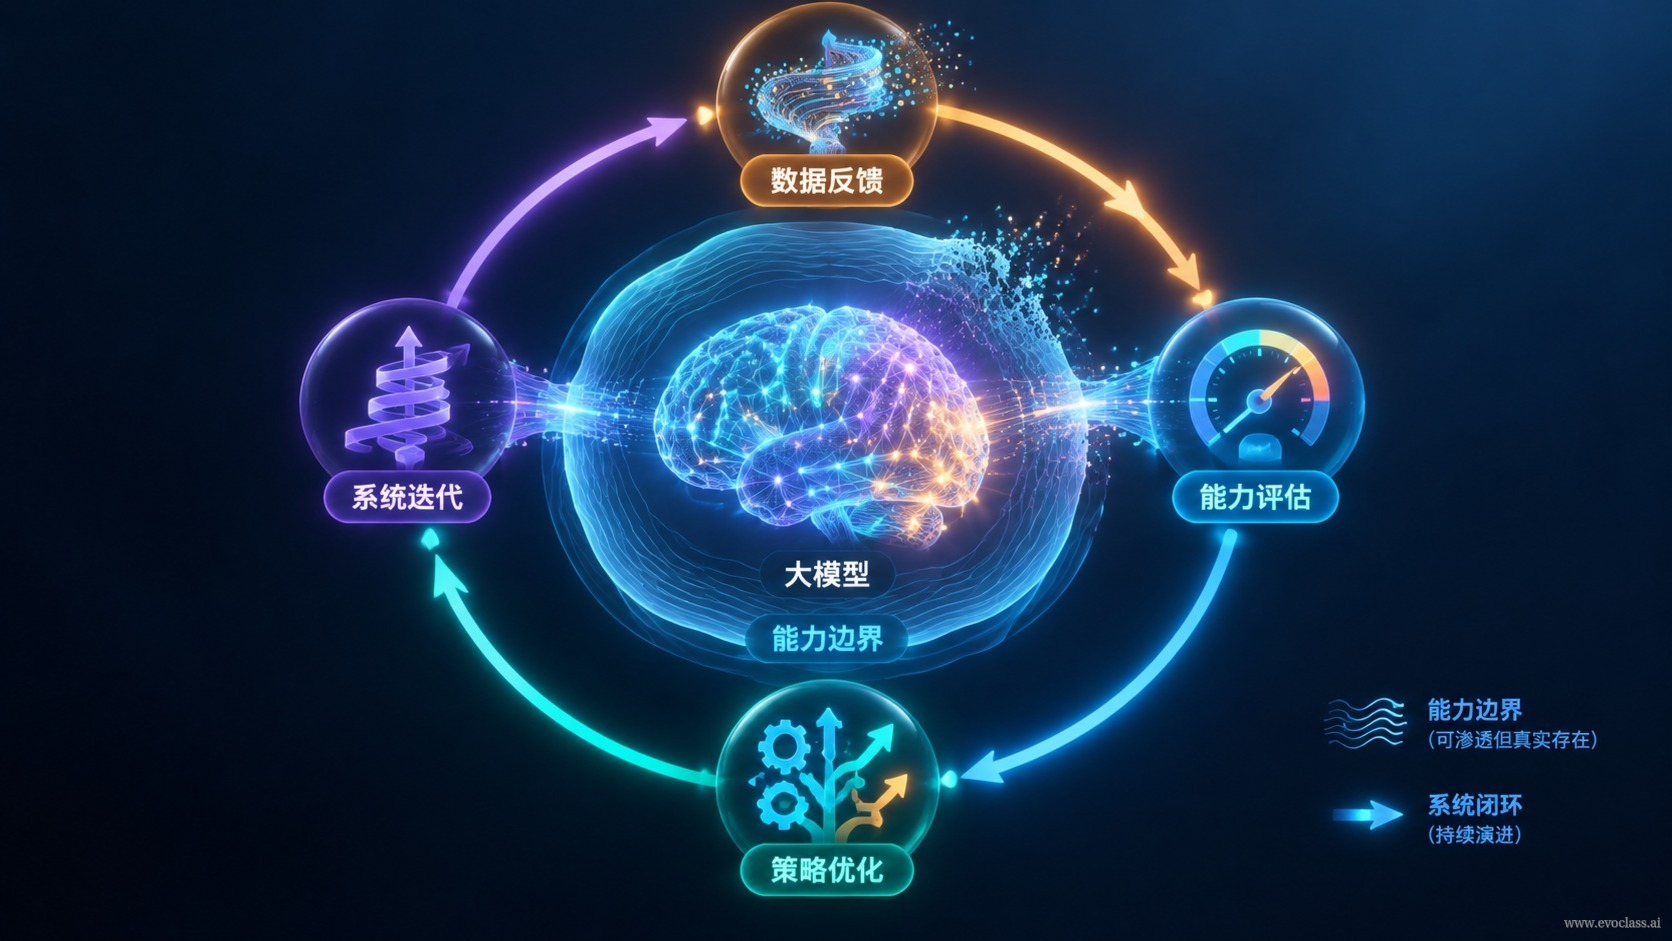
I grandi modelli si sono ormai trasformati in una solidabase di capacità: comprensione semantica, generazione di codice e soluzioni, ragionamento multi-passo, chiamata di strumenti e funzioni — è sufficiente a sostenere una modalità interattiva in cui «formuli una domanda e ottieni subito dei candidati». Ma più solida è la base, più facilmente nasconde un fatto ingegneristico:il modello genera le possibilità, il ciclo chiuso deve essere assunto dal sistema. Questa pagina vuole proprio dimostrare questoconfine di capacità, e perché l'evoluzione continua sia una responsabilità a livello di sistema, e non un'estensione naturale delle capacità del modello.
I. Ciò di cui il lato modello è già all'altezza
- Comprensione semantica: trasformare requisiti vaghi in una descrizione eseguibile del problema, riconoscendo vincoli e obiettivi impliciti.
- Capacità generativa: produrre codice, configurazioni, soluzioni e spiegazioni in pochi minuti, con la capacità di autocorreggersi nello stesso turno di conversazione.
- Ragionamento multi-passo: svolgere scomposizione del task, deduzione a catena e spiegazione delle scelte, con una forma di output naturalmente orientata a «proporre candidati e spiegarne le ragioni».
- Chiamata di strumenti: attivare ricerca, calcolo e interfacce esterne tramite chiamate di funzione, collegando l'output linguistico ad azioni reali.
Questi quattro punti insieme significano che «generare candidati» è ormai quasi a costo zero. La risorsa davvero scarsa non è la quantità di candidati, mail meccanismo che applica pressione selettiva sui candidati.
II. Lacune strutturali: una singola sessione non può chiudere il ciclo
- Stato volatile all'interno della sessione: una volta esaurito il contesto, la memoria tra i task si interrompe e le lezioni apprese nel ciclo precedente non passano automaticamente a quello successivo.
- Assenza di ground truth: il modello non può definire autonomamente «cosa è corretto», né fornire criteri di valutazione indipendenti dal proprio output.
- Assenza di orchestrazione degli esperimenti: test benchmark in batch, verifica della significatività statistica, valutazione della conformità ai vincoli e l'esecuzione in ambienti reali ad alto costo non rientrano nel controllo del modello.
La conclusione è chiara: il modello non può completare autonomamente, in una singola sessione o in un singolo task,generazione dei candidati — verifica in ambiente — consolidamento dei risultatiil ciclo chiuso. Non è una questione di capacità insufficienti, madi responsabilità che non spettano affatto al modello.
III. Le quattro categorie di lavoro in cui il lato sistema deve intervenire in supplenza
- Generazione e variazione dei candidati: organizzare l'output del modello, ampliando attivamente e strutturando lo spazio di ricerca.
- Costruzione e invocazione dell'ambiente: allestire ambienti sperimentali eseguibili in modo riproducibile, occupandosi di orchestrazione, esecuzione e validazione.
- Valutazione e selezione: definire ground truth e valutatori, completando ordinamento, selezione e valutazione della significatività.
- Consolidamento e riuso: scrivere risultati riusciti ed esperienze fallimentari nella memoria a lungo termine, diventando il punto di partenza del task successivo.
Il principio di divisione del lavoro si riassume in una sola frase:il modello genera le possibilità, il sistema applica la pressione selettiva e conserva la storia. I due non sono intercambiabili: senza il modello, il sistema non ha diversità da selezionare; senza il sistema, il modello può solo ripartire da zero ogni volta.
IV. Cambio di criterio: da «quanto è buono un singolo output» a «se i miglioramenti possono accumularsi»
Per stabilire se un sistema si sta davvero evolvendo, il criterio non dovrebbe essere «quanto è buono un singolo output», ma «se i miglioramenti possono accumularsi tra task e tra cicli di Agent». Un output straordinario ma non ereditabile resta essenzialmente un consumo una tantum. Quando l'output di ogni task viene consolidato in asset ingegneristici riutilizzabili — codice, configurazioni, valutatori, raccolte di casi di fallimento — il punto di partenza dei task successivi è più alto del precedente: è questa laEvoluzione continua a livello di progetto. La pratica di EvoX offre un paradigma di consolidamento ingegneristico stabile e affidabile: attraversare Agent e cicli di task, trasformando l'esperienza in asset, invece di lasciarla nei log delle conversazioni.
Infine, tracciamo un confine rispetto ai temi adiacenti: questa pagina dimostra solo «perché serve un'evoluzione continua a livello di sistema», senza approfondire il meccanismo di doppio livello dell'evoluzione dell'algoritmo stesso (si veda il contenuto successivo su MetaDE).
Diagramma delle relazioni tra capacità dei modelli AI e organizzazione del ciclo chiuso a livello di sistemaOsserva il diagramma delle relazioni tra capacità dei modelli AI e organizzazione del ciclo chiuso a livello di sistema e indica i punti salienti che hai notato.