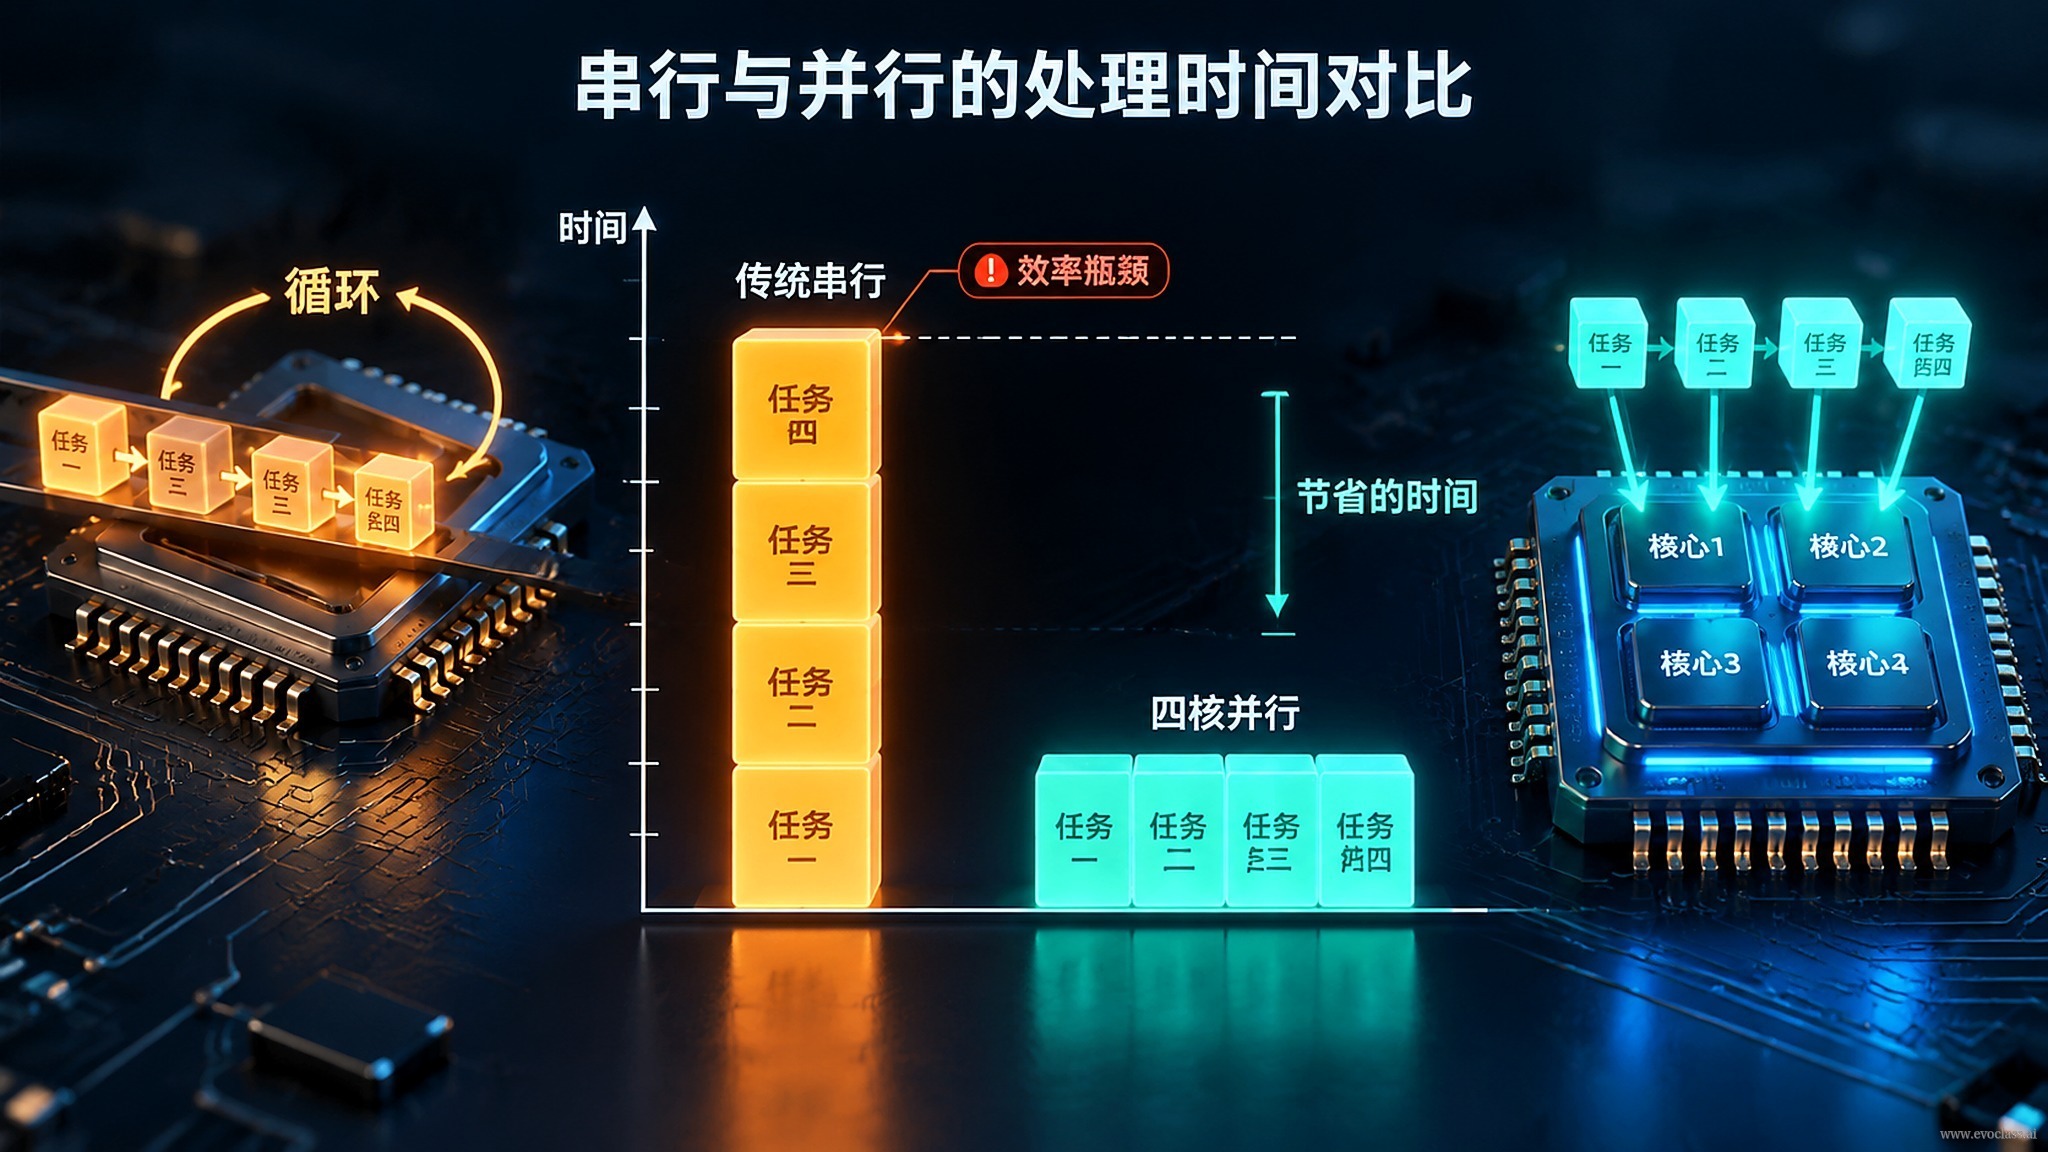
Il processo evolutivo dipende dalla diversità della popolazione, e la diversità implica una crescita esponenziale delle dimensioni della popolazione e del numero di valutazioni. Quando le valutazioni dei candidati raggiungono l'ordine delle decine di migliaia,il tradizionale ciclo CPU serialediventa il tratto più stretto dell'intera catena di elaborazione: elabora un solo individuo alla volta, lasciando quasi inutilizzata la capacità parallela dell'hardware.
Uno alla volta: il modello di esecuzione del ciclo seriale
L'implementazione più elementare considera l'intera popolazione come una lista ed estrae gli individui uno per uno con un ciclo: preleva individuo → decodifica in parametri concreti → chiama la funzione di valutazione → riscrivi il fitness. Le iterazioni adiacenti non riescono quasi mai a sovrapporsi: finché il risultato della valutazione non ritorna, la scrittura non può procedere; finché la scrittura non è completata, il prossimo individuo non ha dove collocare il risultato. Di conseguenza le unità parallele come multi-core, SIMD e GPU restano inattive per la maggior parte del tempo, assistendo inermi mentre un singolo individuo attraversa la catena di elaborazione.
Da dove derivano esattamente i costi
- Numero di valutazioni in crescita lineare: il numero totale di valutazioni è circa pari a dimensione della popolazione × numero di generazioni; raggiunta la soglia di 10⁵, il tempo reale seriale cresce in modo quasi lineare.
- Esecuzione individuale a livello di interprete: i cicli per singolo individuo, i controlli dei limiti e il dispatch dei tipi comportano costi costanti fissi ma elevati.
- Accesso non contiguo alla memoria e trasferimento dati: gli individui prelevati uno alla volta sono spesso non contigui in memoria, il tasso di hit della cache è basso e i costi di trasferimento vengono pagati ripetutamente.
- Sincronizzazione e scheduling: per prelevare l'individuo successivo, il flusso di esecuzione deve fermarsi e riprendere ripetutamente.
Convertire la scala in tempo
Prendendo come esempio una popolazione di 1000 individui e 100 generazioni, si ottengono circa 100.000 valutazioni dei candidati. Se una singola valutazione richiede in media 1 ms, la sola fase di valutazione in modalità seriale richiede circa 100 secondi, senza contare i costi di calcolo degli operatori e di scheduling; se, per mantenere la diversità, si aumenta il numero di riavvii da 1 a 5, il costo cresce in modo quasi lineare fino a circa 500 secondi. A parità di carico di lavoro, se organizzato per batch e affidato a hardware parallelo, il tempo reale dipende principalmente dal numero di batch e non dal numero di individui.
Quando questo collo di bottiglia si attenua
Anche le condizioni al contorno sono importanti: quando una singola valutazione è estremamente economica (ordine dei microsecondi) o la popolazione è molto piccola (inferiore al centinaio), i costi di scheduling e memoria possono superare quelli di calcolo, il divario tra seriale e parallelo si riduce sensibilmente, il beneficio marginale della tensorizzazione diminuisce e il collo di bottiglia si sposta sulla granularità dello scheduling e sulla larghezza di banda della memoria. Pertanto, se valga la pena ristrutturare il modello di esecuzione va valutato congiuntamente al costo di valutazione e alla scala.
Confronto dei tempi tra seriale e paralleloPrendendo come esempio una popolazione di 1000 individui e 100 generazioni, si ottengono circa 100.000 valutazioni dei candidati; con una singola valutazione di 1 millisecondo, la sola fase di valutazione in modalità seriale richiede circa 100 secondi, e con 5 riavvii cresce in modo quasi lineare fino a circa 500 secondi. Passando a un'organizzazione per batch affidata a hardware parallelo, il tempo reale dipende principalmente dal numero di batch e non dal numero di individui.