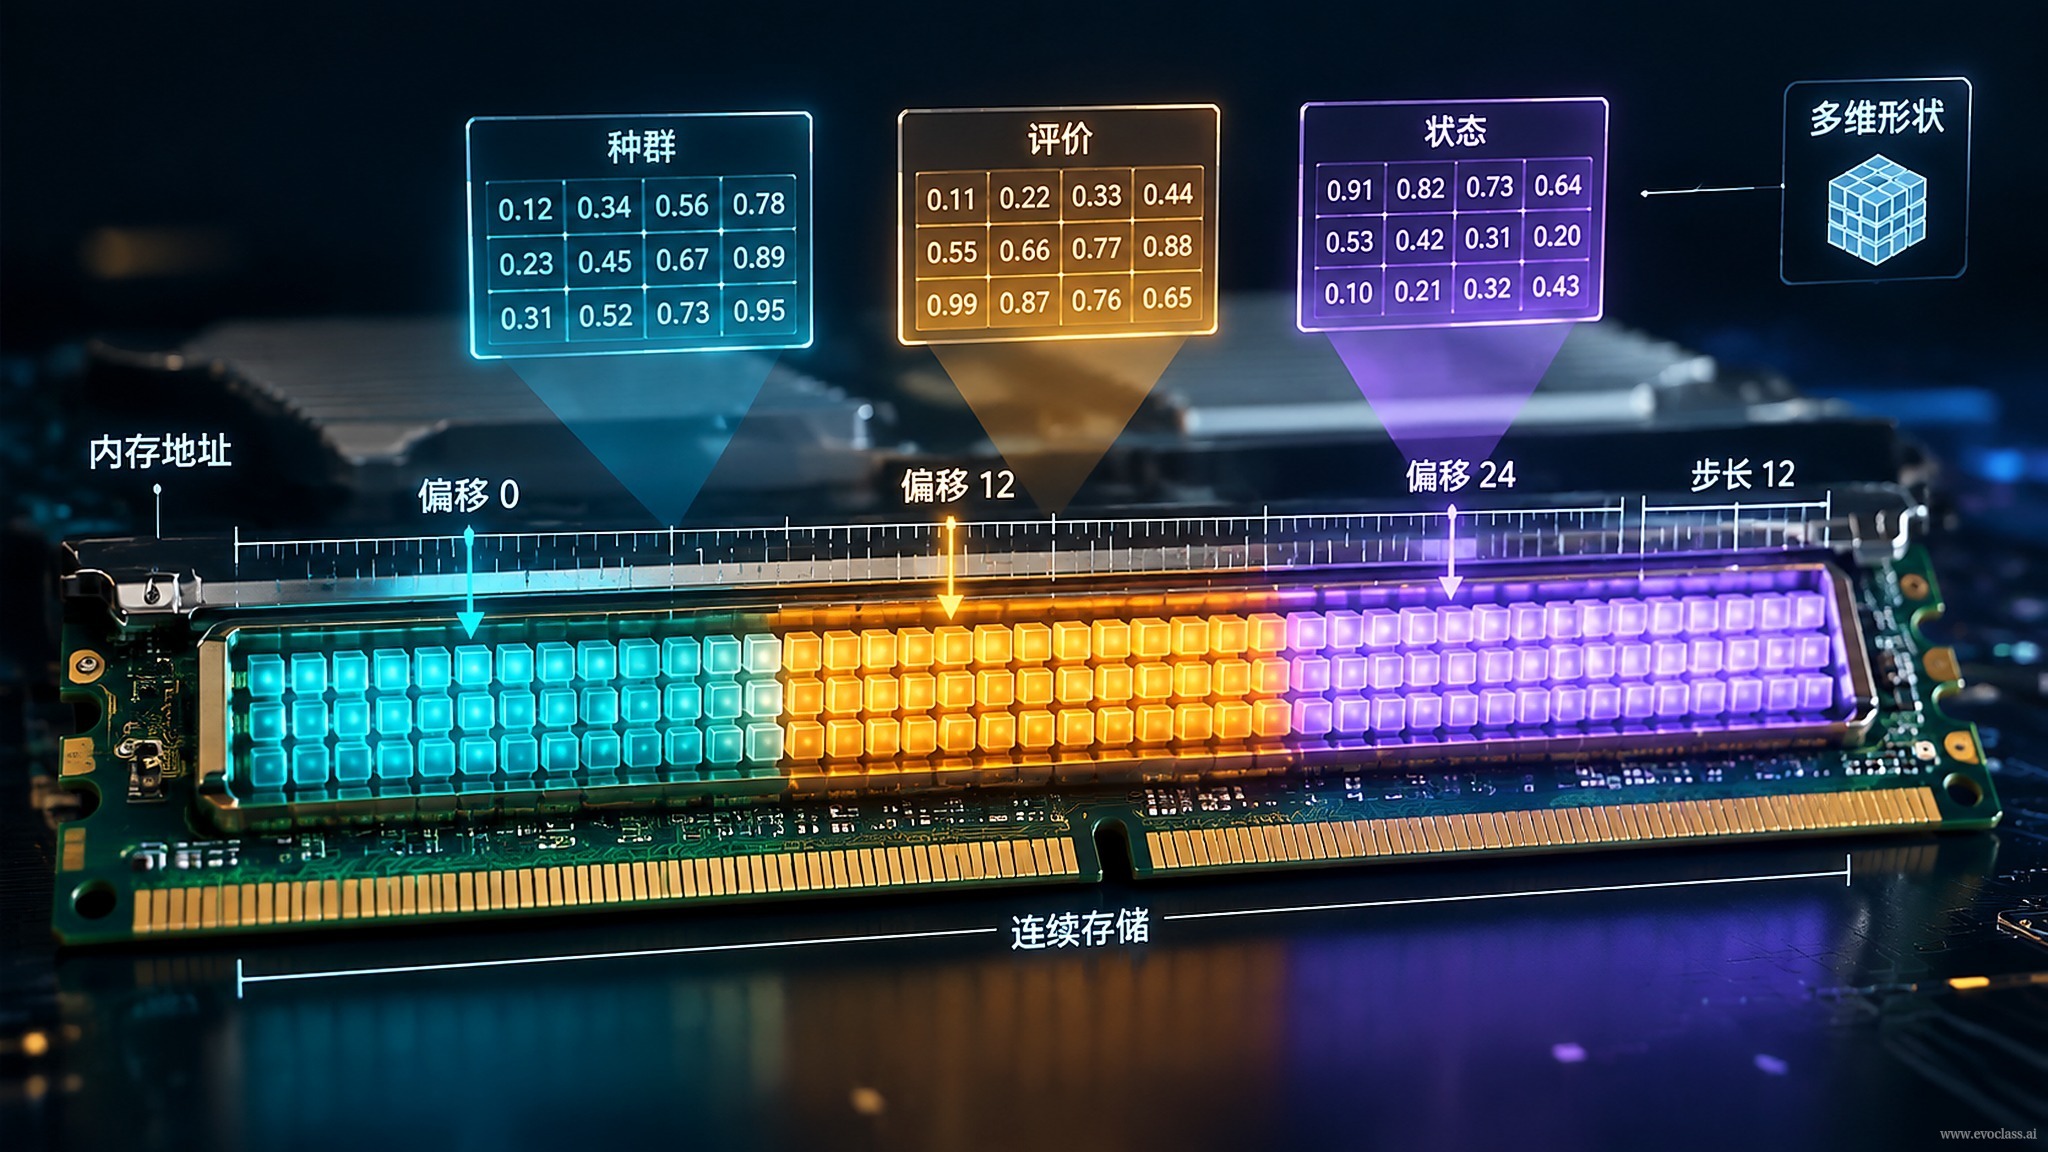
Nell'implementazione ingegneristica degli algoritmi evolutivi,l'organizzazione tensorialemappa in modo unificato «cosa è la popolazione, come viene valutata, a che punto è l'esecuzione» da oggetti e liste sparsi a tensori regolari. In sostanza, stabilisce un contratto dati unificato per popolazione, valutazione e stato, affinché il calcolo batch, la permanenza sul dispositivo e la successiva pianificazione parallela condividano la stessa semantica di memoria.
Tensorializzazione della popolazione: codifica come [N, D]
Organizzare N soluzioni candidate lungo la dimensione batch in un tensore di codifica di forma [N, D]. Variabili continue, discrete o codifiche a più segmenti possono essere espresse tramite tensori di campo o blocchi raggruppati, mantenendo tipo di dato e posizione sul dispositivo uniformi.
- Batch come dimensione esterna: di norma N viene posto nello strato più esterno, così lo stesso operatore viene eseguito in modo vettorizzato sull'intero batch.
- Blocchi di campo: se un individuo è composto da più segmenti di parametri, può essere suddiviso in [N, D1] + [N, D2] + … mantenendo un'archiviazione contigua.
- Gestione della lunghezza variabile: gli individui di lunghezza variabile vengono gestiti con padding e maschera oppure con bucketing, per evitare che strutture eterogenee compromettano il calcolo in batch.
Matricializzazione dei risultati di valutazione: [N, M] e [N, K]
Una singola valutazione in batch produce una matrice di fitness [N, M]; obiettivi multipli, vincoli multipli e metriche aggiuntive possono essere affiancati in [N, M+K] o archiviati in tabelle separate, evitando di chiamare la funzione di valutazione in un ciclo su singoli individui.
Gestione unificata dello stato tensoriale
Generazione, stato del generatore casuale, iperparametri della strategia, soluzione ottima, cache storica, stato di ranking o campionamento confluiscono anch'essi in tensori o in un contenitore di stato strutturato, garantendo riproducibilità, tracciabilità e aggiornamenti in batch.
Vantaggi e limiti dell'organizzazione
I tensori unificati riducono gli scambi tra host e dispositivo, abbassano il costo dei cicli e forniscono una base dati per il parallelismo dei successivi operatori; occorre però gestire la validità delle maschere, lo spreco del padding, la crescita dimensionale con obiettivi multipli e il costo di sincronizzazione dello stato.
Layout tensoriale di popolazione, valutazione e statoLa popolazione è codificata come tensore [N, D], una singola valutazione in batch produce la matrice di fitness [N, M], mentre obiettivi o vincoli multipli possono essere estesi a [N, M+K]; anche generazione, soluzione ottima e stato del generatore casuale risiedono in modo unificato sul dispositivo sotto forma di tensori, così che l'aggiornamento di ogni generazione avvenga interamente sulla stessa dimensione batch, riducendo gli scambi tra host e dispositivo e il costo dei cicli su singoli individui.