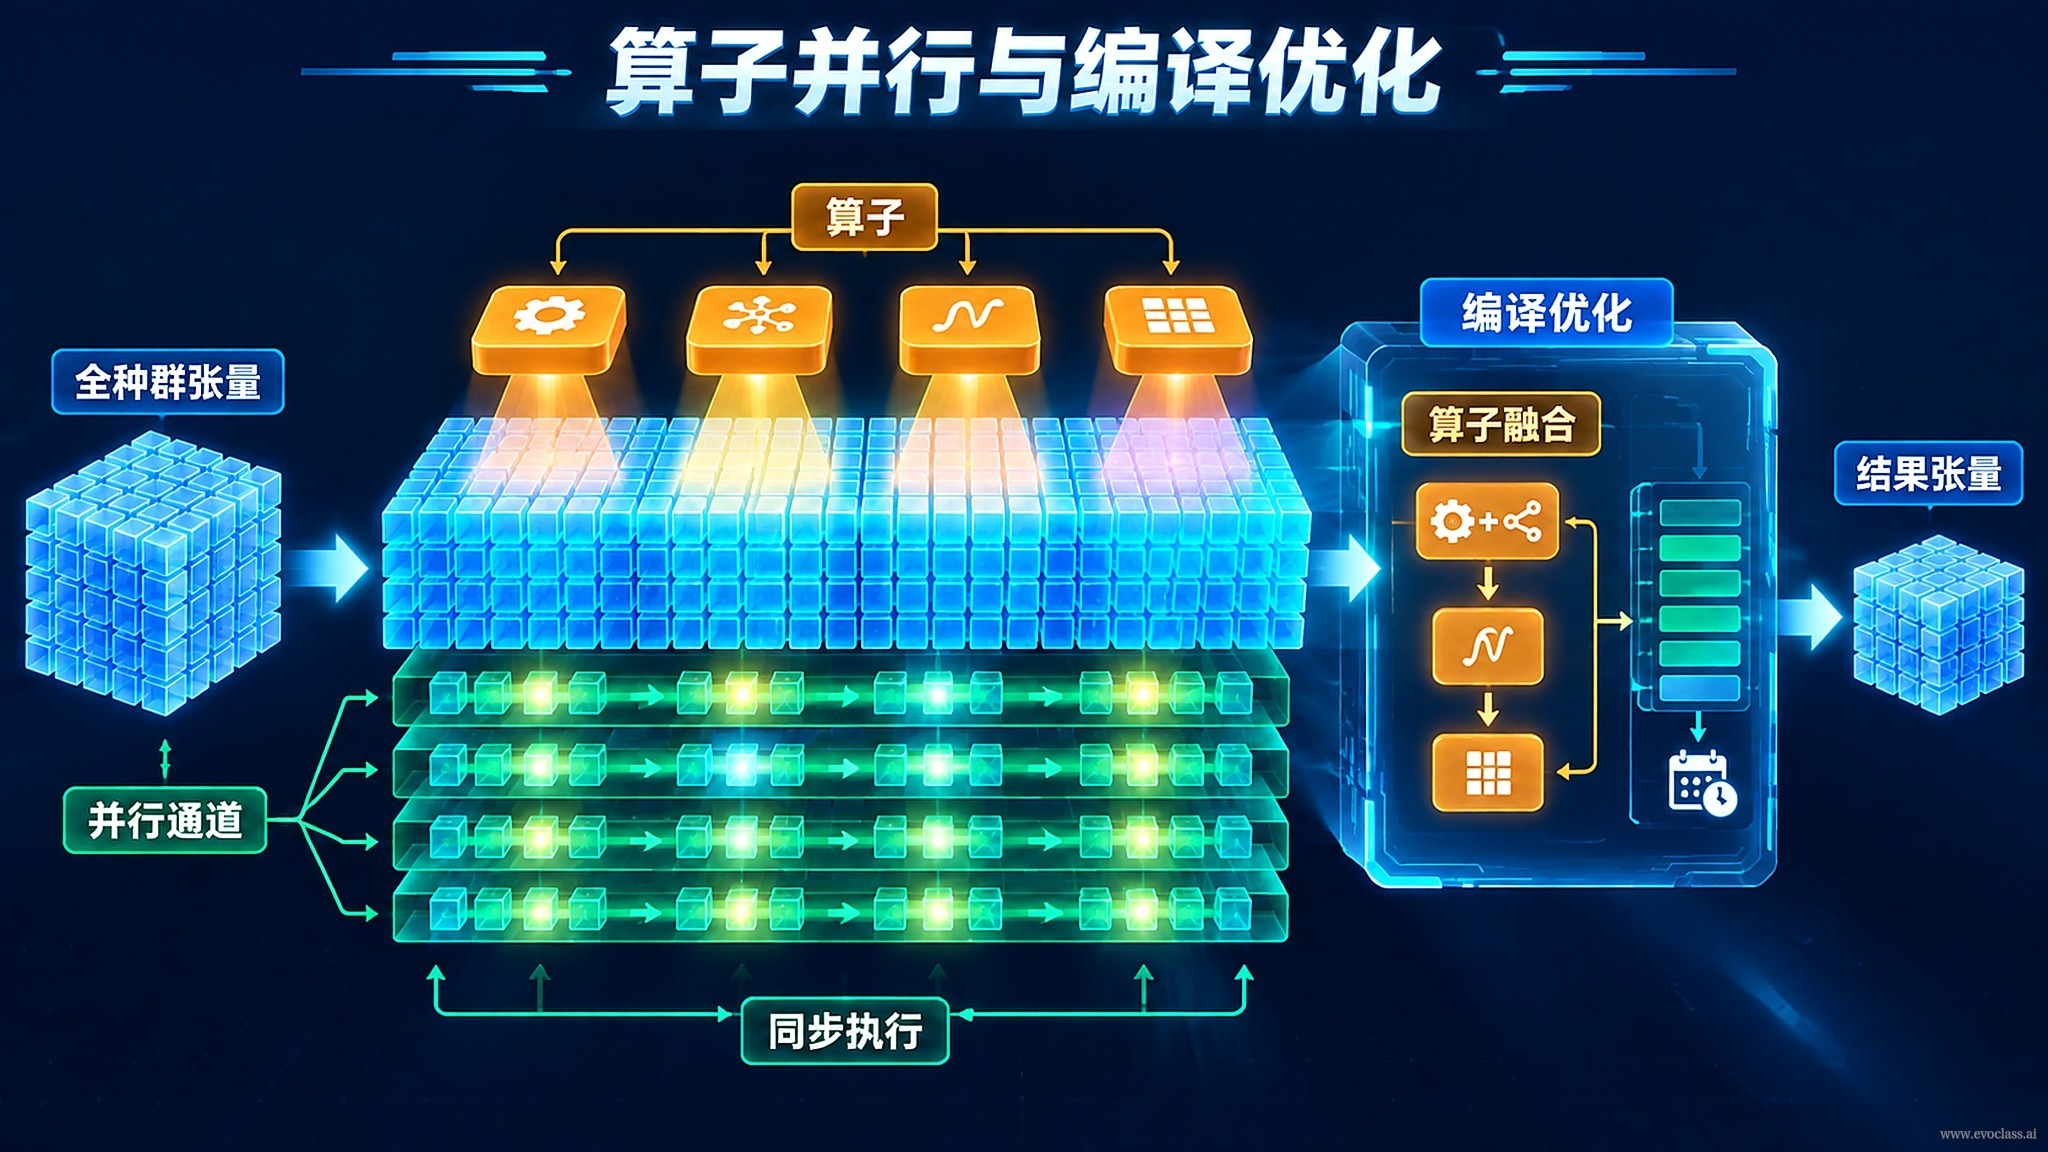
Nel EvoX moderno substrato di calcolo, l'unità minima di esecuzione degli operatori evolutivi non è più il "individuo", ma l'interatensore di popolazione: operatori come mutazione, crossover e selezione coprono tutti gli individui con una sola chiamata; su questa base,la compilazione del grafo computazionaleorganizza la sequenza di operatori in un piano di esecuzione ottimizzabile, migliorando l'efficienza di esecuzione senza alterare la semantica dell'algoritmo.
Parallelismo degli operatori: evoluzione batch a livello di tensore
- Operatori a livello di tensore: mutazione, crossover e selezione possono agire direttamente su un tensore di popolazione di forma [N, D] (dove N è la dimensione della popolazione e D la dimensionalità delle variabili decisionali), e una singola chiamata dell'operatore copre tutti gli N individui.
- Eliminazione del ciclo per singolo individuo: non è più necessario scrivere
for ind in population: ind = mutate(ind)questo tipo di ciclo seriale in Python/CPU, riducendo così l'overhead dovuto alle frequenti chiamate di funzione e alle invocazioni del framework. - Scambiare la dimensione batch con il throughput: una volta che la dimensione degli individui funge da dimensione batch, gli operatori vengono eseguiti sul dispositivo in modo massivamente parallelo, e il throughput dell'evoluzione batch cresce con la dimensione della popolazione.
Compilazione del grafo computazionale: dalla sequenza di operatori al piano di esecuzione
Organizzando le dipendenze tra operatori "mutazione → crossover → selezione" in ungrafo computazionale, il compilatore può eseguire un'ottimizzazione globale sull'intero grafo, invece di limitarsi a richiamare implementazioni pronte operatore per operatore:
- Fusione di operatori: combina più operazioni element-wise in un unico kernel, riducendo la creazione di tensori intermedi e le letture/scritture ripetute.
- Generazione e schedulazione dei kernel: genera kernel efficienti per il sottografo fuso, completando l'intera generazione evolutiva con un numero minore di avvii di kernel.
- Riutilizzo della memoria: pianifica in anticipo i buffer per i risultati intermedi, riducendo l'overhead aggiuntivo dovuto all'allocazione della memoria e al trasferimento dei dati.
L'efficienza cambia, la semantica no
Occorre distinguereil "come calcolare"dail "cosa calcolare". Il parallelismo degli operatori e l'ottimizzazione della compilazione modificano solo le modalità di esecuzione — numero di kernel, dimensione dei tensori intermedi, strategia di memoria e schedulazione — senza alterare il significato logico di mutazione, crossover e selezione. Il livello algoritmico continua a combinare gli operatori secondo la semantica evolutiva, quindi con lo stesso seed casuale la traiettoria evolutiva e i risultati prima e dopo l'ottimizzazione dovrebbero coincidere. In una frase: la tensorizzazione risolve la questione "quanto velocemente si calcola in batch", la compilazione del grafo computazionale risolve "quanto è ottimale la schedulazione dei kernel", mentre "cosa si calcola" rimane invariato.
Flusso parallelo degli operatori sull'intero tensore di popolazioneMutazione, crossover e selezione non iterano più su singoli individui: ciascuno copre l'intero tensore di popolazione [N, D] con una sola chiamata, e la dimensione degli individui funge da dimensione batch per amplificare il throughput; una volta che questi operatori formano un grafo computazionale in base alle loro dipendenze, il compilatore può eseguire fusione di operatori, generazione di kernel e riutilizzo della memoria, modificando solo le modalità di esecuzione, mentre la semantica dell'algoritmo e la traiettoria evolutiva con lo stesso seed casuale rimangono invariate.