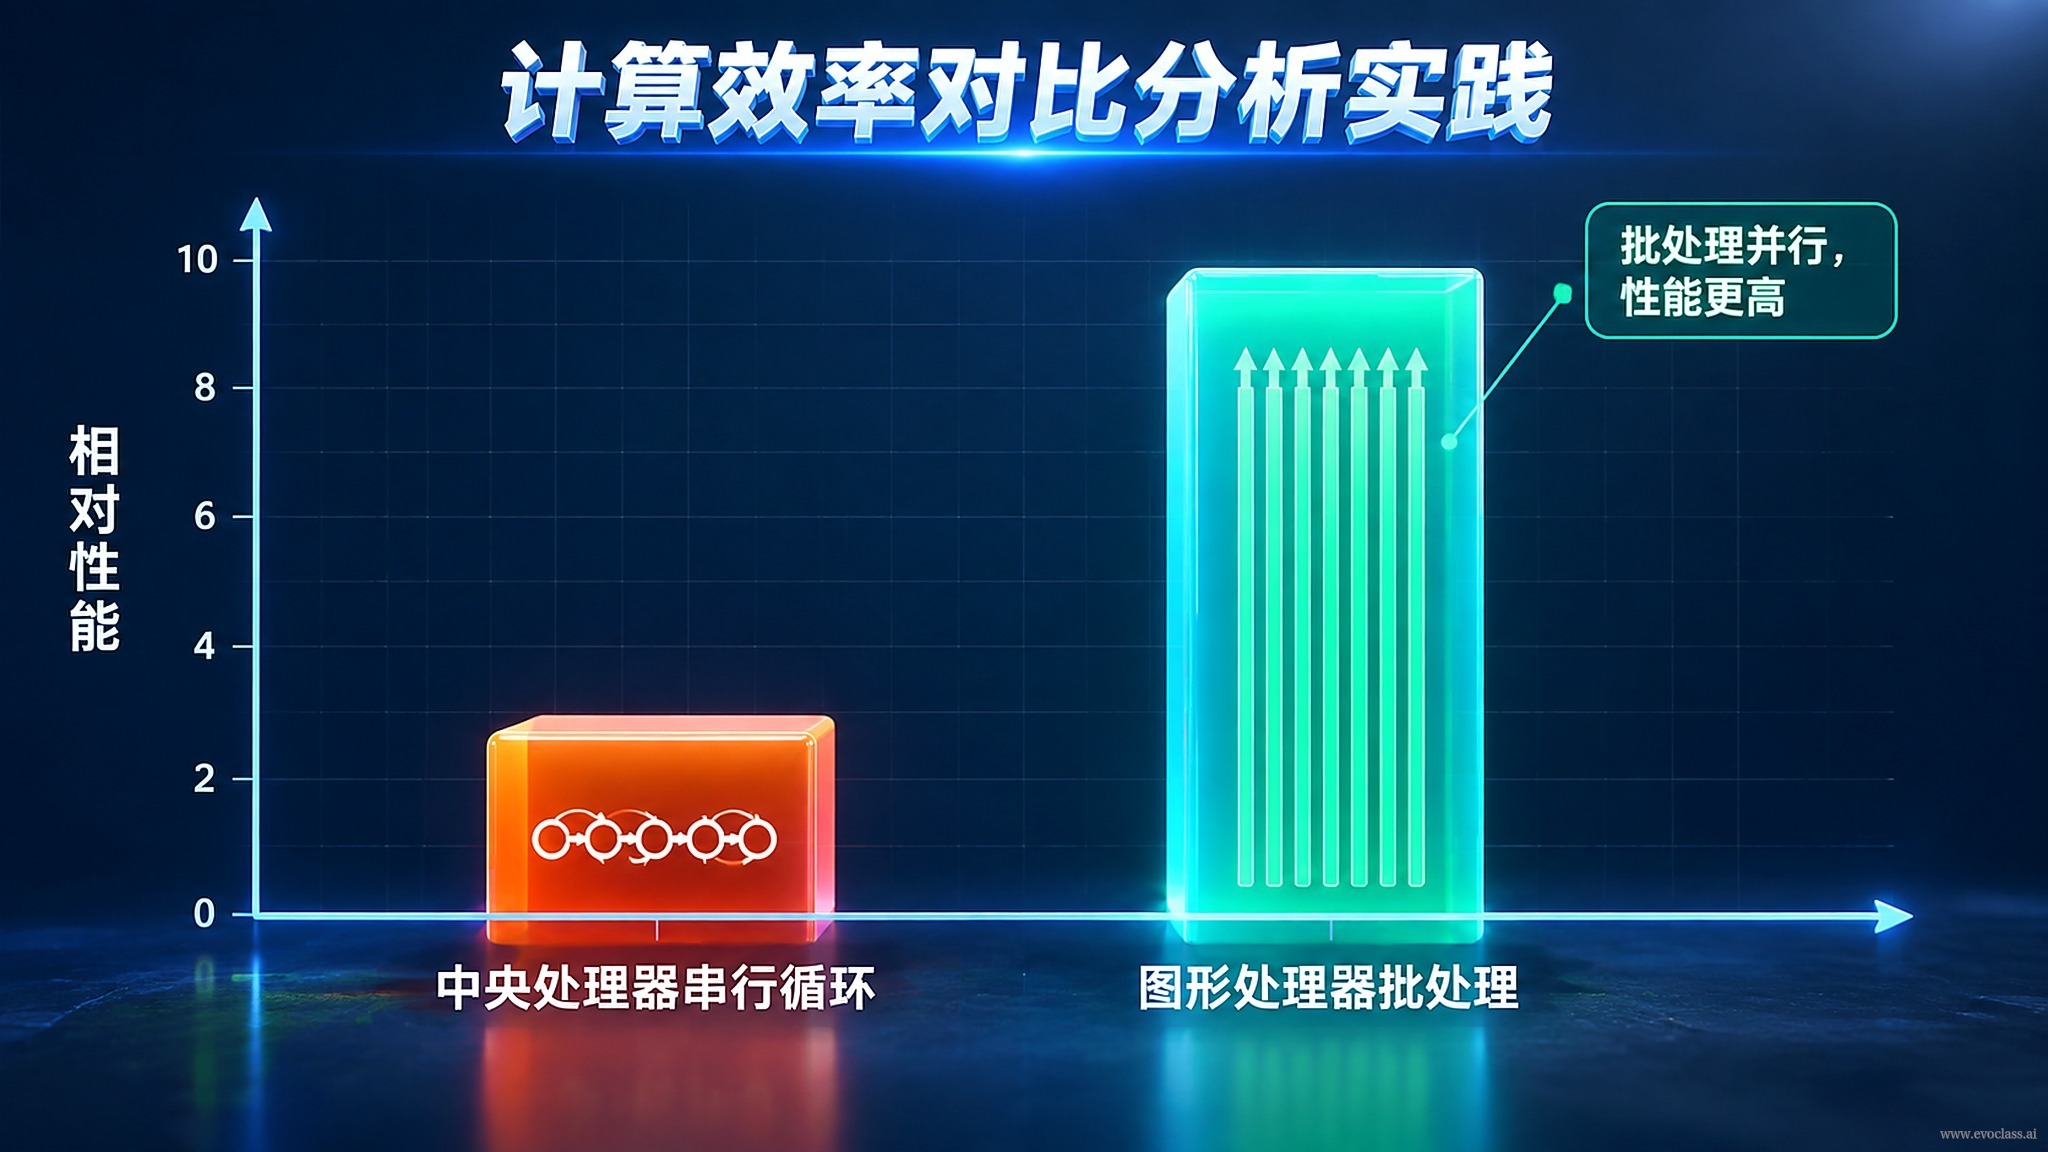
Questa pagina traduce il «confronto dell'efficienza computazionale» in una pratica riproducibile:sul medesimo task evolutivo, confronta l'efficienza end-to-end tra la tradizionale iterazione seriale degli individui su CPU e l'elaborazione batch tensoriale su GPU di EvoX. L'obiettivo non è memorizzare la conclusione «la GPU è più veloce», ma capire da dove proviene realmente l'accelerazione offerta dal parallelismo tensoriale, quali siano i costi e dove si trovino i limiti.
Due baseline, lo stesso task
- Baseline seriale su CPU: chiama la funzione di valutazione individuo per individuo tramite un ciclo; ogni generazione richiede N schedulazioni indipendenti, aggiornamenti di stato e aggregazione dei risultati. Il controllo del ciclo, l'overhead dell'interprete e gli accessi sparsi alla memoria diluiscono la potenza di calcolo effettiva: più numerosi sono gli individui, maggiore è l'incidenza di questi costi «non di calcolo».
- Implementazione tensoriale su GPU: EvoX organizza popolazione, input di valutazione e stato di esecuzione come tensori, eseguendo valutazioni e operatori in batch sulla GPU; una singola chiamata copre l'intero insieme di candidati, riducendo notevolmente i cicli seriali e il numero di schedulazioni.
Protocollo di misurazione: rendere il confronto riproducibile
Un confronto riproducibile devefissare problema, dimensione della popolazione, numero di generazioni e seed casuale, quindi registrare: wall-clock per generazione, tempo totale, throughput (valutazioni/secondo), speedup, oltre a utilizzo della GPU e occupazione della memoria video. Prima del timing occorreil warm-upper escludere l'effetto della prima compilazione e dell'allocazione della memoria video, ed eseguire ai punti di misurazione lasincronizzazione del dispositivo, misurando separatamente il tempo di calcolo e il tempo di trasferimento dati host-dispositivo. Se manca anche uno solo di questi passaggi, lo speedup ottenuto può risultare distorto.
Da dove deriva la differenza e quali sono i vincoli
- Origine dei vantaggi: parallelismo batch, operatori tensoriali e parallelismo intra-dispositivo consentono a una singola chiamata di elaborare l'intero insieme di candidati, completando più valutazioni per unità di tempo.
- Vincoli: dimensione del batch, dimensionalità del problema, grado di vettorizzabilità della funzione di valutazione, overhead di copia host-dispositivo e overhead di lancio dei kernel influenzano tutti lo speedup finale. Un batch troppo piccolo viene eroso dai costi di lancio; se la funzione di valutazione non è vettorizzabile, il batch non può quasi esprimere il proprio potenziale.
Conclusioni pratiche
L'ordine corretto è:verificare prima se la funzione di valutazione può essere parallelizzata in batch, poi confrontare le implementazioni CPU e GPU. Il vantaggio di efficienza deve tradursi concretamente nel «ottenere più generazioni o più soluzioni candidate a parità di budget computazionale» e su questa base decidere modalità di deployment e progettazione degli esperimenti, senza inseguire semplicemente un bel numero di speedup.
Confronto di efficienza tra CPU seriale ed elaborazione batch su GPUNel confronto, la baseline seriale su CPU valuta individuo per individuo in un ciclo: ogni generazione richiede N schedulazioni e aggiornamenti di stato, e l'overhead dell'interprete e degli accessi alla memoria diluisce la potenza di calcolo effettiva; l'elaborazione batch su GPU organizza popolazione e input di valutazione come tensori, coprendo l'intero insieme di candidati con una sola chiamata. Lo speedup è vincolato dalla dimensione del batch, dal grado di vettorizzabilità della funzione di valutazione e dall'overhead di copia host-dispositivo.