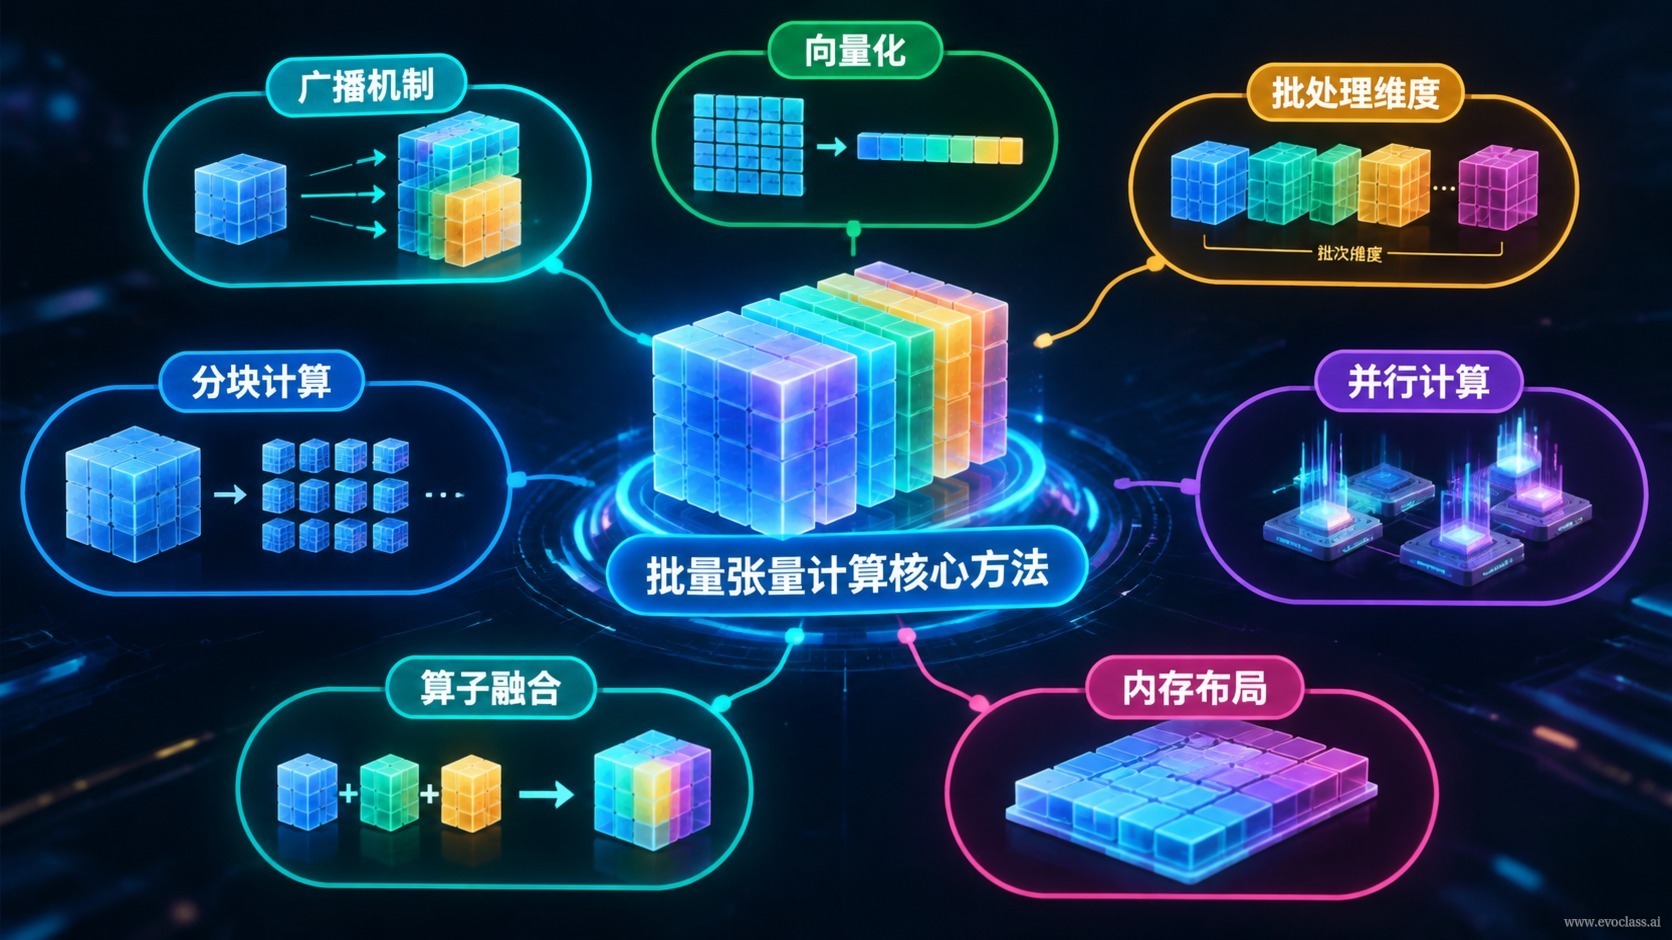
Nella base tensoriale di EvoX,il calcolo tensoriale in batchsi colloca a livello di espressione algoritmica: mappa in modo uniforme candidati, valutazioni e stati del ciclo evolutivo intensori con dimensione batch, affidandoli poi a operatori batch GPU-friendly e a un grafo computazionale compilato. L'obiettivo è chiaro: trasformare l'«evoluzione seriale individuo per individuo» in un'«evoluzione parallela dell'intera popolazione», facendo sì che la potenza di calcolo agisca davvero sulla ricerca stessa, anziché essere consumata dalla schedulazione e dall'avvio.
1. Esprimere il processo evolutivo come tensori
Convenendo che la dimensione batch N rappresenti il numero di candidati (individui), i tre elementi dell'evoluzione si traducono direttamente in tensori:
- Tensore dei candidati: la popolazione X è organizzata come [N × D], dove D è il numero di variabili decisionali di un singolo candidato.
- Tensore degli obiettivi: obiettivi e vincoli F sono organizzati come [N × M], dove M è il numero di voci obiettivo/vincolo; nel caso multi-obiettivo, ciascun obiettivo corrisponde a una colonna diversa di F.
- Grandezze di stato: generazione, valore ottimo corrente, passo, ecc. sono mantenuti tramite buffer scalari o tensori ridotti, anziché registrati individuo per individuo con oggetti Python.
In questo modo crossover, mutazione, selezione e valutazione vengono tutti processati in batch lungo la dimensione N, e nel ciclo evolutivo non compaiono più rami o flussi di controllo individuo per individuo.
2. Operatori batch: da N chiamate per singolo candidato a una singola operazione batch
Tre espressioni minime e confrontabili delineano la forma di base degli operatori batch:
- Mutazione: X′ = X + σ·randn(X); l'intero batch di candidati riceve in una sola operazione batch la propria perturbazione casuale, con σ che ne controlla l'intensità.
- Selezione: idx = topk(F, k); in un'unica operazione si selezionano gli indici dei primi k candidati in base alla fitness degli N candidati.
- Valutazione: Y = fθ(X); una singola forward batch o una simulazione batch sostituisce N chiamate per singolo candidato.
Il punto cruciale non è un operatore specifico, ma il fatto che tutti i candidati condividano lo stesso grafo di operazioni tensoriali: una singola chiamata batch riduce i costi dell'interprete e quelli di avvio dei kernel, facendo sì che la potenza di GPU e multi-core agisca davvero sulla ricerca evolutiva. Anche la gestione dei vincoli e delle violazioni dei limiti può essere eseguita all'interno della stessa operazione batch tramite tensori maschera, senza dover deviare su rami separati per singoli candidati.
3. Ottimizzazione del grafo computazionale e metriche di throughput
Esprimere l'evoluzione su più generazioni come un grafo di flusso dati compilabile permette di spremere ulteriormente le prestazioni:Fusione degli operatoririduce il numero di avvii dei kernel,Parallelismo intra-batchconsente a tutti i candidati di essere eseguiti simultaneamente,Esecuzione asincronasovrappone calcolo e trasferimento dei dati,Riutilizzo della memoriariduce le allocazioni di tensori intermedi. Di conseguenza, anche le metriche di prestazione dovrebbero passare dalla «latenza per passo» acandidati/s o generazioni/sdi throughput: con l'esecuzione in batch, una sola chiamata elabora l'intero batch di candidati, e solo il throughput complessivo riflette davvero l'efficienza della ricerca.
Mappa dei metodi chiave del calcolo tensoriale in batchLa mappa esprime il processo evolutivo come tensori con dimensione batch: la popolazione X è N×D, obiettivi e vincoli F sono N×M, e crossover, mutazione, selezione e valutazione sono tutti processati in batch lungo la dimensione N. Mutazione, selezione topk e valutazione forward in batch richiedono una sola chiamata batch, e le metriche di prestazione passano dalla latenza per passo al throughput in candidati/s.