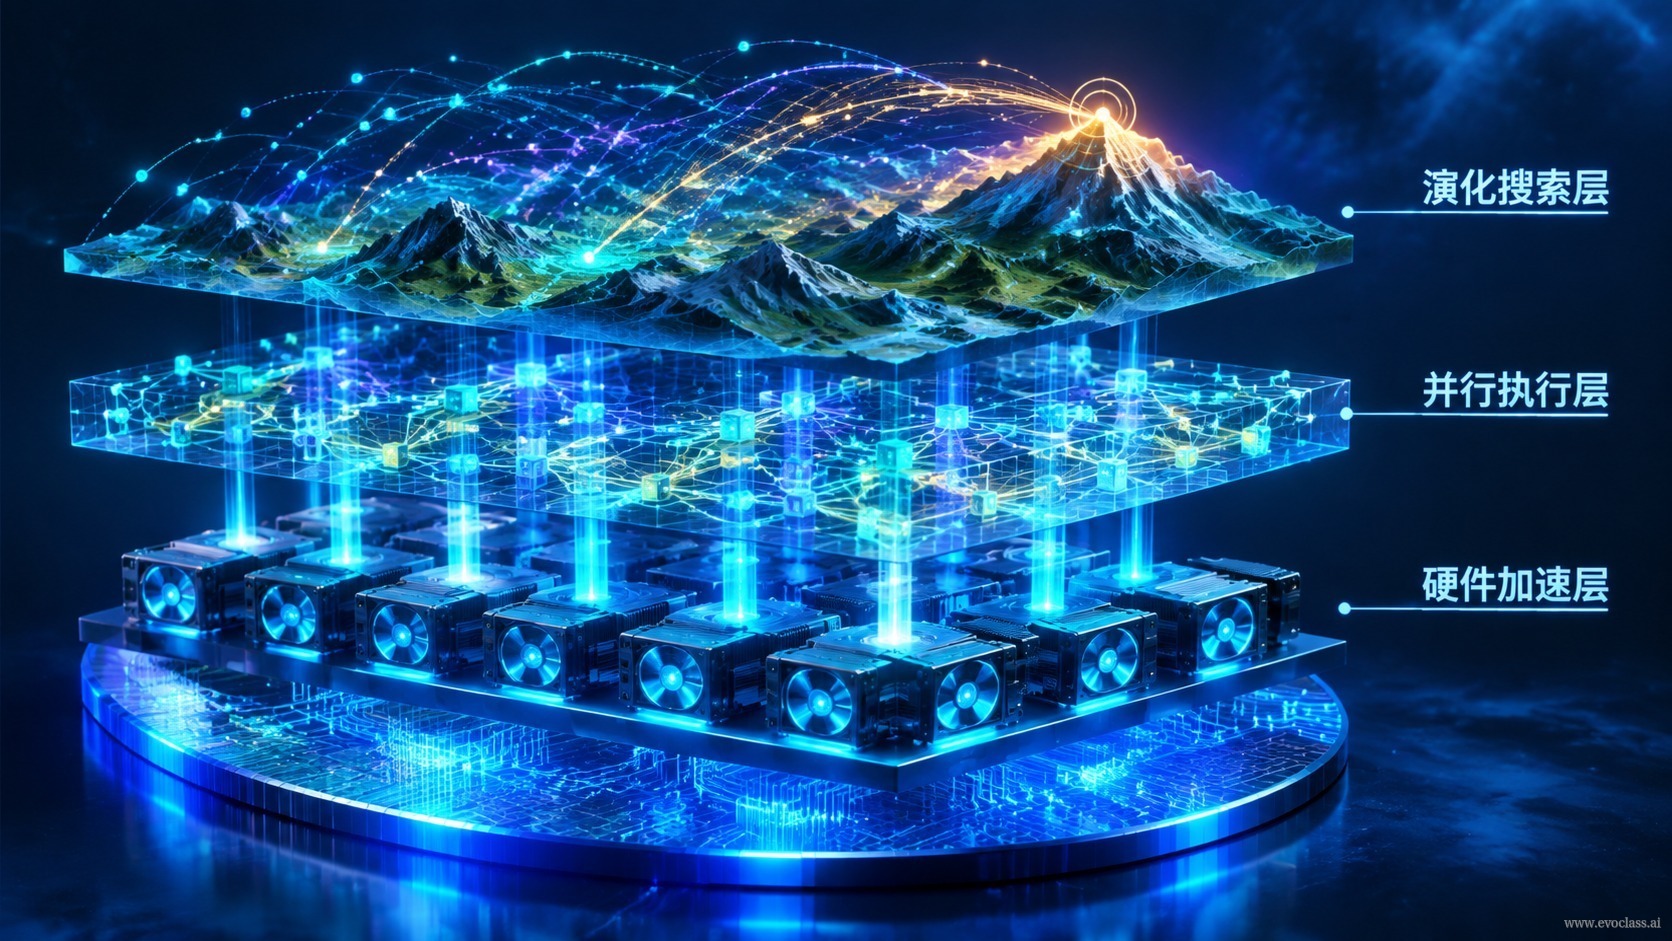
Ciò che permette a EvoX di sostenerel'esplorazione evolutiva parallela ad alta intensitàsi riassume in una frase:dalla lista di candidati al grafo computazionale tensoriale. Gli esperimenti evolutivi tradizionali trattano ogni individuo come un oggetto Python indipendente, modellandolo e valutandolo uno per uno; quando il numero di candidati cresce fino a migliaia o decine di migliaia, il vero collo di bottiglia non è più l'algoritmo in sé, bensì l'overhead di scheduling, sincronizzazione e I/O per singolo candidato. L'approccio di EvoX consiste nel riorganizzare popolazione, valutazione e stato di runtime in tensori calcolabili nel loro complesso, per poi affidarne l'esecuzione batch a GPU e risorse eterogenee tramite un Runtime unificato, supportando così una ricerca evolutiva su larga scala, multi-obiettivo e con soluzioni multiple in parallelo.
I tre oggetti della tensorializzazione
La tensorializzazione non è un'ottimizzazione locale di un singolo punto, ma attraversa i tre livelli del ciclo evolutivo. Se anche un solo livello torna a un ciclo oggetto per oggetto, il parallelismo si blocca proprio in quel livello.
- Tensorializzazione della popolazione: i parametri, i geni o le strategie degli individui non vengono più iterati ciclo per ciclo su oggetti Python, ma sono organizzati secondola dimensione batchin tensori, dove le differenze tra gli individui sono veicolate da una dimensione del tensore.
- Tensorializzazione della valutazione: fitness, vincoli, metriche multi-obiettivo e risultati di valutazioni tramite simulazione o modelli possono essere calcolati in batch; i candidati dello stesso batch condividono una singola chiamata al dispositivo, riducendo sensibilmente l'overhead di scheduling e I/O per singolo candidato.
- Tensorializzazione dello stato: gli stati di runtime come generazioni evolutive, semi casuali, cache e metriche di monitoraggio vengono gestiti in modo unificato, così che gli esperimenti accelerati in parallelo restinoriproducibili e tracciabili.
Grafo computazionale e architettura unificata
Elevando la lista di candidati agrafo computazionale tensoriale, il parallelismo degli operatori e l'ottimizzazione della compilazione hanno finalmente spazio di manovra: la dimensione della popolazione e il grado di parallelismo della valutazione possono scalare con la potenza di calcolo, invece di essere bloccati dai cicli dell'interprete. A completare il quadro è l'architettura unificata: algoritmo, problema, workflow e monitoraggio, scheduler Runtime sono disaccoppiati tra loro: gli algoritmi sono componibili, i problemi sono plug-in, le risorse di calcolo eterogenee sono gestite in modo unificato, e chi scrive algoritmi non deve preoccuparsi anche dello scheduling di basso livello.
Il beneficio più diretto di questa base èSuperare il collo di bottiglia seriale: sostituisce il ciclo seriale tradizionale su CPU, realizzando un'accelerazione su larga scala su GPU e risorse eterogenee, e offrendo una base di throughput stabile per l'esplorazione ad alta intensità; nello stesso tempo reale è possibile esplorare più candidati, più combinazioni di obiettivi o più ripetizioni casuali.
Ad esempio, si consideri un esperimento evolutivo che richiede la valutazione di un gran numero di soluzioni candidate. L'approccio tradizionale consiste nel chiamare la funzione di valutazione candidato per candidato sulla CPU, dove scheduling, sincronizzazione e cicli Python possono dominare i tempi; EvoX invia la matrice dei candidati al dispositivo in batch, affidando al Runtime lo scheduling di operatori e valutazioni e registrando in modo unificato stato e metriche di monitoraggio, così da poter esplorare più candidati, più combinazioni di obiettivi o più ripetizioni casuali nello stesso tempo reale. È proprio questo il supporto ingegneristico necessario quando problemi multi-obiettivo del mondo reale (ad esempio, nella progettazione di profili alari supercritici, dove il rapporto portanza-resistenza in crociera e il coefficiente di portanza critico di buffet si limitano a vicenda) richiedono di conservare una gamma diversificata di soluzioni candidate.
Panoramica dell'ecosistema della base di calcolo moderna di EvoXLa figura riassume la base di EvoX come un passaggio dalla lista di candidati al grafo computazionale tensoriale: popolazione, valutazione e stato di runtime sono tensorializzati in modo unificato su tre livelli, per poi essere eseguiti in batch su GPU e risorse eterogenee tramite il Runtime. Così algoritmo, problema, workflow e monitoraggio sono reciprocamente disaccoppiati; quando la potenza di calcolo si espande, il parallelismo non viene bloccato dai cicli per singolo candidato, e nello stesso tempo reale è possibile esplorare più candidati e combinazioni di obiettivi.