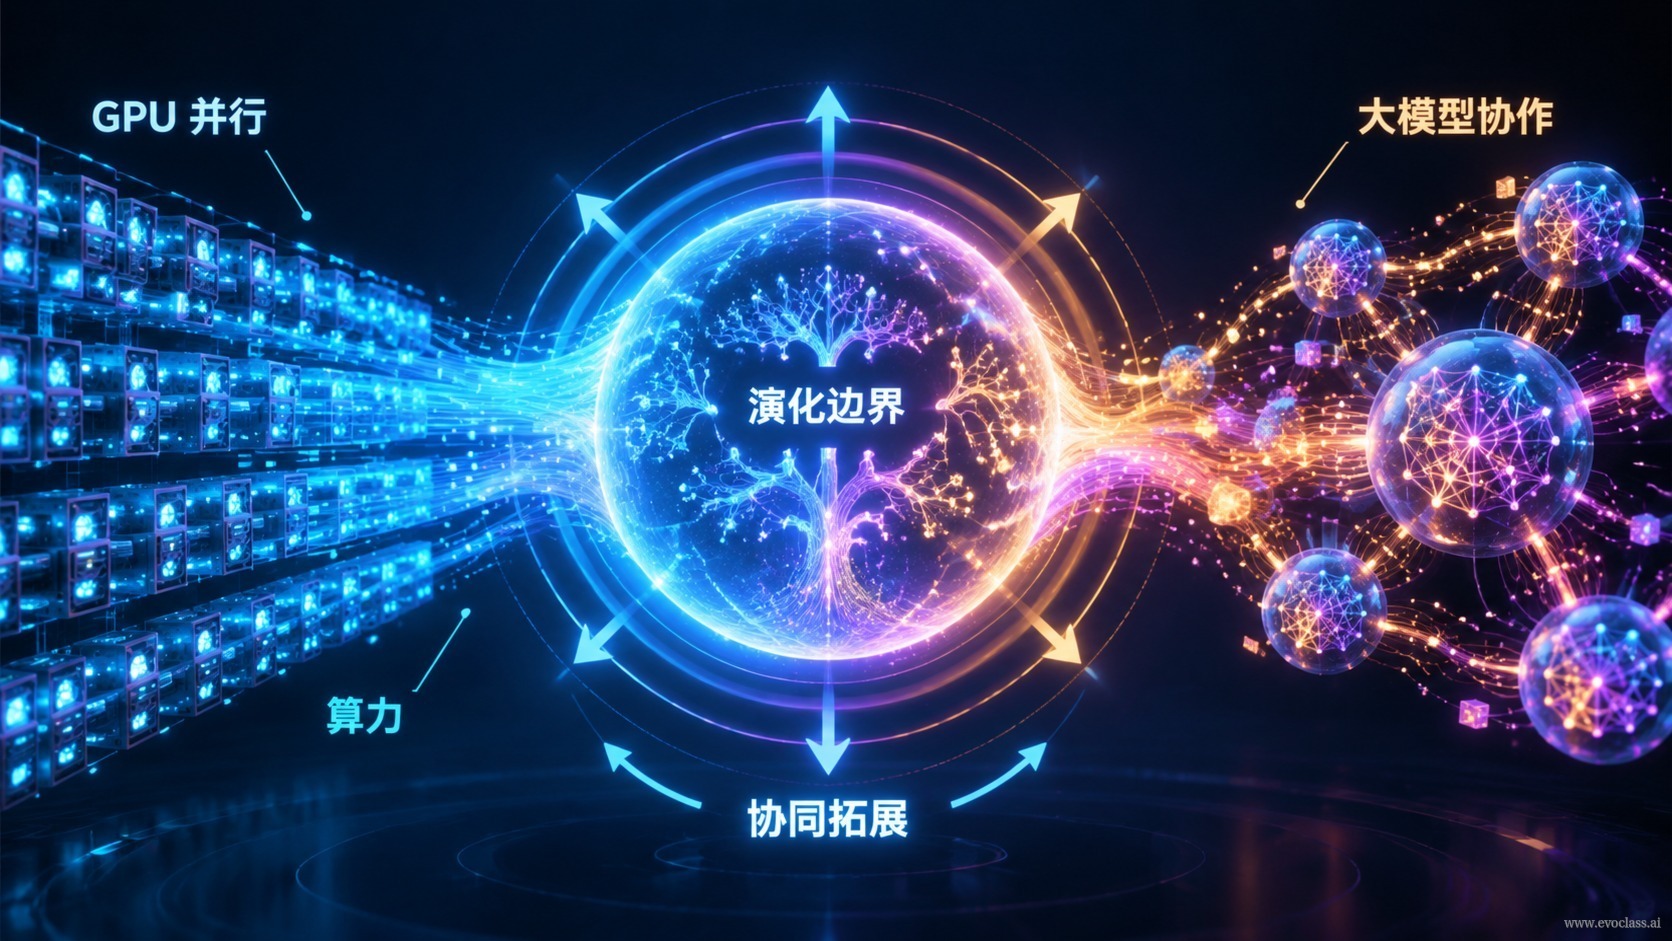
Il calcolo evolutivo è stato a lungo vincolato da un problema concreto: quanti candidati si possono effettivamente valutare in un tempo limitato. Oggi questo vincolo è stato allentato contemporaneamente da due forze ingegneristiche —la potenza di calcolo parallelo delle GPUela generazione semantica dei grandi modelli. Insieme esse costituiscono il duplice fondamento ingegneristico del calcolo evolutivo:la potenza di calcolo determina «quanti candidati si possono esplorare in una volta», il grande modello determina «quali forme di candidati si possono esplorare», e insieme estendono il confine dell'oggetto evolutivo dai parametri numerici ai programmi, alle strutture dei modelli e ai meccanismi algoritmici stessi.
Il fondamento computazionale: spostare lo spazio dei candidati dal seriale ai tensori
Nelle implementazioni tradizionali la valutazione della popolazione è un ciclo seriale sulla CPU: si elabora un solo individuo alla volta e il costo di scheduling si accumula con la dimensione della popolazione. I fondamenti open source rappresentati da EvoX organizzano candidati, risultati di valutazione e stato dell'algoritmo in modo unificato cometensori calcolabili nel loro complesso: la mutazione agisce sull'intera popolazione, e valutazione e aggiornamento dello stato entrano insieme alla selezione nel grafo computazionale, dove ricevono ottimizzazioni di compilazione. Il risultato ingegneristico diretto è che «esplorare decine di migliaia di candidati in simultanea» è passato da trucco di laboratorio a prassi ordinaria.
Questi fondamenti suddividono il sistema in algoritmi, moduli di problema, workflow e scheduler Runtime: il ricercatore deve concentrarsi solo su «come evolvere», mentre il Runtime si occupa di distribuire il calcolo in lotti su GPU, dispositivi acceleratori o cluster distribuiti. Occorre però vedere chiaramente che la potenza di calcolo risolve il problema dellathroughput, non quello dell'«intelligenza». Non giudica se un candidato sia buono o meno, ma si limita a calcolare in un'unica passata la fitness dell'intera popolazione. È ilsupporto di basedell'espansione dello spazio dei candidati, ma non ne determina la forma.
Il fondamento semantico: elevare la forma dei candidati da vettori numerici a soluzioni strutturali
Il contributo dei grandi modelli non sta nel calcolare più velocemente, ma nel fatto che comprendono codice, conoscenza di dominio e contesto del compito, possedendo unacapacità di generazione a livello semantico. Per questo possono costruire candidati strutturalmente complessi — un frammento di codice risolutivo direttamente richiamabile, la topologia di un modello surrogato — invece di limitarsi a produrre un vettore numerico. Lo spazio della «forma» dei candidati si apre così.
L'espansione in tre livelli del confine dell'oggetto evolutivo
- Parametri numerici: l'impostazione classica, in cui i membri della popolazione sono un insieme di valori di parametri in una struttura fissa.
- Programma / struttura del modello: i membri della popolazione diventano frammenti di codice eseguibile, oppure topologie di reti e modelli surrogati. Proprio la capacità generativa dei grandi modelli è la porta d'ingresso a questo livello.
- Meccanismo algoritmico: persino il processo di «come generare e come valutare» entra a far parte dell'oggetto evoluto. È proprio questa la premessa che rende possibile il successivo «migliorare l'evoluzione con l'evoluzione» (come MetaDE, AutoPSO).
Prendiamo l'ottimizzazione di un profilo alare: l'approccio tradizionale può cercare solo su alcuni parametri numerici predefiniti; quando invece un grande modello può leggere e scrivere il codice risolutivo e costruire la struttura di un modello surrogato, e la GPU può valutare in parallelo un'intera popolazione in lotti, l'oggetto della ricerca si sposta da «un insieme di valori di parametri» a «un insieme di schemi di generazione e valutazione in sé».
Complementari, non sostitutivi
I due sono in rapporto di complementarità: la potenza di calcolo amplia l'Ampiezzadella ricerca, il grande modello migliora laqualità e la complessità morfologica dei candidati; se manca uno dei due, l'espansione del confine non sussiste. Con la sola potenza di calcolo e senza generazione semantica, l'oggetto della ricerca resta confinato in codifiche scritte a priori; con la sola capacità generativa e senza valutazione in lotti, un numero enorme di candidati non può essere selezionato in tempi accettabili.
Il costo dell'espansione del confine
L'espansione del confine introduce al contempo nuovi vincoli: primo,l'aumento del costo di valutazione, poiché una singola valutazione può passare da millisecondi a minuti; secondo,la maggiore difficoltà di verifica della correttezza, poiché il codice generato può non compilare o non soddisfare i vincoli fisici e ingegneristici; terzo,la maggiore ambiguità dei criteri per stabilire una «risposta utilizzabile», che richiede di integrarsi con il bilanciamento multi-obiettivo e le decisioni degli esperti.
Diagramma di flusso: l'espansione dei confini evolutivi tramite la collaborazione tra GPU parallele e grandi modelliL'illustrazione mostra che l'espansione dei confini evolutivi dipende da un duplice fondamento: GPU e Runtime tensorizzato spostano la valutazione della popolazione dal ciclo seriale al parallelismo in lotti, determinando quanti candidati si possono esplorare in una volta; i grandi modelli forniscono la generazione semantica, determinando quali forme di candidati si possono costruire. Una volta complementatisi, l'oggetto evolutivo può estendersi dai parametri numerici ai programmi/strutture dei modelli e, ulteriormente, ai meccanismi algoritmici, ma ciò comporta anche nuovi vincoli come i costi di valutazione, la verifica della correttezza e i criteri per stabilire la risposta.