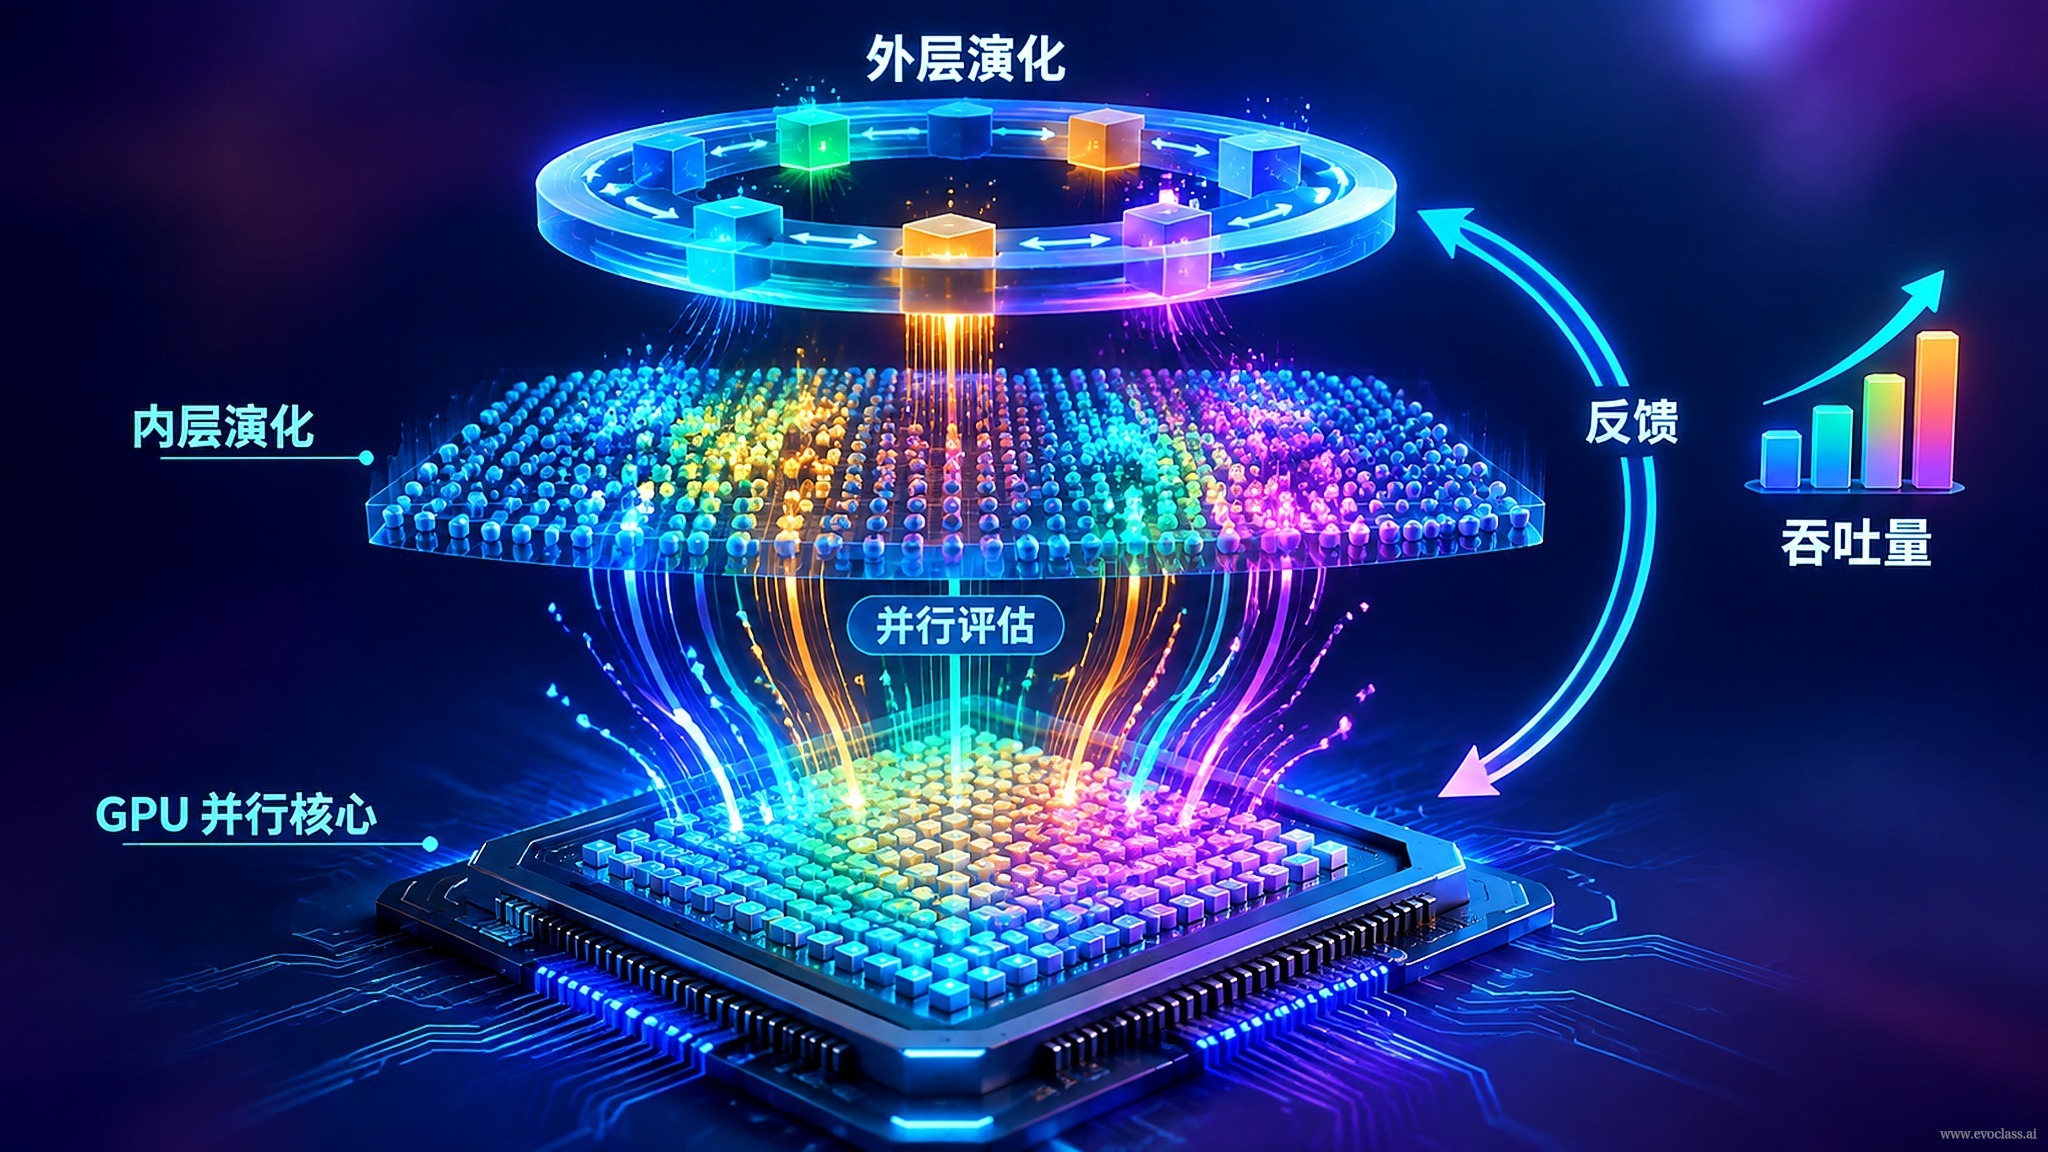
Quando gli algoritmi evolutivi vengono usati permigliorare gli algoritmi evolutivi stessi, nel sistema coesistono due livelli di calcolo: quello interno è l'esecuzione e la valutazione di un gran numero di configurazioni algoritmiche su molte istanze di task, mentre quello esterno seleziona, muta e aggiorna le configurazioni sulla base di questi risultati. Senza una solida base parallela, l'evoluzione esterna viene trascinata in un collo di bottiglia dalla valutazione sequenziale del livello interno.Il parallelismo GPUè proprio la chiave che trasforma l'"evoluzione che migliora l'evoluzione" da idea teorica in un processo eseguibile ad alto throughput: i task del livello interno vengono eseguiti in parallelo a lotti e producono continuamente dati di prestazione, e l'evoluzione esterna usa questi dati come feedback per selezionare di volta in volta configurazioni algoritmiche migliori.
Ciascuno dei due livelli ha un ruolo distinto
- Livello interno (esecuzione e valutazione): esegue in batch su GPU un gran numero di configurazioni algoritmiche candidate (iperparametri, operatori o strategie di ricerca diversi), completando esecuzione e valutazione per ogni istanza di task. La granularità fine e l'elevato numero dei task si adattano perfettamente alle caratteristiche di throughput batch della GPU.
- Livello intermedio (aggregazione del feedback): aggrega le prestazioni grezze dell'enorme mole di task interni in indicatori statistici, stima la qualità di ciascuna configurazione sull'intera distribuzione dei task e produce la fitness utilizzata dal livello esterno.
- Livello esterno (selezione delle configurazioni): prende in input il feedback statistico ed esegue selezione, mutazione o aggiornamento, generando la generazione successiva di configurazioni e reinviandola al livello interno, chiudendo così il ciclo.
Perché il parallelismo GPU è insostituibile
Nel tradizionale ciclo sequenziale, il tempo effettivo di una singola iterazione è determinato congiuntamente dal "numero di configurazioni candidate × numero di campioni di task": basta una scala leggermente maggiore per renderlo insostenibile, e il ciclo sequenziale diventa così il principale collo di bottiglia che limita il numero di configurazioni candidate e di campioni di task. Il parallelismo GPU consente a moltissimi algoritmi interni di essere eseguiti simultaneamente, riducendo il ciclo sequenziale da "collo di bottiglia principale" a "costo batch accettabile", ampliando al contempo lo spazio di configurazioni esplorabili e la quantità di campioni di task.
Meccanismo centrale: un unico ciclo chiuso
L'intero sistema può essere riassunto come un ciclo di "throughput parallelo dei task interni → aggregazione del feedback sulle prestazioni → selezione delle configurazioni nel livello esterno" : maggiore è il grado di parallelismo, più abbondanti sono i campioni di feedback, più stabile è la stima della fitness da parte del livello esterno e più affidabile è la direzione di miglioramento delle configurazioni; le configurazioni migliorate vengono poi reinviate al livello di base, entrando nella successiva tornata di throughput parallelo. È proprio questo ciclo chiuso a dotare gli algoritmi della capacità di auto-ottimizzarsi in modo continuo e a trasformare l'"evoluzione che migliora l'evoluzione" da idea teorica in un processo altamente efficiente ed eseguibile.
Architettura a due livelli di throughput evolutivo con parallelismo GPUIl diagramma mostra un ciclo chiuso: il livello interno esegue in batch su GPU un gran numero di configurazioni algoritmiche candidate e ne completa la valutazione; il livello intermedio aggrega l'enorme mole di prestazioni interne in indicatori statistici e ne ricava la fitness; il livello esterno, sulla base di questi dati, seleziona, muta e genera la generazione successiva di configurazioni, che viene poi reinviata al livello interno. Più alto è il grado di parallelismo, più densi sono i campioni di feedback, più stabile è la stima del livello esterno sulla bontà delle configurazioni e il collo di bottiglia della valutazione sequenziale si riduce a un costo batch accettabile.