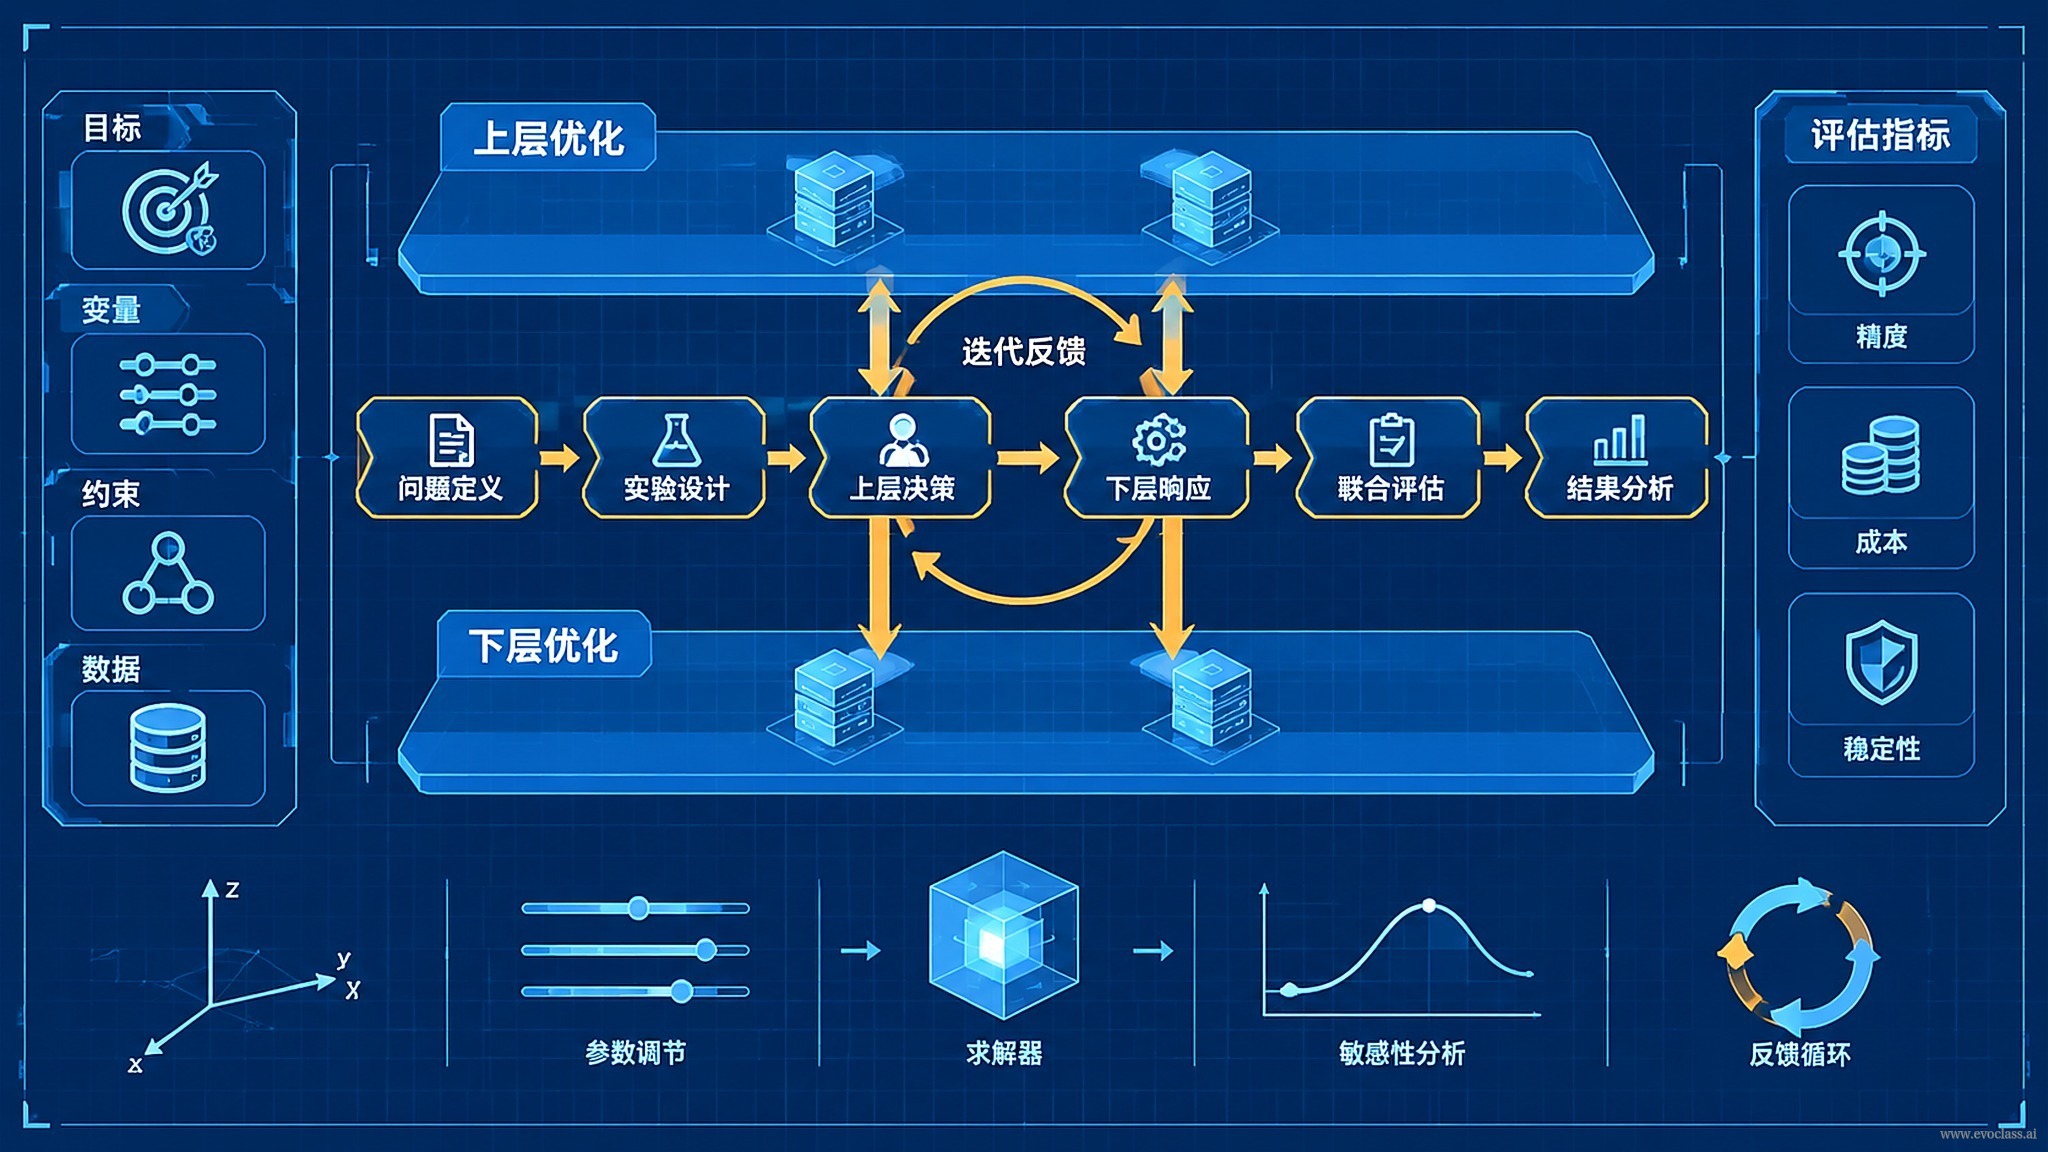
Il blueprint sperimentale di ottimizzazione bilevel deve rispondere a una domanda concreta:a quanto debba essere impostato il fattore di mutazione F dell'evoluzione differenziale (DE). L'approccio non è continuare a regolarlo manualmente, ma promuovere F da iperparametro fisso aoggetto evolvibile nel livello esterno, trattando "eseguire un task di risoluzione DE con una data impostazione di F" comeprocesso di valutazione nel livello interno; il livello esterno aggiorna la configurazione in base alle prestazioni del task del livello interno. Questo blueprint funziona perché poggia sull'infrastruttura di calcolo moderna di EvoX: popolazione, risultati di valutazione e stato dell'algoritmo sono organizzati cometensoricalcolabili nel loro insieme, così le configurazioni candidate possono essere mutate e valutate in batch ed entrare nel grafo computazionale per l'ottimizzazione in compilazione, e poi lo scheduler Runtimedistribuisce il calcolo su GPU, dispositivi di accelerazione o cluster distribuiti, comprimendo il lungo ciclo sperimentale seriale in una finestra temporale accettabile.
Task interno: trasformare le prestazioni in un segnale confrontabile
Il livello interno è unesperimento riproducibile. Si seleziona prima un task di ottimizzazione o un insieme di funzioni benchmark, poi si bloccano completamente la struttura principale del DE, la dimensionalità, il budget di valutazione e l'insieme dei seed casuali — l'unica quantità che varia è la configurazione di F trasmessa dal livello esterno. A ogni esecuzione si registrano: valore ottimo, velocità di convergenza (generazioni necessarie per raggiungere la soglia), tasso di successo, violazione dei vincoli, metriche multi-obiettivo (come l'ipervolume) e diversità dei candidati. Queste registrazioni sono tutte le informazioni che il livello esterno può "vedere" e l'unico criterio con cui può giudicare il bene e il male. La valutazione viene eseguita in batch in modalità tensoriale: lo stesso gruppo di candidati condivide un unico grafo computazionale, evitando il costo della valutazione seriale individuo per individuo.
Oggetto strategia esterna: F non è più una costante
Il livello esterno non cerca un valore numerico, ma una strategia F. Le codifiche comuni sono tre: F costante; costante a fasi, ad esempio il gene [F1, F2, F3] che cambia in base agli intervalli generazionali; una funzione di schedulazione controllata da pochi geni, ad esempio che attiva F diversi in base al tasso di successo corrente, alla varianza della popolazione o alla proporzione generazionale. Nella codifica di tipo strategico, oltre ai geni stessi, è necessario specificare le caratteristiche di input e le regole di output, altrimenti lo stesso segmento di geni produce risultati completamente diversi in implementazioni diverse.
Modalità di mappatura: dal genotipo alla configurazione a runtime
La mappatura dal genotipo esterno alla configurazione a runtime interna deve essereesplicita e riproducibile. Ad esempio, il gene [F_in, F_fin, decadimento] viene mappato in una schedulazione che decade con le generazioni: F(t) = F_in + (F_fin − F_in) × e^(−decadimento × t / T), dove t è la generazione corrente e T è il numero totale di generazioni; il gene [F1, F2, F3] viene mappato in tre segmenti a costante fissa. Lo stesso genotipo deve mappare sempre sulla stessa configurazione a runtime, altrimenti i "buoni geni" appresi dal livello esterno non sono interpretabili né trasferibili a nuovi task.
Flusso a ciclo chiuso e log obbligatori
Il ciclo completo è: la popolazione esterna genera un lotto di configurazioni F → lo scheduler Runtime distribuisce in parallelo i task DE interni in batch tensoriali → valutazione batch su GPU → aggregazione delle metriche → selezione, mutazione, crossover e aggiornamento del livello esterno → passaggio al round successivo. Qui si segue l'organizzazione a livelli di EvoX: il livello algoritmico ospita l'evoluzione esterna e la logica DE interna, i moduli dei problemi forniscono i task benchmark, lo scheduler Runtime si occupa di distribuire il calcolo batch su GPU o cluster distribuiti, e il modulo di monitoraggio raccoglie le metriche. Sul ciclo chiuso devono restare registrazioni riproducibili: seed casuali, budget di valutazione, task ID, modello hardware e criterio di arresto. Qualsiasi conclusione del tipo "il livello esterno vince" deve poter essere riprodotta alle stesse condizioni.
Condizioni al contorno e baseline: tre livelli di protezione
Protezione dal rumore:Quando la valutazione interna è molto variabile, il risultato di una singola esecuzione non è affidabile: occorre eseguire più volte in modo indipendente e riportare gli intervalli di confidenza; la fitness può essere aggregata con media, mediana o quantile peggiore, e al tempo stesso si devono separare i task di training da quelli di validazione per evitare che il livello esterno si sovradatti solo ad alcuni seed fortunati.Protezione dai costi:Quando i task interni sono costosi, si usa prima un modello a bassa fedeltà o una valutazione surrogata per un'accurata selezione preliminare, poi si rivalutano a elevata fedeltà solo pochi candidati.Protezione tramite baseline:F fisso = 0.5 e il DE adattivo classico devono essere confrontati sullo stesso piano, e occorre confermare con esperimenti di ablazione che il guadagno deriva dall'evoluzione esterna stessa, non da un maggior numero di valutazioni. Se lo spazio di ricerca esterno è troppo piccolo, l'ottimizzazione bilevel degenera in una regolazione manuale dei parametri; in tal caso si deve ampliare lo spazio di codifica, non limitarsi ad aumentare il budget.
Blueprint e flusso dell'ottimizzazione bilevelL'illustrazione prende come esempio il fattore di mutazione F dell'evoluzione differenziale: il livello interno blocca task, dimensionalità, budget di valutazione e seed casuali, lasciando variare solo la strategia F trasmessa dall'esterno, e registra valore ottimo, velocità di convergenza, tasso di successo, violazione dei vincoli, ipervolume e diversità dei candidati; il livello esterno può codificare F costante, F a segmenti o funzioni di schedulazione, che dopo una mappatura esplicita vengono valutate in batch e selezionate per l'aggiornamento. Il ciclo chiuso deve inoltre conservare seed, budget, task ID, hardware e criterio di arresto per garantire che le conclusioni siano riproducibili.