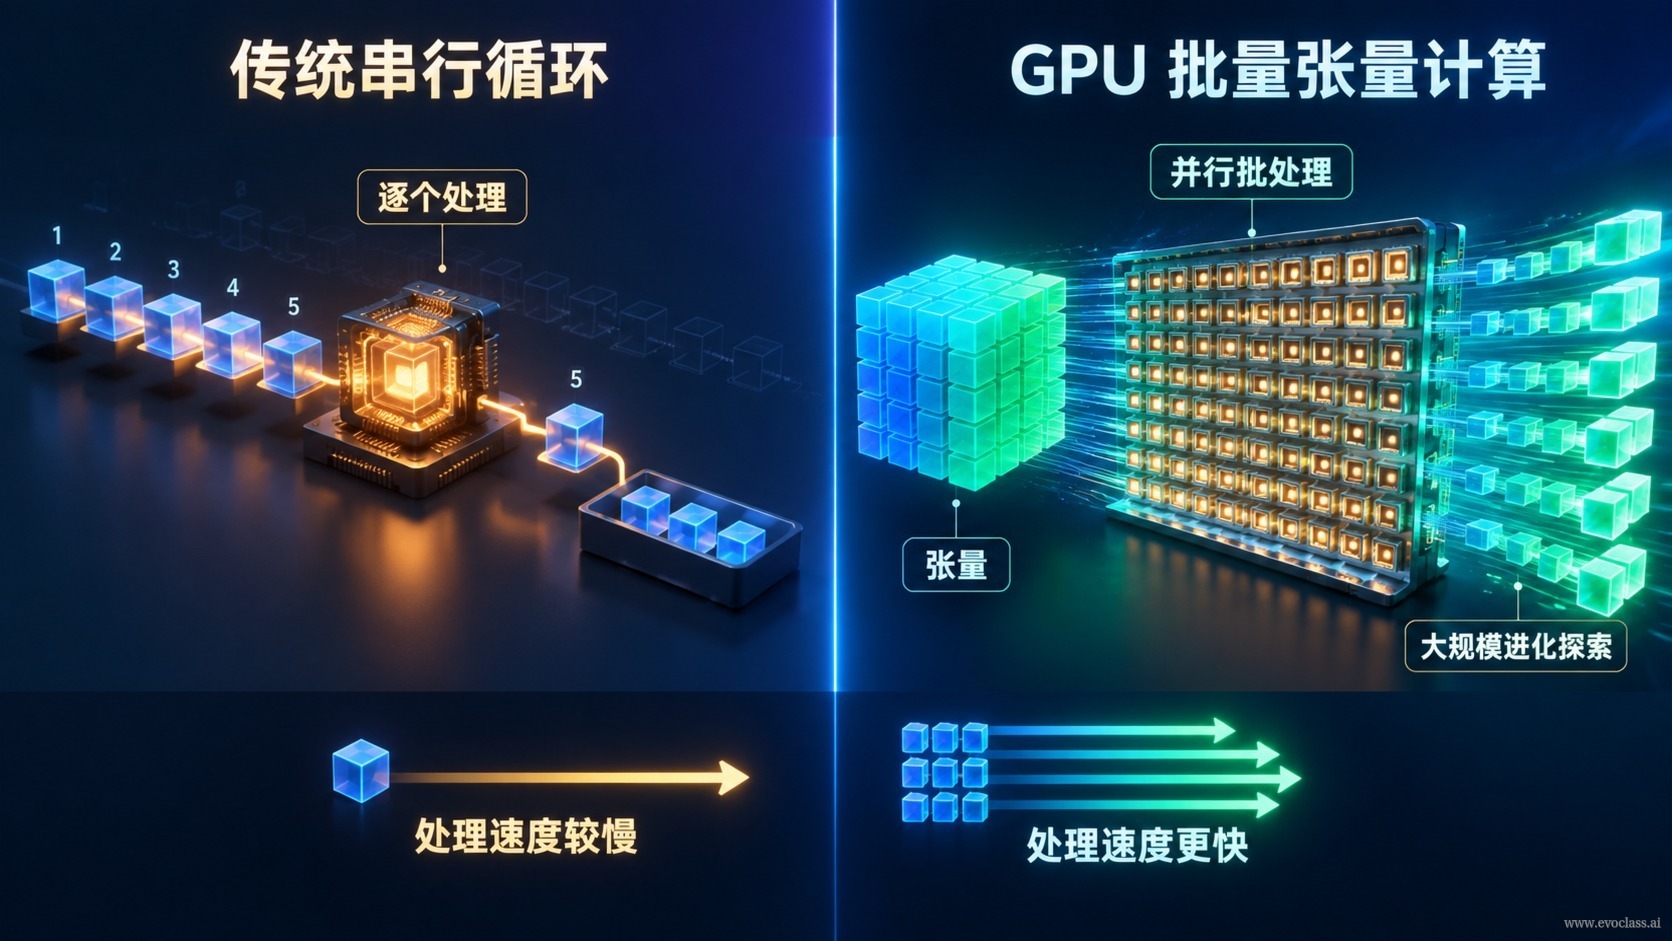
Quando la dimensione della popolazione passa da qualche decina a migliaia di individui,il calcolo evolutivonon ha più come vero collo di bottiglia la domanda “si riesce a trovare una buona soluzione?”, bensì “si riesce a valutare un numero sufficiente di candidati entro un tempo finito?”. La risposta ingegneristica di EvoX si articola su due linee principali che si sostengono a vicenda:il calcolo tensoriale,che riscrive il ciclo seriale individuo per individuo come operazioni tensoriali in batch,un'architettura unificatache disaccoppia algoritmo, problema, workflow e pianificazione del Runtime, rendendo questo meccanismo parallelo riutilizzabile su algoritmi evolutivi e task diversi.
Perché la diversità richiede throughput
La ricerca evolutiva si basa sulla diversità della popolazione: quanto più i candidati sono dispersi, tanto maggiore è la probabilità di uscire da un ottimo locale. Ma “mantenere la diversità” è essenzialmente una questione di potenza di calcolo: richiede che ogni generazione possa completare la valutazione e l'aggiornamento dello stato di un gran numero di candidati. Se i metodi per generare i candidati restano fissati a priori dall'uomo e la valutazione continua a essere eseguita individuo per individuo, il sistema non può che ripetere gli stessi schemi predefiniti, e i benefici della diversità vengono annullati dal collo di bottiglia del throughput di calcolo.
Evoluzione dei metodi: includere nell'evoluzione anche “i metodi che generano i candidati”
Una volta ampliata la scala di calcolo, EvoX sposta l'oggetto dell'ottimizzazione a un livello superiore: non si limita più a risolvere il problema, ma include nell'evoluzione il metodo stesso che genera le soluzioni candidate. Questa è lacosiddetta evoluzione dei metodi. Prendiamo MetaDE come esempio: l'algoritmo interno risolve il task reale, mentre l'algoritmo esterno evolve la configurazione e le strategie dell'algoritmo interno (ad esempio le strategie di mutazione e gli iperparametri dell'evoluzione differenziale) ed esegue in parallelo su GPU un gran numero di task interni, facendo sì che le prestazioni dei task guidino a loro volta la scelta della configurazione esterna;AutoPSO ed EvoGO compiono un ulteriore passo avanti combinando i componenti dello sciame particellare e utilizzando il feedback storico per apprendere le modalità di generazione dei candidati, superando il divario dal “modificare i parametri” al “modificare la struttura dell'algoritmo”. Questa doppia evoluzione, interna ed esterna, richiede naturalmente che nella stessa generazione, e persino nello stesso istante, un gran numero di task interni venga valutato e aggiornato in batch, imponendo quindi requisiti più elevati in termini di throughput di calcolo e capacità di parallelismo.
Il grafo di calcolo tensoriale: sostituire i cicli con tensori in batch
Il tradizionale ciclo seriale su CPU esegue di norma “valutazione—registrazione—aggiornamento” individuo per individuo, attivando ogni volta solo operatori di piccola scala, con tre tipi di costi conseguenti:elevato overhead di pianificazione,frammentazione degli operatori,utilizzo insufficiente della GPU. L'approccio del grafo di calcolo tensoriale consiste nell'organizzarela gestione della popolazione, la valutazione in batch e l'aggiornamento dello statocome operazioni tensoriali in batch, così che i candidati della stessa generazione, o persino di più generazioni, vengano calcolati in parallelo. Per fare un esempio: quando una stessa generazione contiene N soluzioni candidate, l'implementazione seriale cicla individuo per individuo, mentre l'implementazione tensoriale organizza la popolazione in un unico tensore e completa in una sola volta la valutazione in batch e l'aggiornamento parallelo dello stato, riducendo sensibilmente l'overhead di pianificazione e aumentando il tasso di occupazione della GPU.
Architettura unificata: rendere riutilizzabile il meccanismo parallelo
Riscrivere i cicli come tensori non basta: se algoritmo, problema e logica di pianificazione restano accoppiati tra loro, cambiare un algoritmo evolutivo o un tipo di task richiede di riscrivere tutto da capo. L'architettura unificata, disaccoppiando moduli qualialgoritmo, problema, workflow e pianificazione del Runtime, rende il meccanismo parallelo tensoriale riutilizzabile su algoritmi evolutivi e task diversi (come gli scenari di evoluzione dei metodi MetaDE e AutoPSO); in combinazione conla pianificazione di risorse di calcolo eterogeneeconsente di gestire risorse come CPU e GPU a livello di task in batch, sostenendo così un'esplorazione parallela componibile e scalabile.
Perché si tratta di una capacità di livello “fondamentale”
La base ingegneristica offerta da GPU e grandi modelli ha elevato il calcolo tensoriale in batch da ottimizzazione locale a capacità fondamentale a supporto dell'esplorazione evolutiva a livello di sistema. In altre parole, il calcolo tensoriale risolve il problema di “andare veloce”, mentre l'architettura unificata, aperta e disaccoppiata risolve quello di “poter cambiare”: il primo fornisce throughput, la seconda offre confini di riutilizzo componibili e scalabili. Solo combinandoli insieme l'esplorazione evolutiva parallela ad alta intensità e ad alta diversità diventa davvero una capacità ingegneristica concreta.
Confronto tra ciclo seriale e architettura di calcolo tensoriale in batch su GPUA sinistra il ciclo seriale tradizionale su CPU esegue “valutazione—registrazione—aggiornamento” individuo per individuo, attivando solo operatori di piccola scala, con conseguenti overhead di pianificazione elevato, frammentazione degli operatori e utilizzo insufficiente della GPU; a destra la gestione della popolazione, la valutazione in batch e l'aggiornamento dello stato vengono organizzati nel loro insieme come operazioni tensoriali, completando in una sola volta il calcolo dei candidati della stessa generazione e persino di più generazioni, e disaccoppiandosi dalla pianificazione del Runtime, così che il meccanismo parallelo sia riutilizzabile su algoritmi e task diversi.