進化アルゴリズムには、見落とされがちな暗黙の前提があります。進化するのは候補解であり、候補解を生成する方法そのものは変わらないつまり、従来の進化アルゴリズムは通常、探索方法を固定したまま、反復の中で候補解だけを変化させます——探索の全過程で「動く」のは解であり、「動かない」のはルールです。本ページで紹介するのは、この前提を超えたもう一つの視点、すなわち解法そのものを探索と改善のプロセスに組み込む考え方です。
デフォルトパラダイム:方法はロックされ、解が進化する
従来の手法では、交叉方式・変異戦略・ハイパーパラメータは通常、実行前に一度だけ選定され、その後の探索全体で変更されません。これらは候補解の生成メカニズムを直接決定し、求解結果にも大きく影響します。タスクの成績が良くても悪くても、方法はそのままの状態に留まります。
- 解層が動く:候補解 → 評価 → 選択 → 継承を繰り返し反復。
- 方法層は動かない:変異戦略・交叉方式・ハイパーパラメータはあらかじめ設定され、ロックされる。
- 結果:事前設定と手動チューニングだけでは、解法そのものがタスクのフィードバックに応じて継続的に進化することはありません。改善は主に人の経験と手動チューニングに依存し、チューニングの速度はタスクの変化に追いつけないことが多いのです。
アルゴリズム進化:方法も探索対象にする
アルゴリズム進化のアプローチでは、交叉方式・変異戦略・ハイパーパラメータを固定の設定として扱うのではなく、候補化・評価・置換の対象とし、候補解とともに求解性能の検証を受けさせます。つまり、求解アルゴリズム自身を探索と改善のプロセスに組み込み、「方法」も進化可能な対象とするのです。こうして、元来の解層の反復に加えて第二のフィードバックループが生まれます。解が改善されるだけでなく、方法も改善されるのです。
二つのループは、シンプルな矢印の言葉で次のようにまとめられます。方法要素 → 候補解の生成 → 求解性能の評価 → 保持または置換 → 方法の更新。同時に、候補解の内部では依然として「生成 → 評価 → 選択 → 継承」という通常の反復が動作しています。前者は「どう探すか」を変え、後者は「何を見つけたか」を変えます。
重要な転換
「固定アルゴリズムでより良い解を求める」ことから、「アルゴリズムが求解の過程で自らを改善する」ことへと拡張されます。あるシステムが本当にアルゴリズム進化を行っているかどうかは、方法要素が探索に組み込まれ、その去就が求解性能によって決まるかどうかで判断できます。人が一度だけ決め打ちするのではありません。
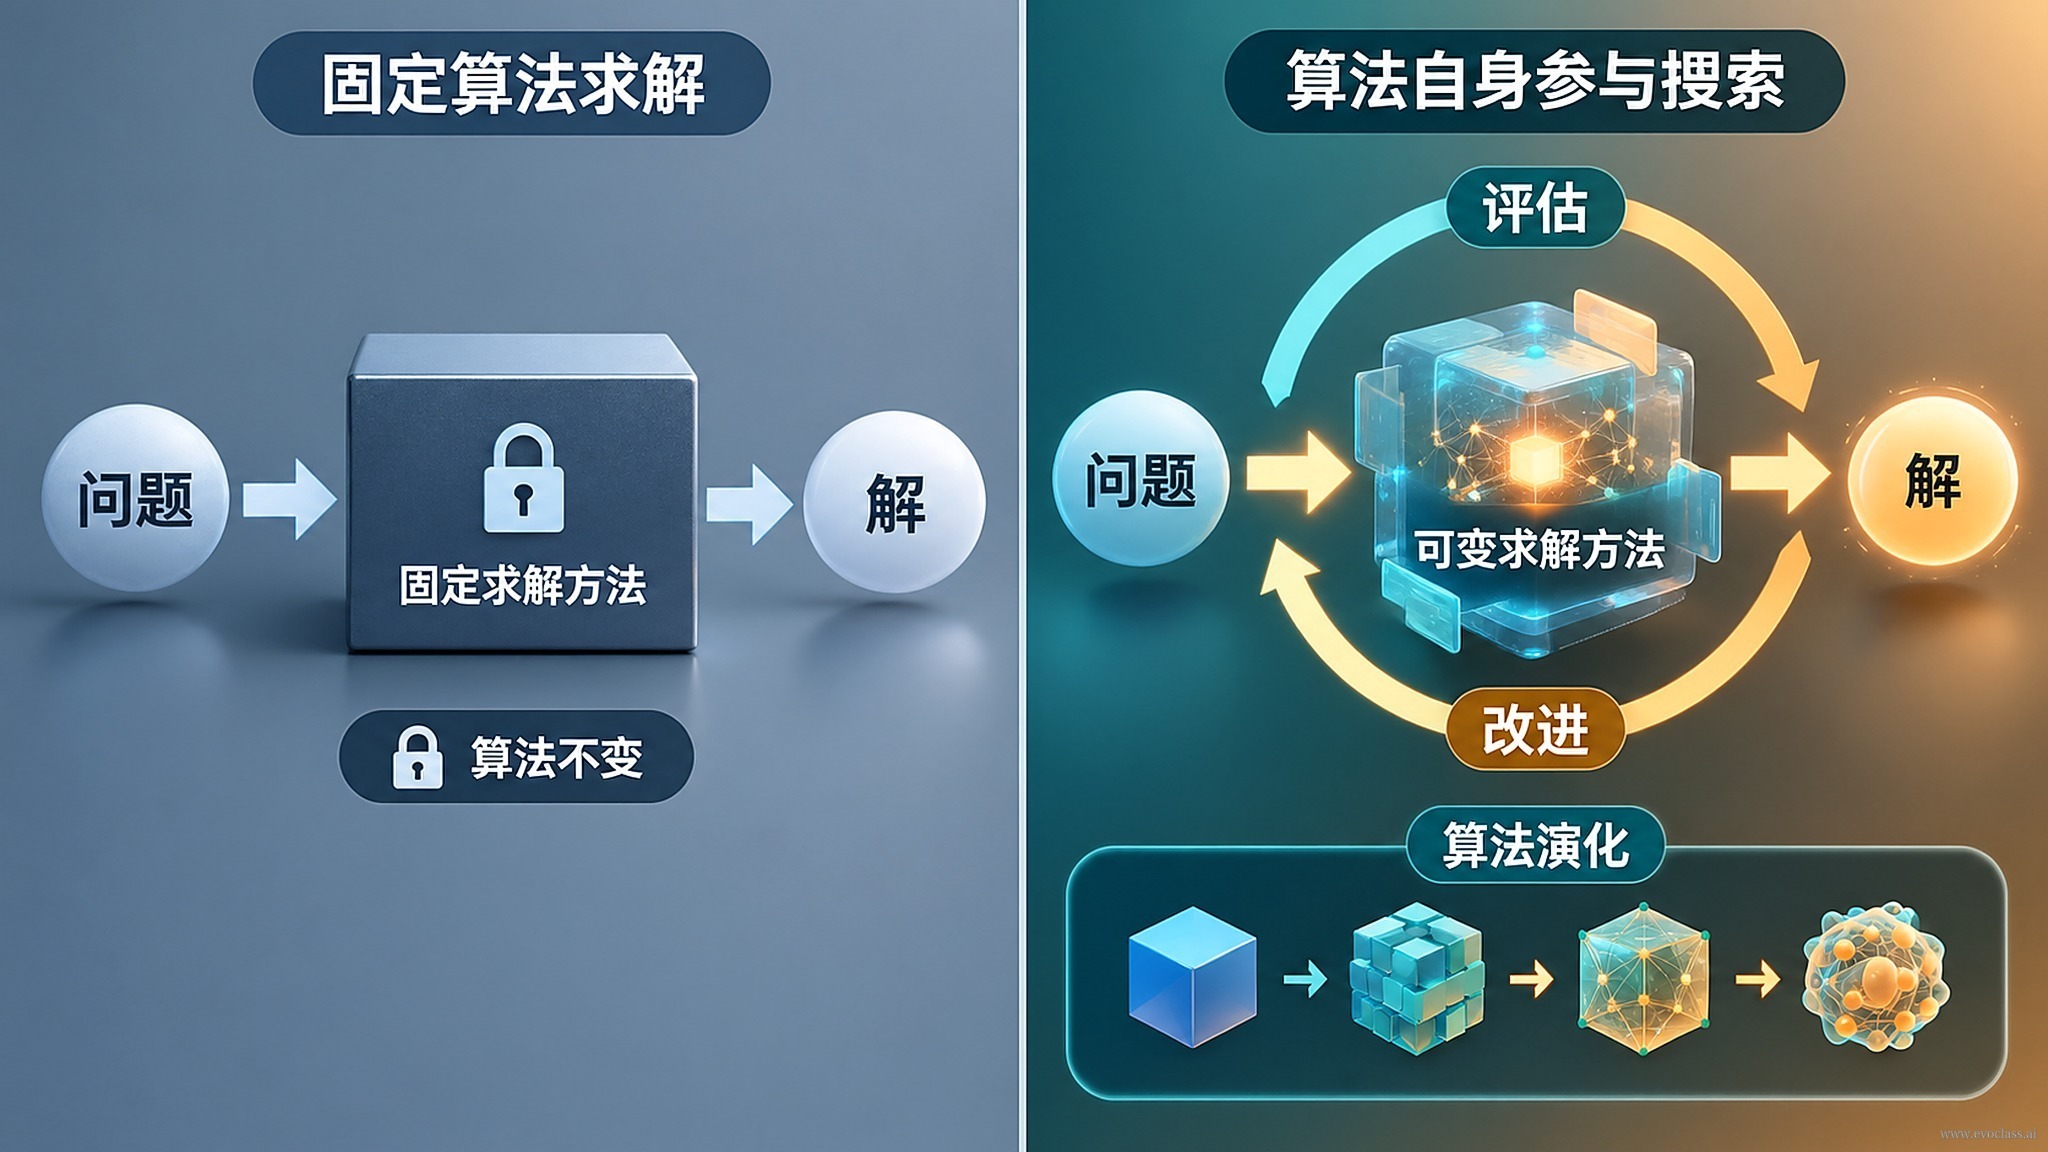
固定アルゴリズムとアルゴリズム自己進化の比較左側は従来のパラダイムを示しています。交叉方式・変異戦略・ハイパーパラメータは実行前にロックされ、解だけが生成・評価・選択・継承を繰り返し、方法そのものは変わりません。右側には第二のフィードバックループが追加され、これらの方法要素も探索・評価・置換の対象となり、求解性能によって去就が決まります。つまり、アルゴリズムが求解の過程で自らを改善するのです。
固定アルゴリズムとアルゴリズム自己進化の比較
左側は従来のパラダイムを示しています。交叉方式・変異戦略・ハイパーパラメータは実行前にロックされ、解だけが生成・評価・選択・継承を繰り返し、方法そのものは変わりません。右側には第二のフィードバックループが追加され、これらの方法要素も探索・評価・置換の対象となり、求解性能によって去就が決まります。つまり、アルゴリズムが求解の過程で自らを改善するのです。