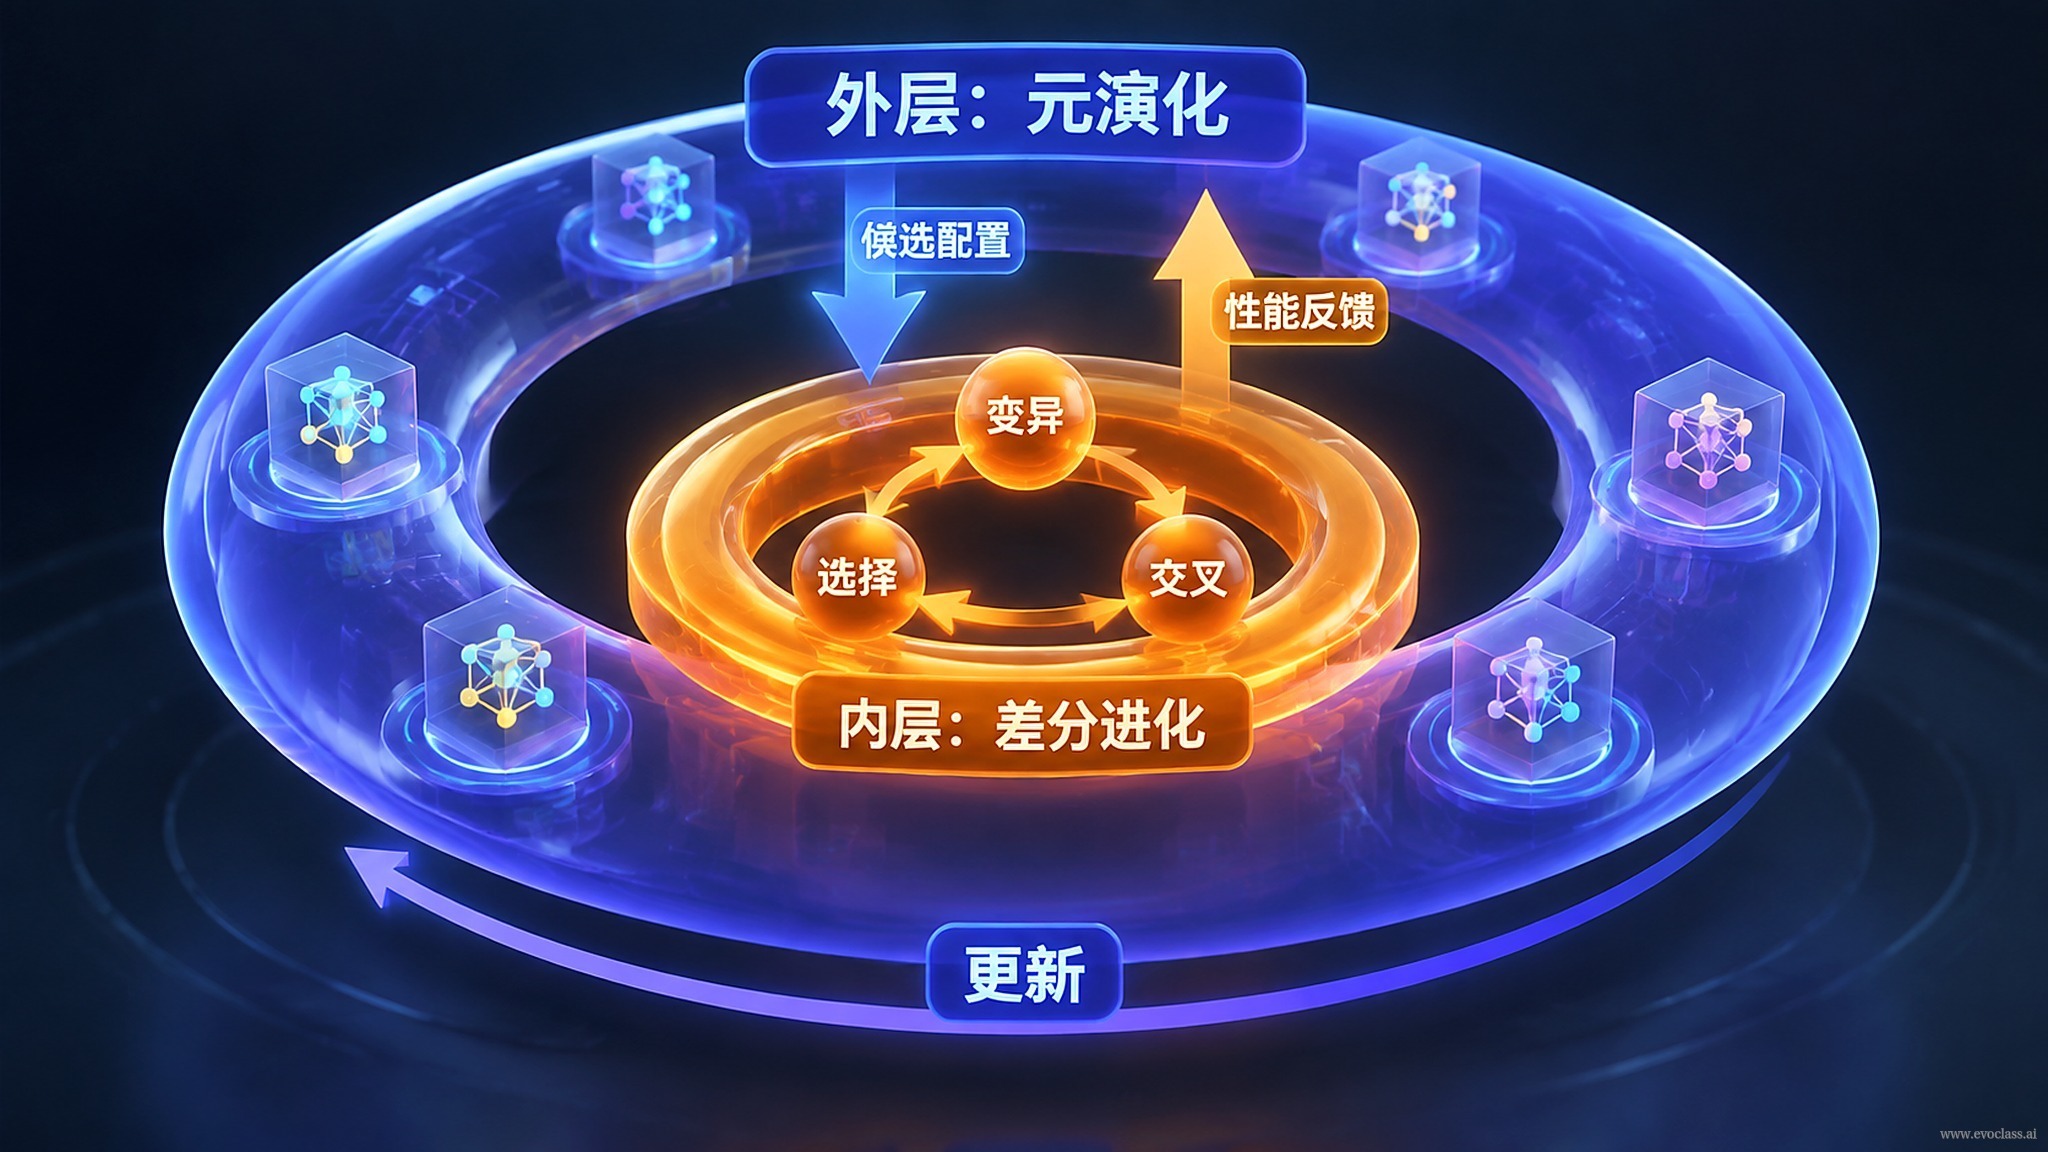
前回の講義では、進化システムが「生成—評価—選択—継承」という閉ループによって能力を積み上げていく仕組みを見ました。今回はその考え方をもう一段内側へと押し進めます。アルゴリズムに問題を解かせるだけでなく、アルゴリズムにアルゴリズムを改良させるのです。MetaDE まさにそうしたネスト型進化アーキテクチャであり、差分進化(DE)を内外2層に分割することで、「アルゴリズムがアルゴリズムを最適化する」ことを実行可能な計算プロセスにしています。
1. 2層の役割分担:誰が解き、誰が進化するのか
MetaDE は DE を内外2層に組織化しており、2層が扱う対象はまったく異なります。
- 内層 DE(タスク層):実際の最適化タスクを対象とし、候補解の集団を維持しながら、変異・交叉・選択を繰り返し実行して、タスク上の良質な解へと少しずつ近づいていきます。これは「この問題をどれだけうまく解けたか」に答える層です。
- 外層 DE(メタ層):アルゴリズムそのものを対象とし、集団の各個体はタスクの解ではなく、一連の「変異戦略+パラメータ」の設定です。たとえば、どの変異方式を採用するか、スケーリングファクターや交叉確率をどの値にするか、といった内容です。これは「このアルゴリズム設定は使い勝手がよいか」に答える層です。
したがって外層はタスク変数を直接最適化するのではなく、タスク変数は常に内層が扱います。外層が変えるのは、内層の「作業マニュアル」だけなのです。
2. 相互作用の閉ループ:設定の配信と性能の返送
2層は双方向のチャネルで結合され、閉ループを形成します。まず外層がアルゴリズム設定を1セット生成し、内層へ配信(→)します。内層はその設定に従ってタスクを実行し、終了後にタスク性能(→)を外層へ返送します。外層はそれに基づいて性能のより良い設定を保持・再構成し、次のラウンドの設定を生成します。この流れは「外層の設定 → 内層の求解 → タスク性能 → 外層の更新」としてまとめることができ、これを繰り返します。
この閉ループは重要な性質をもたらします。内層アルゴリズムの変異戦略とパラメータは、人が一度設定して固定したままになるのではなく、外層の探索に伴って絶えず書き換えられていくのです。こうしてアルゴリズムは自己改良への道筋を得ることになります。
3. 実行可能性の前提:並列化とコストのトレードオフ
ネスト構造にはコストが伴います。外層の評価のたびに、1セットの設定をタスク上で完全に実行しなければならず、評価コストは明らかに増大します。外層の集団が大きいほど、総コストも高くなります。まさにこれが MetaDE が GPU 並列に依存する理由です。複数の内層設定を同時に評価できれば、外層の1回の反復に要する時間が大幅に圧縮され、ネスト型メタ進化は工学的に実行可能になります。逆に言えば、利用できる並列リソースが不足している場合は、やみくもに探索範囲を広げるよりも、外層の規模を縮小したり内層の評価精度を下げたりするほうが現実的です。
MetaDE ネスト型進化アーキテクチャこの図は MetaDE の内外2層構造を示しています。外層メタ層の集団における個体は一連の変異戦略とパラメータ設定であり、アルゴリズム設定の進化を担います。内層タスク層は、外層から配信された設定に従って候補解の集団を維持し、実際の最適化タスクを解きます。2層は双方向チャネルで結合され、外層が設定を配信し、内層がタスク性能を返送します。外層はそれに基づきより優れた設定を保持・再構成し、アルゴリズムの自己改良の閉ループを形成します。