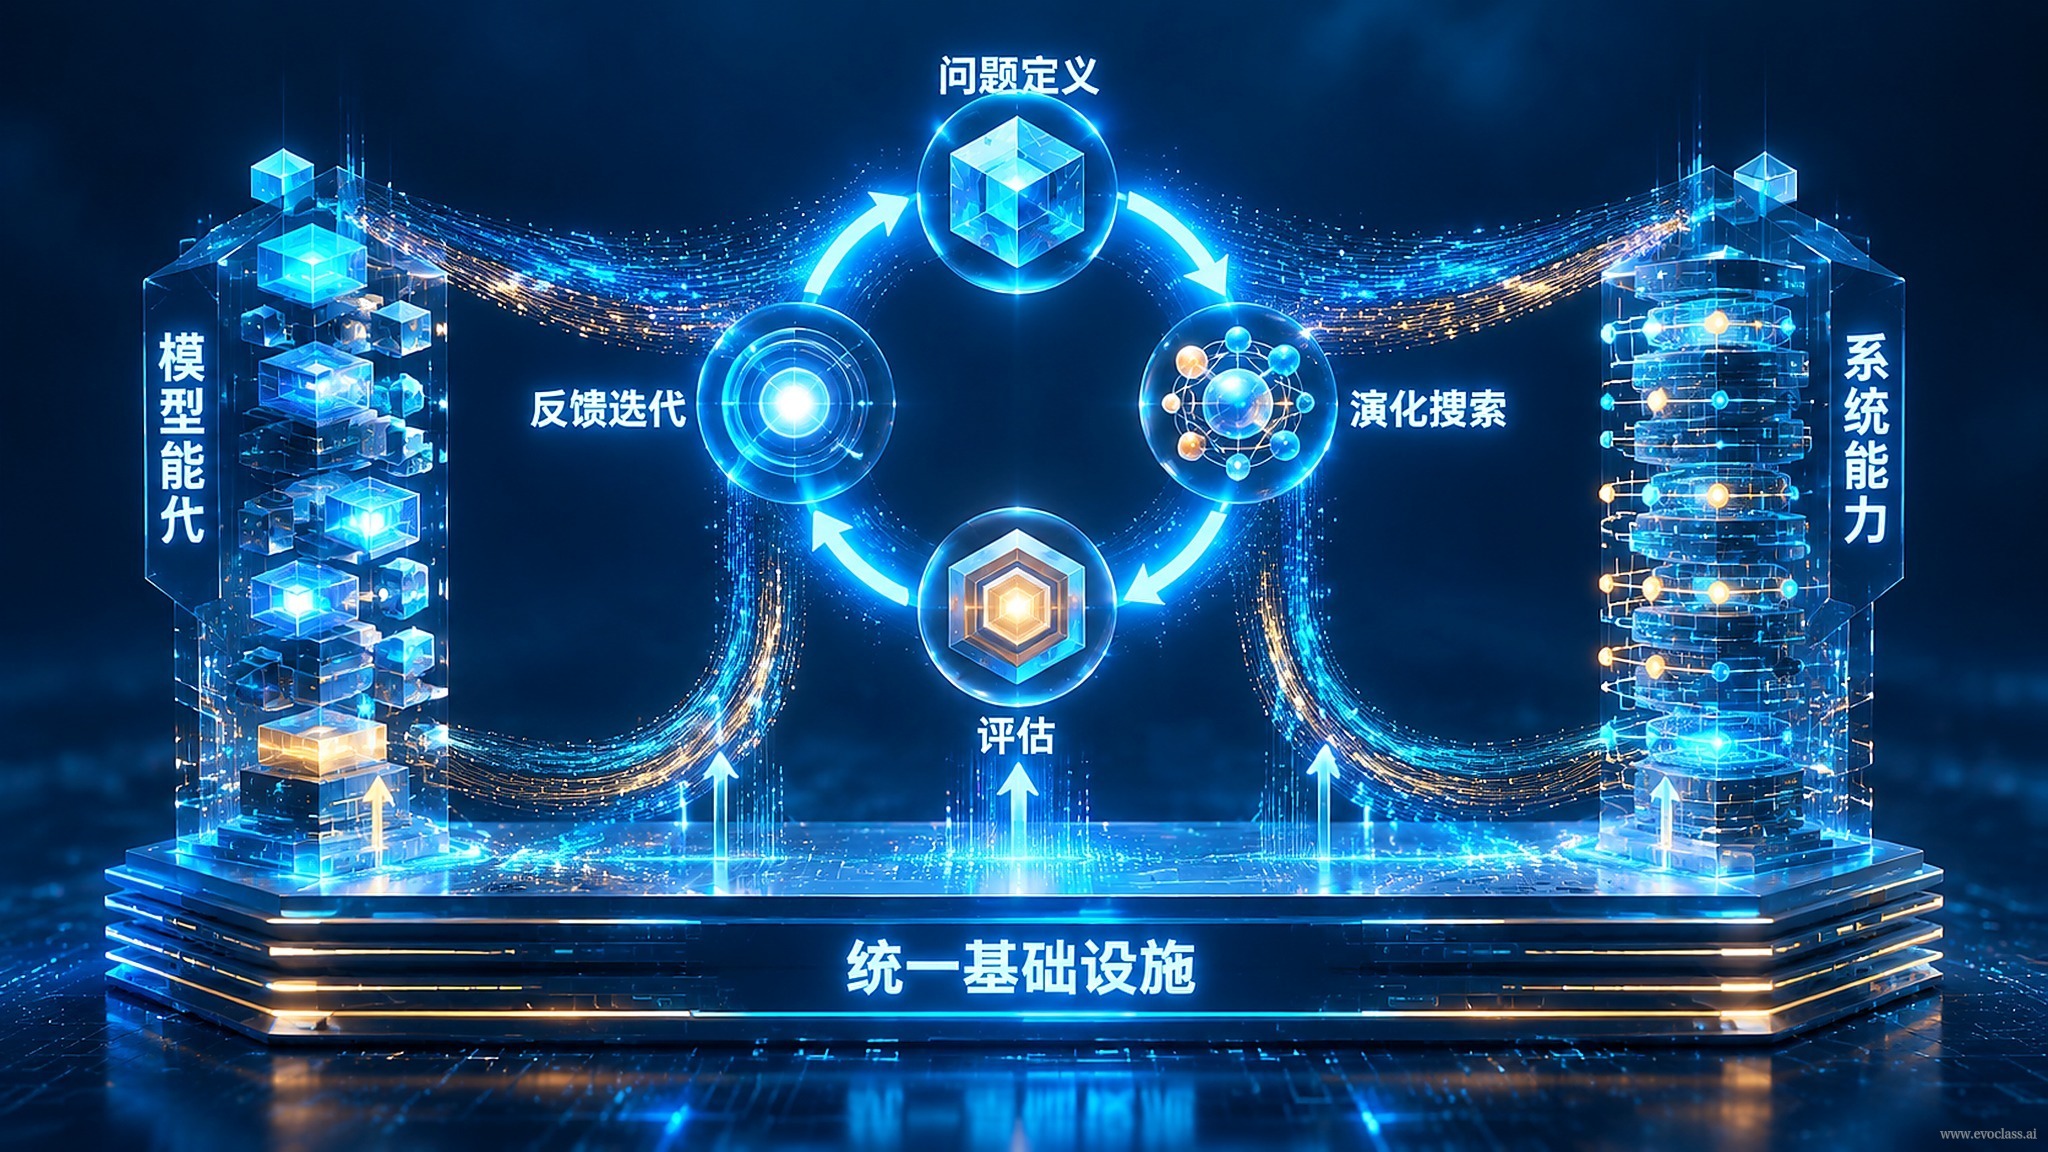
このページは、ある具体的な問いに答えます:大規模モデルはすでにコードを書き、仮説を立て、方案を出せるのに、なぜシステム全体が必要なのでしょうか?答えは、モデルの単発のパフォーマンスにあるのではなく、「生成後」の空白にあります。単発の生成は、自らが正しいことを証明できず、環境やモデルが絶えず更新される中で持続的に有効であり続けることも困難です。EvoX の立ち位置は、モデル能力とシステム能力の間に橋を架けること:すなわち、一つひとつの生成結果を、検証され、選択され、保持され得る能力へと組織化することにあります。
ギャップの位置づけ:単発の出力から、蓄積可能なシステム能力へ
モデルは単発の呼び出しで「可能性」——ある仮説、あるコード、ある方案——を提示するのが得意です。しかし、可能性は結論ではありません。結果が成立するかどうかは、現実の環境に語ってもらうしかありません。環境が結果を示した後、どれが優れどれが劣るかを判断し、何を残し何を淘汰するのか、また、残した部分を次のラウンドへ持ち込むのは誰か——これらの段階をモデル自身は担いません。EvoX が向き合うのは、まさにこの「生成後」の空白であり、生成結果を蓄積可能なシステム能力へと変換します。
ループの4つの段階
- モデルが可能性を生成:モデルは候補方案、仮説、またはコードを提示し、提供するのは結論ではなく可能性です。
- 環境がフィードバックを提供:実験、シミュレーション、または実運用が観測可能な結果を返し、候補を現実の検証に晒します。
- システムが評価・選択:システムは目標と制約に従って候補を比較し、優劣を判断して、どれを残すかを決定します。
- 継承:選ばれた戦略、パラメータ、またはコンポーネントが次のラウンドの進化へと引き継がれ、新たな起点となります。
4つのステップは端と端がつながります:モデルが可能性を生成 → 環境がフィードバックを提供 → システムが評価・選択 → 継承 → モデルが新たな可能性を生成する元へ戻る。ループさえ回り始めれば、毎回ゼロから始める必要はありません。
アーキテクチャとしての意味:単点アルゴリズムでも、一度きりの呼び出しでもない
生成、実行フィードバック、評価、選択、継承を再利用可能なシステムアーキテクチャとして組織することが、EvoX と単点アルゴリズム・単発呼び出しとの根本的な違いです。単点アルゴリズムは「このステップをどう計算するか」を気にし、単発呼び出しは「今回の答えが正しいか」を気にします。それに対し EvoX が気にするのは「この仕組みがラウンドを重ねて回り続け、しかも回るほど良くなるかどうか」です。したがってそれが記述するのは、コンポーネント間のインターフェース、評価基準、継承ルールであり、単なるモデルのパラメータや一問一答の答えではありません。
持続的な蓄積:分散した知能コンポーネントはもはや使い捨ての出力ではない
ループの中では、評価を通過した戦略が継承され、通過しなかったものは淘汰または修正されます。生成器、シミュレータ、評価器など、異なる段階に分散した知能コンポーネントは、こうして同一の「存続記録」を共有します。すなわち、それらの能力はラウンドを重ねる進化の中で積み重なっていき、毎回リセットされることはありません。これこそが、ループが分散したコンポーネントを束ねて持続的に蓄積する能力へと変える鍵なのです。
源流との呼応:1950年のチューリング「子ども機械」
早くも1950年に、チューリングは「子ども機械」という構想を提唱しました。機械は子どものように、教育・試行・賞罰を通じて、環境との相互作用の中で少しずつ能力を獲得していく、というものです。EvoX は、この構想が AI Native な科学研究の実践において体系的に拡張されたものと見ることができます。教育は生成と誘導に、試行は環境フィードバックに、賞罰は評価・選択に、成長は継承と蓄積に、それぞれ対応します。
EvoX 進化ループの全体像図は、EvoX ループの端と端がつながる4つの段階を示しています。モデルが候補方案や仮説を生成し、環境が実験と運用を通じてフィードバックを提供し、システムが目標と制約に従って評価・選択し、選ばれた戦略とパラメータが次のラウンドへ継承されます。このアーキテクチャは、本来使い捨てだったモデル出力を、検証可能で蓄積可能なシステム能力へと組織化すると同時に、フィードバックの歪みや評価の偏りが循環の中でラウンドごとに増幅されることを示しています。