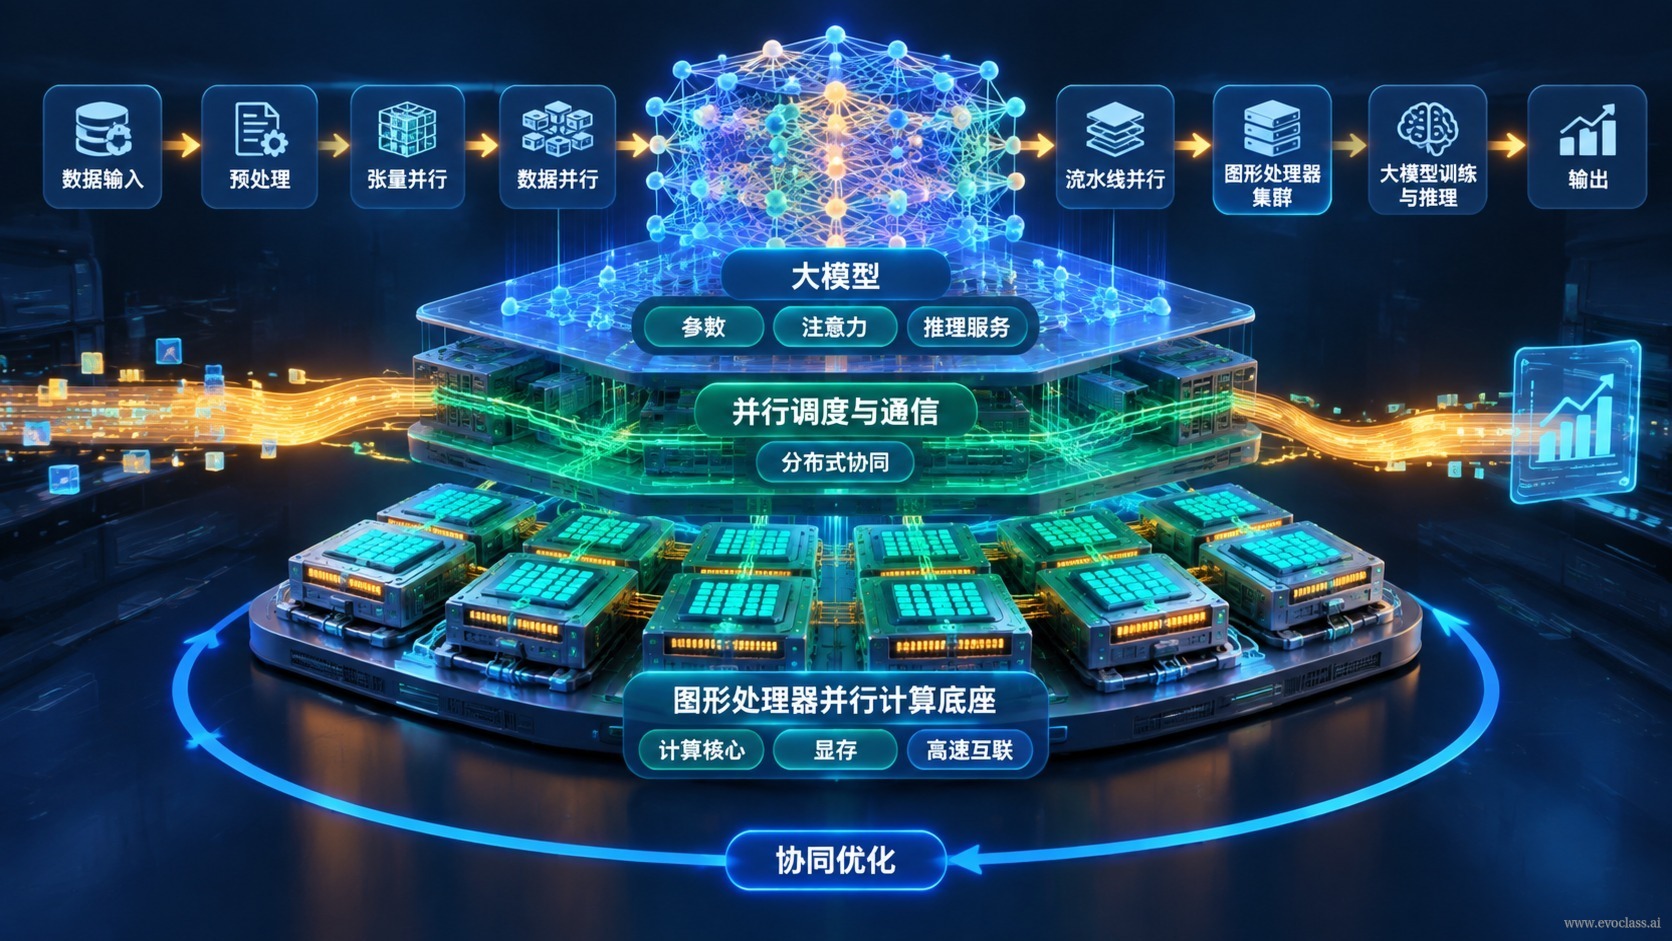
本ページでは、EvoX が大規模な進化的探索を展開できる理由を支えるエンジニアリング基盤について説明します:GPU は高強度の並列計算能力を提供し、大規模モデル は自然言語・コード・プロジェクトのコンテキストに対する理解と生成能力を提供します。この二つが重なると、計算規模が大きく広がり、候補解の来源・数・そして作用できる探索範囲が根本的に変化します。
計算能力が開いたもの:直列の小バッチから大規模な同時探索へ
計算能力が限られた環境では、一つの候補解を評価するにも順番待ちが生じ、探索は小バッチ・直列でしか進められず、「いくつか多く試す」こと自体が贅沢でした。GPU の並列能力は、評価と探索を大規模な同時進行へと押し進めます。個体群や大量の候補解を一度に並列評価へ投入でき、フィードバックはほぼ同時に還流します。こうして「大量の可能性を同時に試す」ことは特別な手段ではなく、デフォルトのエンジニアリング能力になりました。
- スループット:バッチ評価によって1回の反復の待ち時間が許容範囲まで圧縮され、進化ループは評価段階に足を引っ張られることなく、高頻度で稼働できるようになります。
- 規模:同時に探索できる候補数が増え、探索がカバーできる仮説空間も広がり、探索の境界は「少数の試行錯誤」から「まとめて展開」へと変わります。
候補解の来源に何が起きたか
計算規模が広がったことで、候補の来源は「人手による設計+少量のサンプリング」からハイブリッドな方式へと移行しました:並列計算によるバッチ供給 と 大規模モデルによる生成と書き換え がともに候補を生み出します。大規模モデルは自然言語・コード・プロジェクトのコンテキストを理解し、研究意図をより速く実行可能な候補・スクリプト・演算子のドラフトへと変換し、プロジェクトの文脈との接続を保つことができます。一方 GPU 側は、これらのドラフトをバッチで検証し、結果を探索プロセスへフィードバックする役割を担います。両者が前後を担うことで、「生成」と「検証」の両端をちょうどカバーできます。
基盤は進化アルゴリズムを代替しない
明確にしておくべきは、この層が基盤であり、アルゴリズム本体ではないという点です。これが担うのはスループット、意味的エントリー と コンテキストの接続です。探索・選択・フィードバックの閉ループは依然として進化アルゴリズムが担います。役割分担をはっきりさせてこそ、実践で判断力が身につきます。あるシステムの効果が芳しくないときは、欠けているのが計算スループットなのか、意味的エントリーなのか、それとも閉ループの仕組みそのものなのかをまず見極める必要があります。
同じエンジニアリングの流れの中で、基盤はさらに マルチ Agent の協調と再帰的なタスク分解 といったエンジニアリングパターンを支える必要があります。複雑な目標をいくつかのサブタスクに分解し、異なる Agent がそれぞれ担当して進めるのです。そしてこれらのサブタスクが互いに乖離しないようにするには、プロジェクトレベルの永続化——目標・制約・中間成果物・評価結果をプロジェクトの層に蓄積し、それがAgent のコンテキストを越えて 継続できるようにすることが必要です。そうでなければ、Agent を切り替えるたびにコンテキストを再調整しなければならず、再帰的な分解は互いに無関係な一回限りの呼び出しへと退化してしまいます。
GPU 並列処理と大規模モデルが協調して動作するアーキテクチャ図図中の GPU 並列処理と大規模モデルが協調して動作するアーキテクチャ図を観察し、「大規模モデルが自然言語・コード・プロジェクトのコンテキストを理解できる」こととどのような関係があるか考えてみましょう。