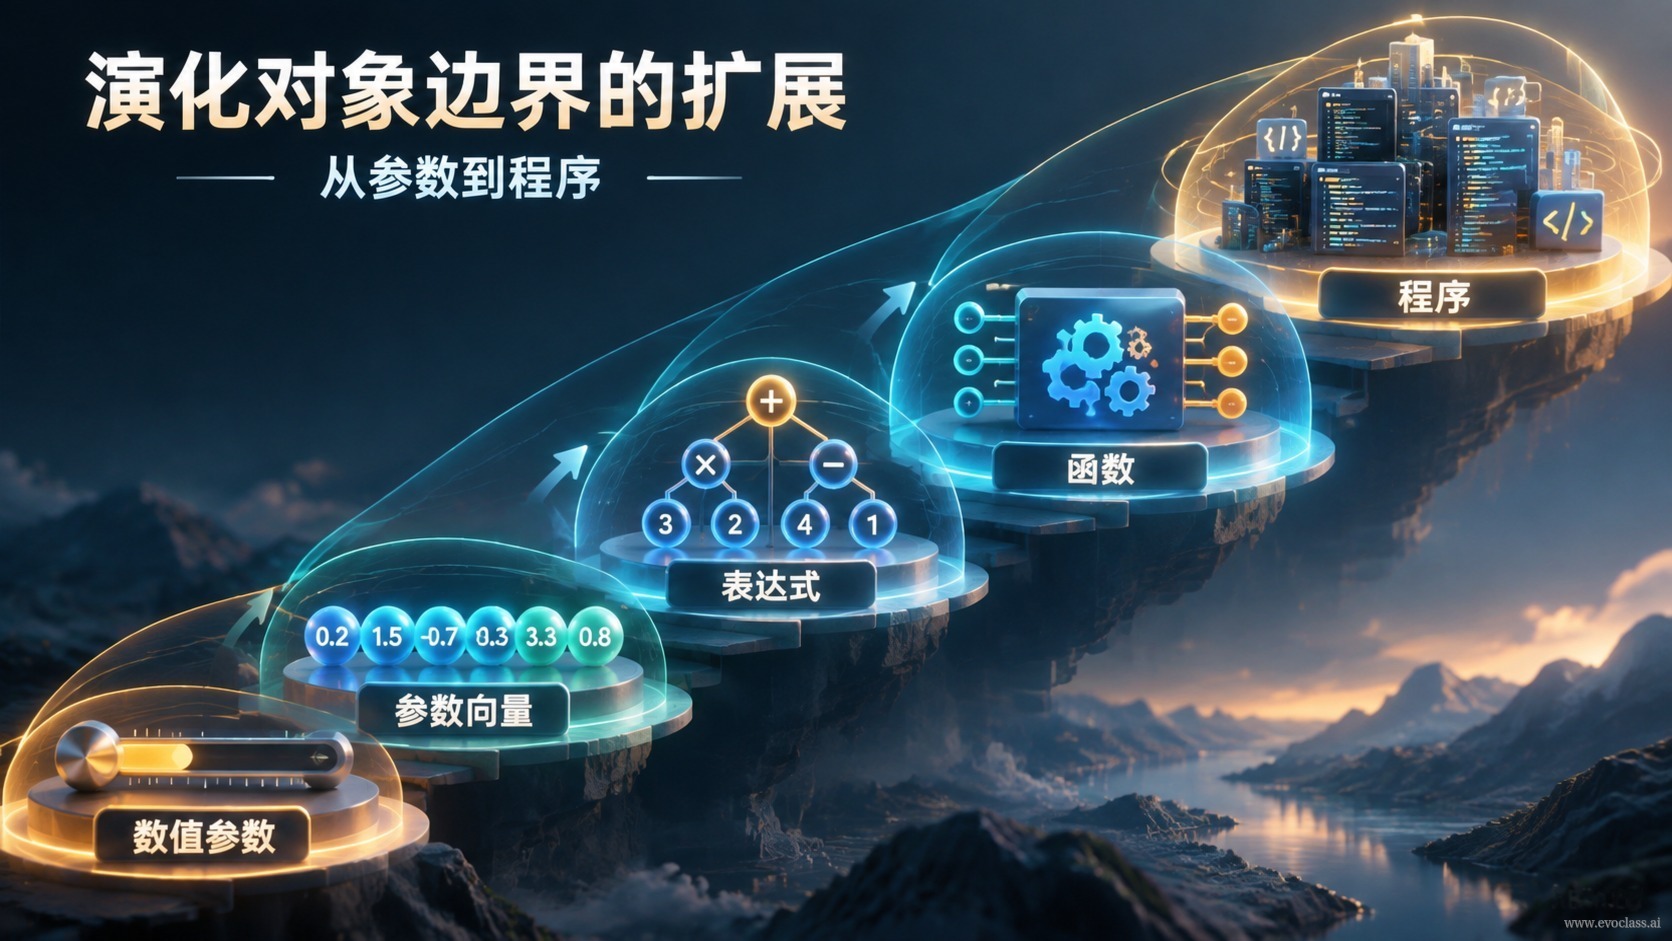
進化対象とは、進化システムにおいて実際にコード化され、変異し、評価され、選択される部分を指します。古典的な進化アルゴリズムでは、この対象は単なる数値パラメータの集合とみなされてきました。しかし、GPUと大規模モデルが共に構成する現代の基盤の上では、この境界は外へと押し広げられつつあります。数値パラメータから、ハイパーパラメータとモデル構造へ、さらにアルゴリズムの仕組みと演算子へ、そして最終的にはプログラムと持続的に存在するソフトウェアエンジニアリングの状態へと至ります。
この階段を理解する鍵は、次の三つを同時に押さえることです。対象がどのように表現されるか、何に制約されるか、どのような信号で評価されるか。対象が一段上がるごとに、この三つはすべて連動して変わります。
- 数値パラメータ層:対象は連続実数ベクトル θ \in \mathbb{R}^dであり、例えば学習率、重み、または差分進化の変異因子です。制約は主に値の範囲であり、評価は通常、単一のスカラー目的関数 f(θ)です。
- ハイパーパラメータとモデル構造層:対象には層数、幅、接続方式、データ拡張戦略などの離散的な選択が含まれます。探索空間は混合型となり、組み合わせが急速に膨張するため、評価では汎化能力と過学習に特に注意を払う必要があります。
- アルゴリズムの仕組みと演算子層:対象そのものが実行すべき仕組みであり、例えば差分進化の変異戦略、粒子群における慣性係数の組み合わせ方、損失関数の具体的な形式などです。候補は構文と意味の制約を満たさなければならず、評価は「誰のスコアが高いか」から、ロバスト性、安定性、多目的トレードオフへと移行します。
- プログラムとエンジニアリング状態層:対象は学習スクリプト、パイプライン設定、依存関係、プロジェクト状態となります。候補はコンパイル、テスト、受け入れを通過して初めて有効とみなされ、評価はシステムレベルのフィードバックへと格上げされます。すなわち、精度がどれだけ向上したか、リソースコストが許容できるか、結果を再現できるかです。
なぜ境界が外へ拡張するのか
二つの力が共に後押ししています。第一に、計算能力の規模が並列探索の可能性を切り開きました。かつて単一の候補を中心に書かれていた逐次ループは、テンソル化とバッチ並列に取って代わられ、集団全体を一度に生成し、一度に評価できるようになりました。第二に、大規模モデルが自然言語、コード、ドメインの文脈を理解できるようになったことで、システムは構造の複雑な候補を構築できるようになりました。かつては人手で設計しなければならなかった符号化や変異の方法を、今ではモデルが生成に関与できます。
「候補を生み出す方法」それ自体も表現され評価され得るとなると、自然な疑問が生まれます。候補解が進化できるのなら、候補解を生み出す方法もまた進化対象になり得るのではないか? これこそが「解の最適化」から「アルゴリズムそのものの最適化」へと踏み出す一段のステップです。
評価信号は対象とともにアップグレードされなければならない
パラメータ層では、単一のスカラー目的関数で探索を駆動するのに十分です。例えば \min f(θ)です。プログラム層になると、「このコードが保持に値するか」を要約できる単一のスカラーは存在しません。評価は制約付きの多目的トレードオフとなり、精度 f1、評価コスト f2 、安定性 f3を同時に考慮し、制約 C(x) ≤ 0 の下で互いに支配し合わない候補の集合を探します。エンジニアリングでよく使われる判断チェックリストには、コンパイルが通るか、テストが網羅しているか、ベースラインが向上したか、リソースコストが許容できるか、結果を再現できるかが含まれます。
よくある誤解:拡張は気ままな生成ではない
対象の境界を外へ押し広げることは、コードを自由に生成してよいという意味ではありません。対象が自由になるほど、制約は消えるのではなく、「値の範囲」から「構文、インターフェース、実行可能性」へと移ります。検証の責任も軽くなるのではなく、重くなります。スクリプトレベルの進化を解禁したチームは通常、まず二つの現実的な問題に直面します。探索空間の急激な膨張と、大量の「動くが収益のない」候補が評価予算を食いつぶすことです。
したがって、より堅実な方法は層ごとに解禁することです。変更を許す範囲を一層ずつ広げ、まず低コストのスクリーニングや代理モデルで明らかに無効な候補を排除し、そのうえで高忠実度の評価を少数の有望な案に絞って行い、精度とコストの間で明示的にトレードオフを行います。
進化対象が数値パラメータから複雑なコード構造へと進化する階層図図中の「進化対象が数値パラメータから複雑なコード構造へと進化する階層図」を観察し、それが「進化の対象がパラメータからプログラム、モデル構造、アルゴリズムの仕組み、ソフトウェアエンジニアリング状態へと拡張する」こととどのような関係にあるかを考えてみましょう。