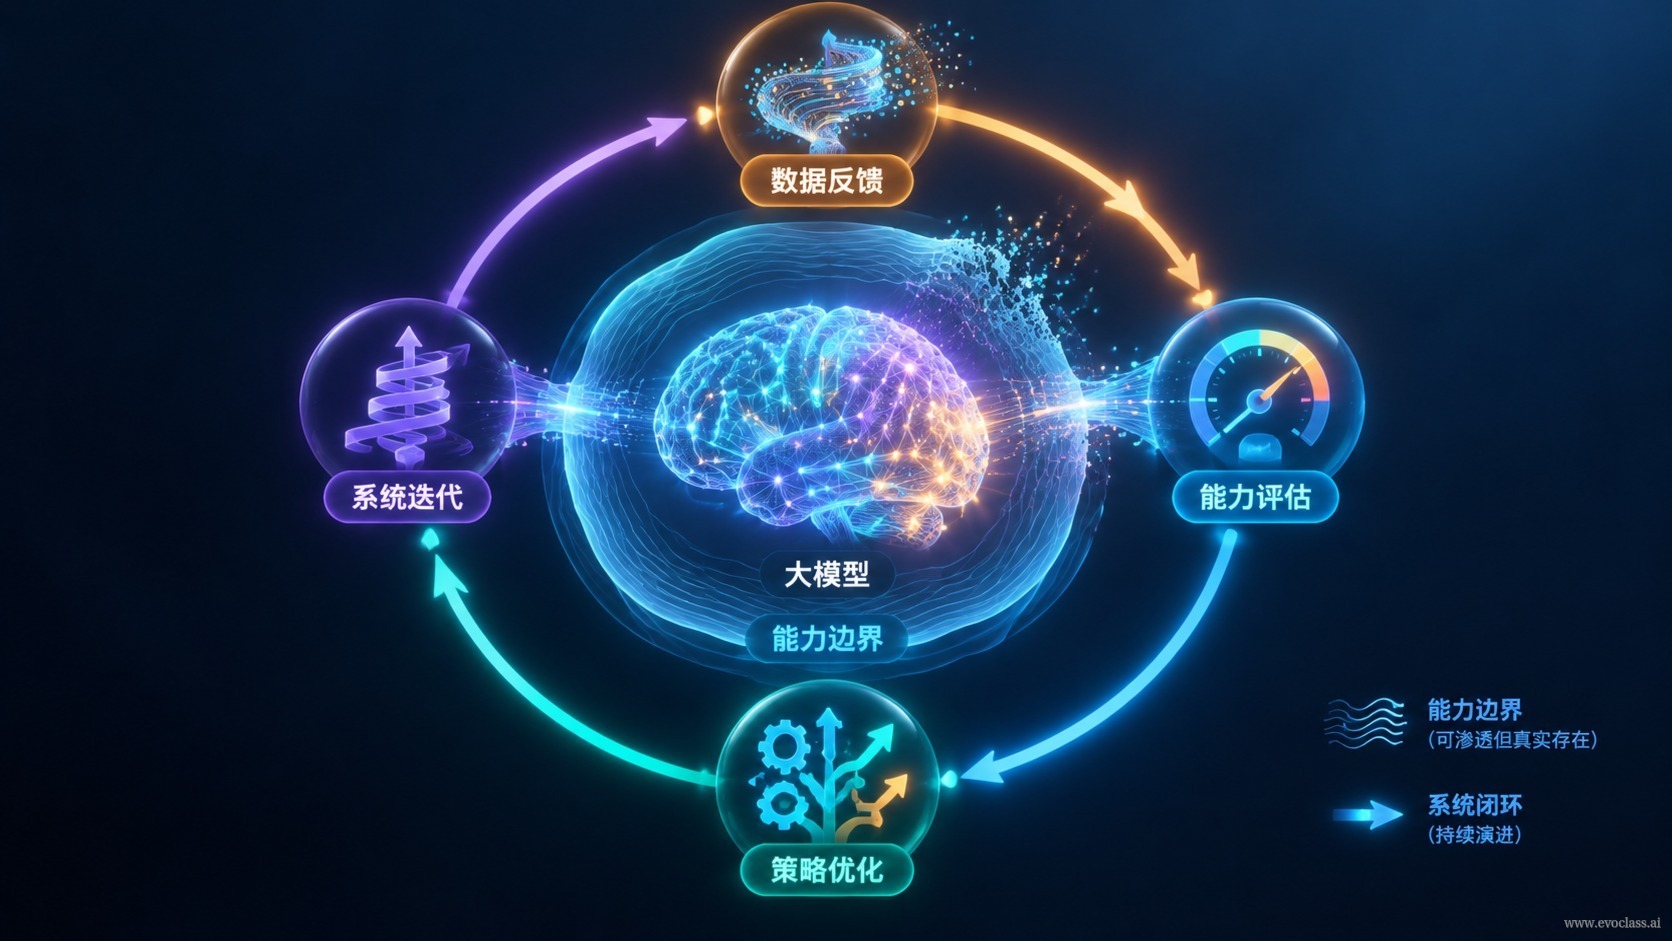
大規模モデルはすでに、信頼できる能力基盤へと自らを進化させました。すなわち、意味理解、コードとソリューションの生成、多段推論、ツールと関数の呼び出し——これらは「問いを立てれば候補が生まれる」というインタラクションを十分に支えています。しかし基盤が強力になるほど、あるエンジニアリング上の事実が覆い隠されやすくなります。モデルは可能性の生成を担い、閉ループはシステムが担わなければならない。本ページで論証するのは、まさにこの能力境界であり、そしてなぜ持続的進化がモデル能力の自然な延長ではなく、システムレベルの責務であるのかという点です。
一、モデル側がすでに対応できている部分
- 意味理解:曖昧な要求を実行可能な問題記述に解析し、そこに含まれる暗黙の制約と目標を識別します。
- 生成能力:数分以内にコード、設定、ソリューションと説明を産出し、同一の対話ターン内で自己修正できます。
- 多段推論:タスク分解、連鎖的推論と取捨選択の説明を完遂し、「候補を提示して理由を説明する」という出力形態を本来備えています。
- ツール呼び出し:関数呼び出しを通じて検索、計算と外部インターフェースをトリガーし、言語出力を実際のアクションに接続します。
これら四点を合わせると、「候補の生成」がほぼ無償になったことを意味します。真に希少なリソースは候補の数ではなく、候補に選択圧を加えるメカニズムです。
二、構造的欠落:単一セッションでは閉ループを完結できない
- セッション内状態は失われやすい:コンテキストが枯渇すると、タスクをまたぐ記憶も途切れ、前回学んだ教訓が自動的に次のラウンドへ引き継がれません。
- 真値の不在:モデルは「何が正しいか」を自律的に定義できず、自身の出力から独立した評価基準を示すこともできません。
- 実験スケジューリングの不在:バッチベンチマークテスト、統計的有意性検定、制約適合性の判定、そして高コストな実環境の実行は、いずれもモデルの制御範囲外です。
結論は明快です。モデルは単一セッションまたは単一タスク内で独立して候補生成—環境検証—結果蓄積の閉ループを完結できません。これは能力不足ではなく、そもそも責務がモデルにはないです。
三、システム側が補完すべき四種類の作業
- 候補の生成と変異:モデル出力を組織化し、能動的に探索空間を拡大・構造化します。
- 環境の構築と呼び出し:再現可能な実験環境を構築し、スケジューリング、実行と検収を担います。
- 評価と選別:真値と評価器を定義し、ランキング、選別と有意性判断を完遂します。
- 蓄積と再利用:成功結果と失敗経験を長期記憶に書き込み、次のタスクの起点とします。
分業の原則はただ一言です。モデルは可能性の生成を担い、システムは選択圧を加え履歴を保持する。両者は互いに代替できません。モデルがなければ、システムには選別可能な多様性がありません。システムがなければ、モデルは何度もゼロに戻るだけです。
四、判断基準の転換:「単回出力の質」から「改善が累積できるか」へ
システムが真に進化しているかを測る基準は、「単回出力がどれだけ優れているか」ではなく、「改善がタスクをまたぎ、Agent 周期をまたいで累積できるか」であるべきです。一度は目を見張るものでも継承できない出力は、本質的には使い捨ての消費に過ぎません。各タスクの産出が再利用可能なエンジニアリング資産——コード、設定、評価器、失敗事例集——として固化されると、後続タスクの起点は前回より高くなります。これがプロジェクトレベルの持続的進化です。EvoX の実践は、Agent とタスク周期をまたぎ、経験を対話ログに残すのではなく資産として固化するという、安定して信頼できるエンジニアリング蓄積のパラダイムを示しています。
最後に隣接テーマとの境界線を引きます。本ページはなぜシステムレベルの持続的進化が必要かのみを論証し、アルゴリズム自体の二層進化メカニズム(後続の MetaDE 関連内容を参照)には立ち入りません。
AI モデル能力とシステムレベル閉ループの組織関係図図中の AI モデル能力とシステムレベル閉ループの組織関係図を観察し、気づいたポイントを述べてください。