現実の物理世界では、工学や科学研究の問題に「コストのかからない唯一の最適解」は通常存在しません:目標は完全には定量化しにくく、制約は互いに入り組んでおり、評価フィードバックのコストは高くつくうえに、複数の目標どうしが互いにせめぎ合います。航空機の設計を例に挙げれば、揚力を高めると抵抗の増加や安定性の低下を伴うことがよくあります。したがってシステムの中心的役割は、専門家に代わって最終判断を下すことではなく、差異のある候補案の集合を探索・保持し、専門家に便益とコストを比較するための基盤を提供することです。
三つの重要な事実
- 理想的な仮定は存在しない:目標は多くの場合、部分的にしか定量化できません(例:「快適さ」「安全余裕」)。制約は幾重にも入れ子になっており、実際の評価——高忠実度シミュレーション、ベンチテスト、実機飛行試験——のたびに、多大な時間と費用がかかります。
- 多目的のトレードオフ関係:揚力と抵抗、性能と安定性、精度とエネルギー消費は、しばしば同時に最適にはできません。どんな改善も、それと引き換えに何を犠牲にしたかを明確に示す必要があります。
- フィードバックの高コストが試行錯誤を制限する:無制限に試すことはできないため、限られた評価予算のもとでは、早々に単一点に絞り込むよりも多様性を保つほうが堅実です。
なぜ単一の答えに早く収束してはいけないのか
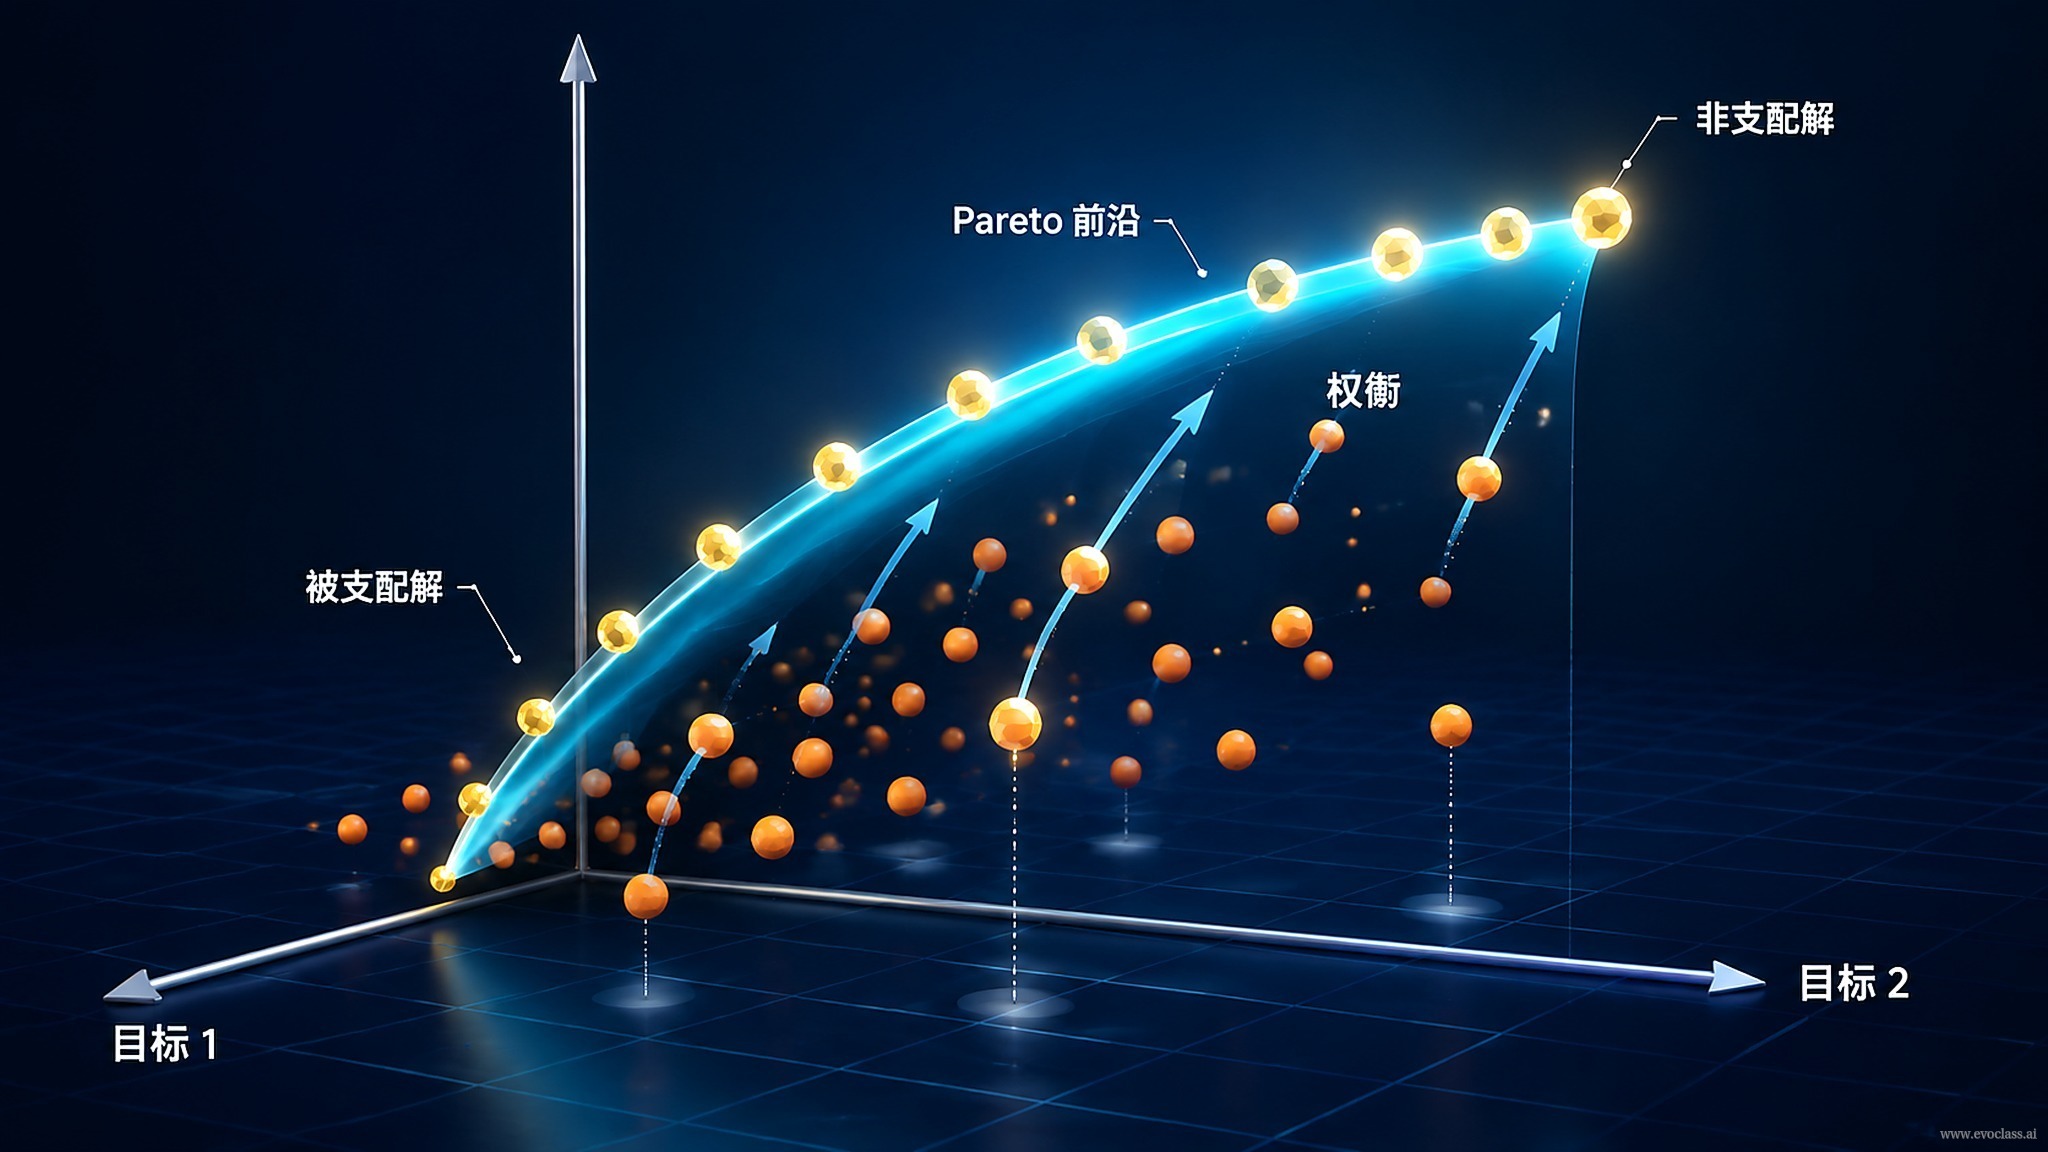
システムが探索の初期段階で孤立した「最適解」を提示してしまうと、意思決定の空間は狭められます。専門家は他の可能性を見られず、その点がどの二つの目標の間でどのようなトレードオフを行ったのかも判断できません。より適切な方法は、非支配関係に沿って候補案の集合を保持することです。それらは揚力、抵抗、安定性などの次元でそれぞれ重点が異なり、トレードオフ可能なPareto フロンティアを形成します。フロンティア上のどの点も一つの正当なトレードオフを表します——ある目標を改善するには、別の目標を犠牲にしなければなりません。したがってフロンティアの価値は「どれが最善か」にあるのではなく、便益とコストの完全な関係を提示し、その後の選好判断と意思決定を支えることにあります。
よくある誤解
多目的問題を事前に「重み付き和」で一つのスカラー目標にまとめてしまうことは、探索の前に専門家に代わって選好の重みを決めてしまうに等しく、トレードオフの情報が失われます。重みは意思決定段階の最後のステップであるべきであり、モデリング段階の最初の仮定であってはなりません。
Pareto フロンティアの探索この図は多目的問題を一本の Pareto フロンティアとして表しています:フロンティア上の各点は正当なトレードオフであり、揚力・抵抗・安定性のいずれかを改善すると、しばしば別の項目の悪化を代償とします。互いに非支配なこの候補群を保持することで、専門家に便益とコストを比較する基盤を提供し、探索前に重み付き和で早々に単一点に絞り込むことを避けられます。
Pareto フロンティアの探索
この図は多目的問題を一本の Pareto フロンティアとして表しています:フロンティア上の各点は正当なトレードオフであり、揚力・抵抗・安定性のいずれかを改善すると、しばしば別の項目の悪化を代償とします。互いに非支配なこの候補群を保持することで、専門家に便益とコストを比較する基盤を提供し、探索前に重み付き和で早々に単一点に絞り込むことを避けられます。